


导读让 AI 像人一样操作手机和电脑,长期面临“绝大多数软件没有 API、纯靠看图点击又慢又贵、长程任务频频翻车”的现实尴尬。通义千问团队推出的 Qwen-UI-Agent(MAI-UI)在 MobileWorld 与 OSWorld 等基准上刷新 SOTA。本文结合其开源代码与技术报告,深度拆解其背后的四大关键工程解法:100+ 台真机环境淬炼、GUI 与 CLI 混合动作空间、万级并发在线强化学习以及主动 Harness 架构,为开发者看清 GUI 智能体的真实落地路径提供参考。
为什么我们既离不开“屏幕”,又受够了“纯点屏幕”?
在智能体(Agent)的各类落地形态中,GUI Agent(图形界面智能体)始终承载着人们最直观的想象:只要给大模型连上一块屏幕,它就能像人类助手一样,帮我们打开手机点外卖、登录电脑填表格、跨软件整理报表。
但在这条看似美好的路径上,开发者们很快撞上了两堵厚重的工程高墙。
第一堵墙是现实软件生态的“无 API 困境”。
很多开发者最初会问:为什么非要让大模型吃力地看截图、找按钮,而不是直接调用软件后台的 API,或者通过系统的无障碍接口(Accessibility Tree / DOM 树)读取控件?
答案很残酷:在数字世界的真实生态里,超过 90% 的常用软件根本不会为第三方开放完整的读写 API。微信、大众点评、小红书、12306、钉钉以及企业内部各类定制化的老旧系统,全都不存在所谓开箱即用的自动化接口。更棘手的是,现代应用大量采用 Flutter、React Native、Unity、Qt 以及网页 Canvas 自绘引擎,在系统无障碍树里往往只是一整块空白的画布,底层标签与控件完全“失明”。图形用户界面(GUI)是人类数字世界里唯一全地形通用的公共交互入口。要想让 Agent 具备真正的通用执行能力,看懂屏幕是绕不开的基石。
然而,第二堵墙随之而来:“纯粹模拟人类点击”在工程上极其低效且昂贵。
如果把一切操作都押注在“截图 ➔ 视觉模型识别 ➔ 模拟点击 ➔ 再截图”的单一闭环上,系统会暴露出三个致命短板:
• Token 消耗滚雪球:一张 1080P 甚至 2K 的高清截图,经过视觉编码器切片后通常消耗 800 至 2000 个 Token。一个长达 30 步的操作链,如果在多轮对话中持续保留历史截图,上下文会迅速膨胀至数万甚至数十万 Token,推理成本呈指数级上升。
• 高延迟与操作缓慢:单步视觉推理、网络传输与界面渲染通常需要 1.5 到 4 秒。如果让 AI 在网页表格中连续填写 10 项数据,纯视觉点击需要反复截屏操作近一分钟,而一段脚本执行只需要 0.1 秒。
• 长轨迹误差累积:纯视觉交互极易受到弹窗、广告、轻微滑动漂移和偶发加载延迟的干扰。在超过 10 步的长程任务中,纯视觉 Agent 的执行成功率往往呈现断崖式下跌。
通义千问团队发布的 Qwen-UI-Agent(开源项目代号 MAI-UI),正是针对这些真实环境中的痛点给出的系统化工程答案。它不仅在移动端基准 MobileWorld(82.1%)、真机基准 MobileWorld-Real(92.2%)以及电脑端基准 OSWorld-Verified(79.5%)上全面对标乃至超越业界旗舰模型,更重要的是,它探索出了一条兼顾通用性、执行效率与长程稳定性的技术路线。
 图片说明:Qwen-UI-Agent 在移动端、电脑端及视觉定位等多项核心基准上的评测表现 图片来源:通义千问官方技术报告
底牌一:动作空间重构——GUI 看界面,CLI 干重活
Qwen-UI-Agent 在架构设计上最显著的突破,是打破了“单一视觉点击”的思维定势,重构了统一的 GUI + CLI 混合动作空间。
在传统的 GUI Agent 架构中,模型唯一的交互手段就是模拟鼠标键盘。但在真实电脑与手机环境中,很多任务并不需要机械地“一步一步在界面上找按钮”。
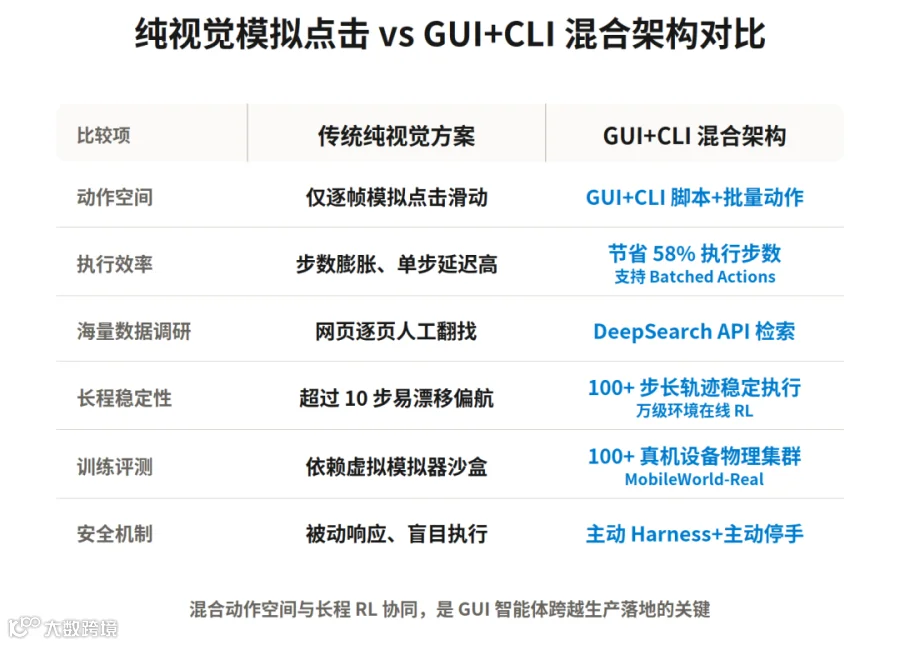
Qwen-UI-Agent 将这两种能力做成了原生互补:
• GUI 负责界面交互与视觉感知:定位未开放 API 的软件控件、跨应用跳转、识别复杂弹窗,以及在关键节点进行视觉结果校验。
• CLI(命令行)负责高效批量与确定性计算:在电脑端任务中,模型可以直接生成并执行 Bash 或 Python 脚本。例如下载批量文件、解析多页 PDF、处理结构化 Excel 数据或自动生成汇报文档。
• Batched Actions(批量操作):传统 Agent 每点击一次就要重新推理一次,而 Qwen-UI-Agent 支持在单次决策中同时输出一组连续动作(如依次激活输入框、填入内容并触发确认)。
在官方披露的电脑端评测数据中,CLI 动作占比接近一半,约 40% 的动作以 Batched Actions 形式输出。这一混合动作空间设计直接为任务执行节省了 58% 的执行步数。
除了本地 CLI,系统还引入了 GUI × DeepSearch 协同机制。当用户要求跨多平台调研信息或比价时,Agent 不再像人类一样在浏览器里逐页肉眼翻找,而是将检索需求转化为底层的结构化搜索 API 请求,直接拉取多来源数据并进行聚合清洗,最后再返回图形界面完成后续的报告生成与排版。
这种设计让模型既保留了“看懂任意屏幕”的通用兜底能力,又拥有了“直接调脚本干脏活”的工程执行效率。
底牌二:跨越模拟器鸿沟——100+ 台真机集群淬炼
在移动端 GUI Agent 领域,业界长期存在一个普遍现象:“模拟器里刷分惊艳,真实手机上一跑就崩”。
在标准的 Android 模拟器环境下,系统环境是高度理想化的——没有复杂的后台权限拦截、没有突如其来的各类通知弹窗、没有非标分辨率下的自绘布局错位,网络与渲染延迟也相对恒定。但当 Agent 部署到用户的真实手机上时,真实的 App 经常出现动态广告、滑块验证、权限授权浮窗以及复杂的跨 App 状态流转。
为了彻底打通这“最后一公里”,Qwen-UI-Agent 采取了扎实的真机工程策略:
• 搭建 100+ 台真实手机环境:搭建了由 100 多台实体手机、覆盖 150 多个真实商业应用的物理硬件集群,用于日常任务构建、真实操作轨迹采集与端到端评测。
• 建立 MobileWorld-Real 真机基准:自建包含 400 多个真实任务、100 多个复杂应用的评测基准,不再依赖人造的虚拟沙盒。
在真机训练中,模型学到了真实物理环境下的关键容错逻辑:如何处理网络慢加载时的加载动画、如何自主识别并关闭营销弹窗、以及如何在复杂应用切换中保持目标状态不丢失。这也是为什么 Qwen-UI-Agent 能在真机基准 MobileWorld-Real 上跑出 92.2% 成功率的核心底牌。
底牌三:万级并发在线 RL——攻克 100+ 步超长轨迹
长程任务执行(Long-horizon Execution)是区分“玩具级演示”与“生产级智能体”的关键分水岭。
传统 Agent 往往只能稳定处理 5 到 10 步以内的短平快任务。一旦任务复杂度上升至数十步甚至上百步,任何一步的状态误判都会像滚雪球一样在后续环节被放大,最终导致任务彻底偏航。
为了解决长轨迹漂移问题,Qwen-UI-Agent 引入了大规模在线强化学习(Online RL)训练体系:
• 万级环境并发 Rollout:系统支持在超过 100 步的超长轨迹上进行在线强化学习,调度约 10000 个并发环境同时探索与学习。
• 自适应课程学习(Curriculum Learning):从简单的单步 Grounding 与短链操作起步,逐步递进到跨软件、多阶段、带有错误自愈要求的长程复合任务。
在官方展示的一个长程调研案例中,Agent 连续执行了高达 170 步 的复杂工作流:
1. 数据定位与提取:通过 GUI 检索目标权威财报与文件,通过 CLI 快速抓取原始数据;
2. 自动化分析与建模:在后台运行 Python 脚本进行指标计算与交叉核验;
3. 多模态交付物生成:自动生成结构化的 Excel 工作簿、Word 摘要以及六页中文 PowerPoint 幻灯片;
4. 闭环视觉校验与版式修复:Agent 在生成 PPT 后,自主调用图形界面打开文档并截图,利用自身的视觉能力检查页面是否存在“文字溢出、图表遮挡、排版错位”等视觉缺陷,并在发现版式瑕疵后反向修改代码重新导出。
这种“代码生成 ➔ 视觉截屏检查 ➔ 发现排版缺陷 ➔ 自主反思修正”的闭环,展现了长程在线 RL 赋予智能体的真正工程韧性。
 图片说明:由 AI 驱动的闭环数据飞轮架构,涵盖任务设计、环境构建与错误自愈 图片来源:通义千问官方技术报告
底牌四:主动服务 Harness 与关键安全停手
一个真正能融入日常工作流的智能体,不仅需要“听话执行”,更需要懂得“何时主动”与“何时停手”。
1. 从被动响应到主动服务 Harness
以往的 Agent 必须等待用户输入明确的 Prompt 才能启动。而在 Qwen-UI-Agent 的系统设计中,集成了 主动服务 Harness 机制。
例如,当系统检测到用户的清晨航班因天气原因被取消、而当天下午又有重要会议日程时,Harness 会在用户尚未主动提问前启动:主动识别受影响的会议、检索备选的高铁与替换航班、计算通勤时间差,并直接为用户生成一套可供决策的改签方案。在用户确认后,Agent 还能无缝接力:在手机端完成订票,并在电脑端自动同步钉钉日程。
2. 严守安全边界:敏感操作主动停手
在赋予 Agent 越来越高的系统权限时,安全性是生产环境不可妥协的底线。
Qwen-UI-Agent 在全流程中内置了分级安全机制:
• 高危与违法请求直接拦截:面对违规或破坏性指令,模型在决策层直接拒绝,不产生任何界面与终端动作。
• 敏感不可逆操作主动停手(Human-in-the-Loop):在涉及在线支付、银行转账、数据永久删除、隐私通讯录授权等高危边界时,Agent 会在关键执行步骤主动挂起任务,向用户清晰说明当前操作内容与潜在影响,只有在获得用户的明确授权确认后才继续推进。
懂得在关键时刻“踩刹车”,是智能体从“技术探索”跨入“被用户放心托付”的必经之路。
豆包手机助手消费者版发布后:会点 App,不等于值得托付
开发者怎么用:开源生态、模型选型与落地考量
对于广大大模型开发者与架构师而言,最关心的莫过于这套能力如何集成到自己的业务系统中。目前,千问团队已经在 GitHub(Tongyi-MAI/MAI-UI)上开放了代码与模型生态。
在实际落地与选型时,有三个核心工程考量值得关注:
1. 极简的端到端运行链路
整套系统的后端核心依然是一个原生支持 GUI Grounding 与动作输出的多模态大模型(VLM)。开发者可以通过以下极简链路将其跑起来:
• 模型服务层:使用高性能推理框架 vLLM 或 SGLang 部署开源模型权重,暴露标准 OpenAI 兼容的 API 接口;
• 环境驱动层:在移动端,Agent 框架通过 ADB(Android Debug Bridge)与真实物理手机直连,利用 screencap 捕获屏幕、利用 input tap 发送触摸指令;在电脑端则对接沙箱终端与键鼠控制器;
• 高分辨率切片策略(Zoom-in):针对 2K/4K 电脑屏幕或高分辨率手机,框架内置了动态区域放大机制,确保密集小图标和长列表的坐标定位精度。
2. 模型尺寸梯度与端云协同
官方开源了涵盖端侧到云端的多种尺寸梯度(包括 2B、8B、32B 等):
• 端侧轻量模型(2B / 8B):适合部署在本地边缘设备、个人电脑或车机终端上,主要处理高频、简单的界面导航、单 App 操作与高响应度交互,同时最大程度保护个人隐私数据不离端;
• 云端大模型(32B 及以上):适合处理跨应用调研、长达数十步的多轮逻辑规划、代码生成与复杂报告排版纠错。
3. 后端模型能否自由替换?
从工程架构上看,GitHub 上的 Agent 调度框架是完全解耦的,理论上可以配置任何支持多模态输入的大模型接口。但在实际业务落地中需要注意:普通的通用多模态模型无法直接替代经过 GUI 特训的专用基座。
如果直接换用未经真机数据微调和强化学习的普通 VLM,系统在真实界面中极易出现“坐标点偏离几个像素导致点空”、“无法正确解析 GUI+CLI 批量指令格式”以及“超过 5 步就开始反复迷路”等问题。对于追求高可靠性的业务场景,优先采用原生具备 UI Grounding 能力的基座模型(或在其基础上进行垂类场景微调)是更稳妥的工程选择。
GUI 智能体的演进,正在经历从“纯视觉点击演示”到“混合动作与系统级工程”的深刻转变。Qwen-UI-Agent 的实践表明:未来的生产级 Agent 不会孤立地死磕某一种交互方式,而是以多模态视觉作为通达万物的通用底座,以代码、命令行与结构化 API 作为高效执行的坚实骨架。这一架构演进,也为广大开发者探索智能体真实落地提供了极具价值的参考样本。
参考资料
• 微信公众号文章《Qwen-UI-Agent:让模型真正“会用”每一块屏幕》: https://mp.weixin.qq.com/s/xjKcjN2W82eNcb0lSrP6yQ
• 官方技术报告《Qwen-UI-Agent: A Real-World Centric Foundation GUI Agent》: https://arxiv.org/abs/2607.28227
• 官方 GitHub 开源仓库 Tongyi-MAI/MAI-UI: https://github.com/Tongyi-MAI/MAI-UI
• Qwen-UI-Agent 项目主页: https://tongyi-mai.github.io/Qwen-UI-Agent
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!