

知识蒸馏与扩散模型的技术融合,正成为破解生成式模型推理开销高、端侧部署难痛点的核心方案,在图像生成、内容创作、多模态生成等主流任务中突破不断。
本文整理了10篇知识蒸馏与扩散模型结合的最新前沿论文,正在做相关课题的伙伴可以直接下方领取论文及代码(部分包含),搭基线、找改进点、扩实验方向都能直接用上。
长按识别下方二维码,回复【扩散蒸馏】
无偿领全部论文合集及项目代码
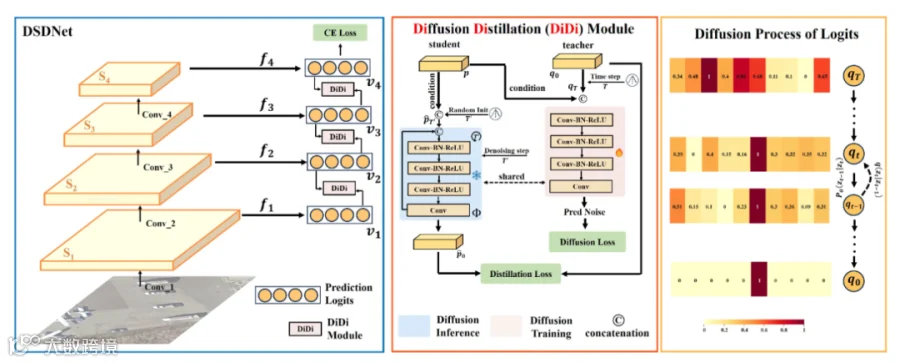
Diffusion Self-Distillation for Remote Sensing Scene Classification
面向遥感场景分类的扩散自蒸馏网络
文章内容
针对遥感图像浅层特征噪声干扰强、自蒸馏知识传递效果受限的问题,提出DSDNet扩散自蒸馏网络,将条件扩散去噪模型融入自蒸馏框架。设计扩散蒸馏模块,以深层教师特征为条件对浅层学生特征去噪,过滤干扰因素后实现精准知识迁移。该方法训练时引入辅助模块,推理时可完全移除,无额外参数量与计算开销。在四个遥感场景分类数据集上,多种骨干网络均获得显著性能提升,达到当前最优水平,且对噪声、低光照等图像扰动具备更强鲁棒性。
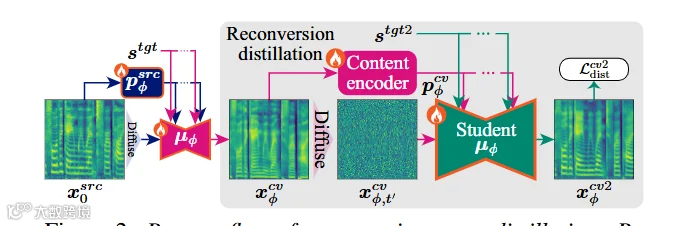
FasterVoiceGrad: Faster One-step Diffusion-Based Voice Conversion with Adversarial Diffusion Conversion Distillation
基于对抗扩散转换蒸馏的快速一步扩散语音转换
文章内容
针对扩散式语音转换迭代采样速度慢、内容编码器计算开销高的痛点,提出FasterVoiceGrad一步扩散语音转换模型。采用对抗扩散转换蒸馏策略,在转换流程中同时蒸馏反向扩散主模块与轻量卷积内容编码器,避免重构蒸馏易出现的恒等映射问题;搭配再转换分数蒸馏保障内容保留、逆分数蒸馏强化说话人特征。在单样本任意转换任务中,语音质量与说话人相似度与基线相当,GPU与CPU推理速度分别提升6.6倍和1.8倍。
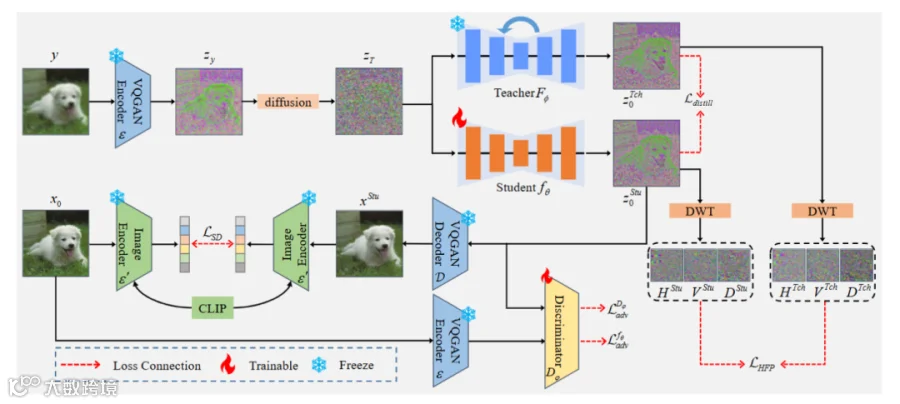
One-Step Diffusion-based Real-World Image Super-Resolution with Visual Perception Distillation
基于视觉感知蒸馏的一步扩散式真实世界图像超分辨率
文章内容
针对扩散超分辨率模型采样步骤多、单步蒸馏后图像语义一致性与感知质量不足的问题,提出VPD-SR视觉感知扩散蒸馏框架。引入CLIP显式语义监督,对齐生成图像与真值的语义空间以提升语义一致性;设计高频感知损失,基于离散小波变换约束高频细节恢复;结合patch级对抗训练增强生成真实感。仅需一步采样,在合成与真实世界超分辨率数据集上,CLIPIQA、MUSIQ等感知指标显著优于现有一步与多步基线方法。
↓↓听说在下方一键三连的都Accept了🌝


