

Tingli Qian、Weijin Wang、Shilong Gao 等人在 bioRxiv 发布论文 Complex enzyme active site scaffolding by iteratively detuned catalytic guidance,提出了一套面向复杂酶活性位点设计的新框架——CaGE(Catalytic Guidance Engine,催化引导引擎)。
这项工作主要由华盛顿大学蛋白质设计研究所 David Baker、Frank DiMaio 团队与约翰斯·霍普金斯大学 Xiongyi Huang 团队合作完成。
CaGE 主要解决一个具体问题:当活性位点同时包含多个催化残基、金属离子、辅因子和底物时,结构生成模型可以给出满足目标几何的设计,但后续得到的氨基酸序列未必能在无外部约束的结构预测中重新恢复这些关键几何关系。

作者因此采用“受约束结构预测—序列重设计—逐步降低约束强度”的循环策略。设计初期使用催化几何强约束提高目标位点的恢复精度,随后逐轮降低引导强度,最终在完全无引导条件下评价序列是否仍能恢复目标活性位点。
作者在 9 类不同酶活性位点 测试 中验证了这套方法,并进一步设计出:
CaGE 的核心:结构预测与序列设计循环,并逐步降低引导强度
作者首先扩展了 RosettaFold3(RF3),使其能够接收多种与分子设计相关的条件,包括:
其中,原子对距离约束对复杂酶活性位点尤其重要,因为它可以直接描述催化侧链、金属、辅因子和底物之间的局部几何关系。

在结构预测阶段,CaGE 使用 classifier-free guidance(CFG)控制不同设计条件的影响强度;随后使用 LigandMPNN 根据预测结构重新设计序列。
论文中的典型四轮循环将引导强度依次从 1.0、0.5、0.3 降到 0。最后一轮不再提供外部几何引导,用于检验经过多轮优化后的序列能否独立支持目标活性位点。
作者还开发了一个不需要重新训练模型的基序引导方法。该方法在扩散采样过程中直接校正指定基序原子的位置,使其逐步接近参考几何,并可与 CFG 联合使用。
tips:CFG,分类器自由引导,一种通过比较有条件和无条件预测来调节约束强度的方法
结果一 9 类酶基准中,CaGE 提高了无引导预测的活性位点恢复率
作者选择了 9 类不同的酶活性位点进行测试,包括嘌呤核苷磷酸化酶、鸟氨酸脱羧酶、4-氯苯甲酰辅酶 A 脱卤酶、烯酰辅酶 A 水合酶和柠檬酸合酶等。
最终评价使用无引导 RF3和独立 AlphaFold3,同时考察催化基序和配体位置。

作者设置了两档联合筛选标准:

在更严格的 1.25 Å 标准下,原始 RFdiffusion3 + LigandMPNN 流程在几个困难体系中没有得到通过设计,而 CaGE 的通过率分别达到:

按每 1000 次结构预测计算,CaGE 在五个主要测试体系中也均提高了合格设计的产出效率。例如,
在 1.5 Å 标准下,五个体系的通过率相对于基线分别提高约 1396.5、181.6、72.8、22.9 和 37.7 倍。
这些结果说明,CaGE 的改进可以保留到最终的无引导结构预测中,而不是只存在于受约束预测阶段。
结果二 一轮 CaGE 将非血红素铁体系的严格通过率从 0.27% 提高到 4.70%
作者随后测试了一个同时包含金属配位和反应态几何约束的非血红素铁体系。
该活性位点包括单核铁中心、第一配位层残基,以及一个跨越反应基团的过渡态配体,因此需要同时恢复金属配位结构和反应基团之间的相对位置。
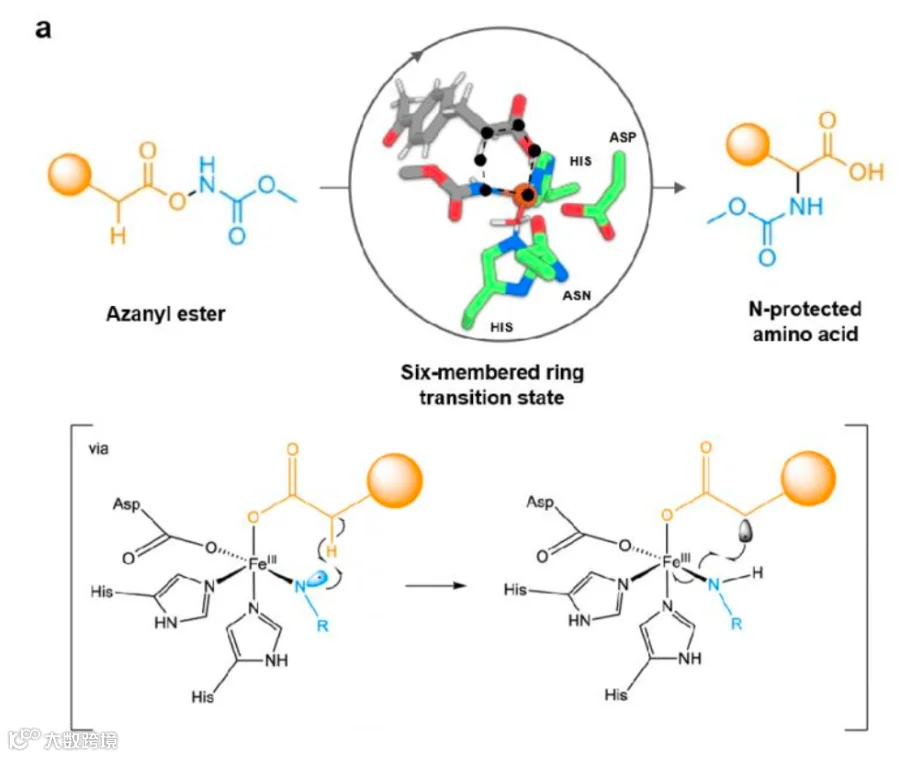
作者从同一批 1500 个 RFdiffusion3–LigandMPNN 骨架出发,对比未经 CaGE 优化和经过一轮 CaGE 优化的序列。

在独立 AlphaFold3 预测中:
随后作者进行四轮 CaGE 优化。最终无引导 AlphaFold3 筛选得到 160 个满足折叠和完整催化基序要求的设计,其中 71 个进入实验筛选,6 个产生高于无酶对照的产物信号。
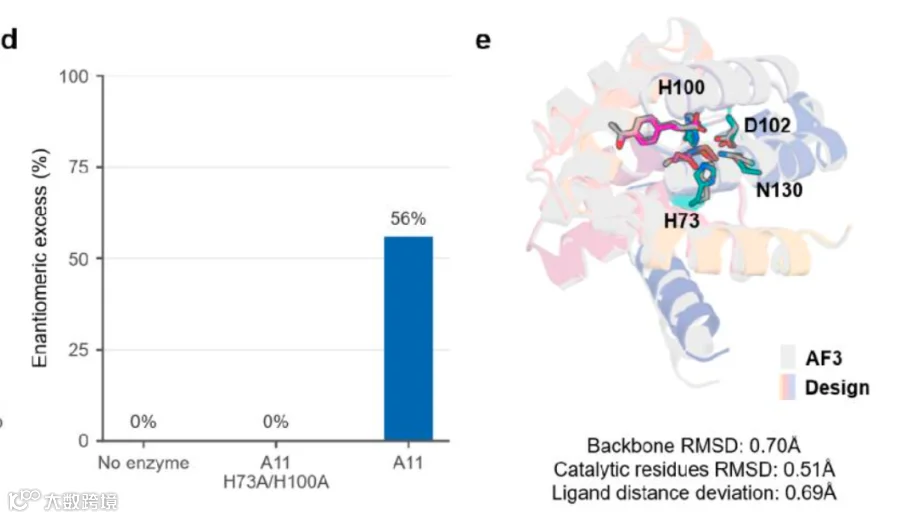
其中表现最好的设计为 A11。A11 是一个 175 aa、以 α 螺旋为主的从头设计蛋白。His73、His100 和 Asp102 构成 2-His-1-carboxylate 铁配位三联体,Tyr78 和 Asn130参与底物相关基团的定位。
A11 反应产物的对映体过量为 56%;无酶对照和 H73A/H100A 变体均得到外消旋产物。这一结果支持设计活性位点对反应立体选择性的贡献。
tips:有意思的是,这个motif好像不是从天然的酶来的,最早提出的是一篇 2022 年 Nature Chemistry 报道的这种反应,并且明确进行了 DFT 所计算出了一个几何位置,也就是说这可能是真正意义上的一个从头设计的酶。
结果三 PLP 依赖逆醛缩酶
第二个实验体系是一个PLP 依赖的逆醛缩反应。
PLP 依赖催化不仅要求辅因子结合,还需要同时满足共价连接、电子环境和底物定位等多种几何条件。
作者围绕 PLP—底物复合物指定了 4 个关键残基:Asp27、His31、Lys142 和 Arg159。
tips:第二个就是一个常规从天然的截取motif的路线了。
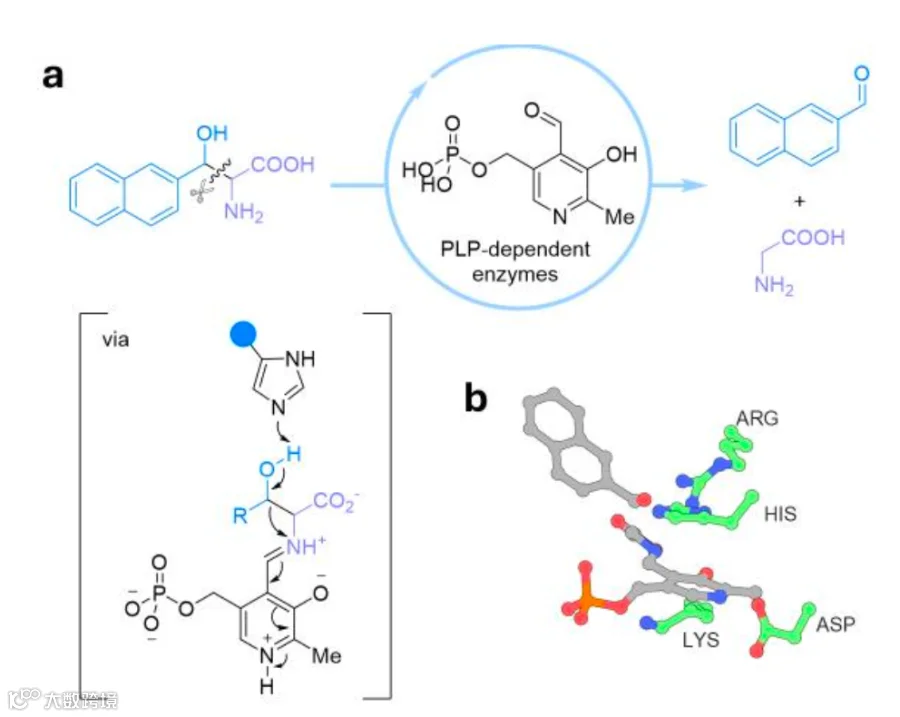
其中:
在进入 CaGE 之前,作者通过 RFdiffusion3、LigandMPNN 和 FastRelax–LigandMPNN 优化得到 30,293 条序列,但在最终 AlphaFold3 几何标准下没有一条通过。
tips:原图本来就是截图很糊
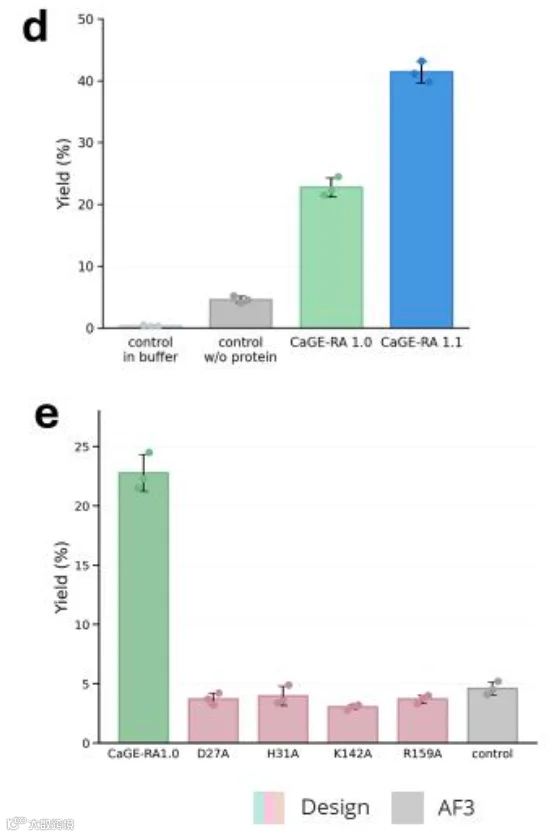
经过 CaGE 优化后:
作者进一步以 CaGE-RA1.0 为结构模板,在保留催化基序的前提下进行第二轮 CaGE 优化,得到 CaGE-RA1.1。

在相同反应条件下:
这说明 CaGE 不仅可用于初始设计筛选,也可以在获得实验活性命中后继续进行定向的序列—结构优化。
tips:文章的整体motif定义的都极少,几乎只是个位数的这几个残基,所以文章更强调的是能够设计出来能work的酶,应该是性能上还无法打过天然的,但我还是想知道和天然的差距有多大。
结果四 突变、光谱、质谱和晶体结构支持预设的 PLP 催化架构
为了验证 CaGE-RA1.0 的活性是否依赖设计的催化残基,作者分别将 D27、H31、K142 和 R159突变为丙氨酸。
四个突变体的产物形成均下降到接近无蛋白背景,说明这些设计残基对催化活性是必要的。
随后,作者通过紫外—可见吸收光谱和 NaBH₄ 还原捕获实验检测 PLP 与蛋白的结合状态。
完整蛋白质谱中,CaGE-RA1.0 的主要 apo 峰为 21,504 Da;加入 PLP 并进行还原捕获后出现 21,735 Da 的新峰,增加 231 Da,与单个 PLP 形成还原后共价加合物的质量变化一致。

最后,作者解析了 apo CaGE-RA1.0 的 2.7 Å 晶体结构。实验结构与设计模型的主链 RMSD 为 0.702 Å,并保持预期的单体结构。
这些结果分别从功能突变、辅因子化学状态和实验结构三个层面支持了设计模型中的关键催化架构。
总结
这项研究提出了 CaGE,通过“结构预测—序列重设计”的迭代过程,并逐步降低催化几何引导强度,提高复杂活性位点由最终序列独立恢复的概率。
在 9 类酶基准中,CaGE 提高了催化基序和配体在无引导 RF3、AlphaFold3 预测中的恢复率和单位计算量产出效率。
在实验验证中,作者获得了一个具有 56% 对映体过量的非血红素铁设计;在 PLP 体系中,原始 30,293 条序列均未通过最终 AlphaFold3 几何筛选,经过 CaGE 优化后得到实验活性设计 CaGE-RA1.0,并进一步优化得到 CaGE-RA1.1,使产物产率从 22.8% 提高到 41.4%。
CaGE-RA1.0 的四个设计催化残基突变后活性降至接近背景;光谱和质谱支持预设的 PLP–Lys 共价结合;2.7 Å apo 晶体结构与设计模型的主链 RMSD 为 0.702 Å。
这项工作的主要进展,是把复杂酶设计中的优化目标进一步从“生成满足催化几何的结构”推进到“获得能够在无外部约束下稳定支持这些催化几何的序列”。
tips:这篇文章比deep mind的那篇要有意思一些,特别是第一个案例,确实非常接近从头设计酶这个概念了,如果有合适的场景,完全可以通过DFT计算反应几何位置,理性设计motif,再加上这套系统去尝试设计一个真正意义上的从头设计的酶去解决一个实际的问题,还是让人很感兴趣的。