


近年来,生成式推荐通过将商品编码为离散语义 ID,把推荐重构为序列生成任务,在摆脱大规模 Item Embedding 依赖、提升系统可扩展性方面展现出重要潜力。模型以用户历史行为为条件,自回归地生成目标商品对应的 SID 序列,绕开传统双塔检索的结构限制,并允许语义相近的商品共享 token,从而支持更细粒度的偏好建模。
然而,现有 GR 模型大多采用单次解码(one-pass decoding):从左到右一次性生成 SID,中途不做任何显式修正。一旦靠前的 token 落入错误的语义分支,后续 token 只能在该错误分支内继续延展,误差沿自回归链条不断累积,并最终留在检索结果中。近期工作尝试引入推理机制来缓解,形成了"先推理再生成"(reason-then-generate)与"边推理边生成"(reason-while-generating)两类范式。但二者的推理都发生在完整草稿产生之前——模型始终没有机会将一份完整的生成结果作为整体来审视,因而无法诊断"错在哪、错在哪个语义层面",也就谈不上针对性修正。
针对上述问题,我们提出 GRC(Generation–Reflection–Correction)。据我们所知,这是首个让 GR 模型对完整草稿进行事后诊断与修正的工作。GRC 将单次解码改造为 SID 空间中"生成—反思—纠错"的三段式过程:先生成一版完整草稿,再基于结构化反思标签定位错误与语义偏差,最后条件于草稿与反思结论重新生成最终序列。围绕这一范式,我们给出三项设计:(1)结构化反思-纠错模板,通过监督微调(SFT)在单条轨迹内联合学习生成、反思与纠错;(2)基于 GRPO 的强化学习,在扩大后的轨迹空间中直接优化自我纠错策略;(3)熵引导的反思调度(EGRS),在固定 beam 预算下把纠错算力优先分配给高不确定性轨迹。
在公开数据集和大规模工业级数据集上的实验结果表明,GRC在所有指标上均取得最优效果。我们进一步进行了在线A/B实验,结果表明,能带来明显的广告收入和GMV提升。得益于 EGRS 的调度,线上推理时延仅有小幅增加,在效果与部署可行性之间取得了良好平衡。
1. 背景
与传统判别式检索不同,生成式推荐将检索建模为序列生成问题。形式化地,记用户集合为 、商品集合为 。对每个用户 ,其历史交互序列为 。每个商品 经 RQ-VAE 编码为长度为 的语义 token 序列 ,其中 是第 层码本中的离散 token。借助确定性查找函数 ,任意生成序列 都对应一个商品 。给定目标商品 及其 token 序列,模型通过最小化负对数似然进行训练:
其中 为模型参数。我们采用编码器-解码器 Transformer 作为 GR 骨干:编码器将 压缩为用户表示 ,解码器在其条件下自回归建模。
推理时从 BOS 出发、以 beam size B 做 beam search。这一标准范式存在两个固有局限:其一,teacher forcing 只在真实前缀下训练,模型从未学习如何检测或修正自身预测中的偏差,推理时误差会不断累积;其二,多层语义 token 下,早期错误会改变后续条件分布,进一步加剧了误差累积问题。为缓解误差累积问题,近期工作把推理引入解码过程:一种范式是先推理再生成,先精修中间表示再一次性生成 SID;另一种范式是边推理边生成,在生成 SID 的同时穿插推理、动态调整下一步解码。两类范式都提升了生成质量,但推理始终发生在完整草稿之前,模型无法把已完成的草稿作为整体审视,也就无法进行全局的诊断与修正。
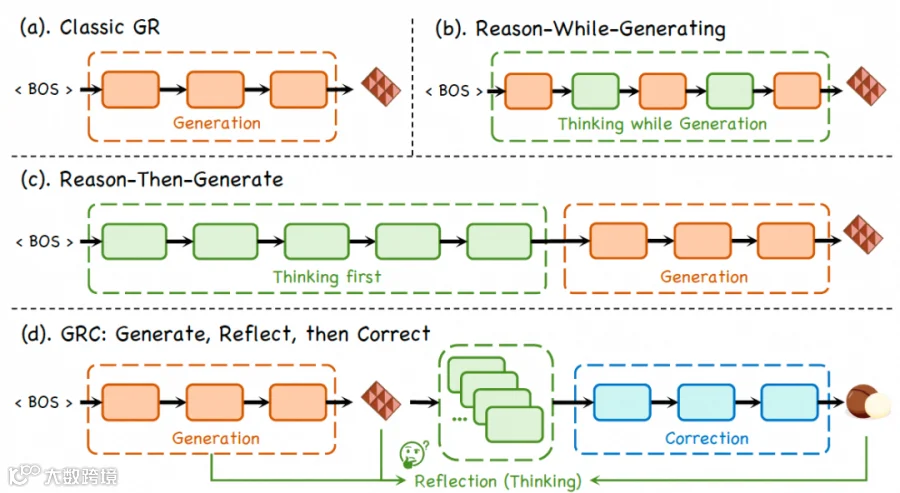 为此,我们主张显式的“生成—反思—纠错”。 让 GR 先产出一版完整草稿,再对其整体反思、并据此纠错,把推理从服务于生成转为审视完整结果——这一思路与大模型的自我反思相通。但要将结构化的反思与纠错真正落到离散的 SID 序列上,还需先克服三个挑战:
- (C1) 缺乏显式的轨迹纠错机制。
现有 GR(含上述两类推理范式)都没有在草稿完成后诊断并修正错误的能力;推理一旦只发生在生成前或生成中,全序列产生后便无从纠正。 - (C2) 与自由形式的自然语言反思不匹配。
自由形式的自然语言反思难以对齐离散 SID、无法指导 token 级编辑,其不定长生成还会带来不可控时延,不适合大规模实时推荐。 - (C3) 反思-纠错空间被显著放大。
引入显式反思与纠错后,可能的解码行为大幅增加,少量监督轨迹不足以覆盖,也难以学出稳健的自我纠错策略,需要强化学习进一步探索。
2. GRC:面向完整草稿的生成—反思—纠错范式
为应对上述挑战,我们提出 GRC,把一次性解码替换为 SID 空间中的三段式过程,并在同一条轨迹内完成。GRC 整体包含三个部分:结构化反思-纠错模板,将反思形式化为对 token 位置的离散决策而非自由文本,通过 SFT 联合监督生成、反思、纠错;GRPO 强化学习,在完整轨迹上以序列级奖励直接优化自我纠错策略;熵引导反思调度,与 beam search 集成,按不确定性把固定的纠错预算分配给低置信 beam。

2.1 结构化反思-纠错模板
GR 骨干在真实前缀下以 teacher forcing 训练,因此既不知道解码在何处偏离目标,也没有修正初始生成的机制。我们的做法是用一组定长、结构化的反思标签替代自由形式的自然语言反思,使低开销的纠错能够直接映射为检索动作。
具体地,SFT 阶段我们用预训练骨干为每个样本 beam search 出若干候选 ,并为其标注两类标签。token 级错误定位标签记录候选与目标首次不一致的位置:
(3)
其中 表示序列完全正确。语义级一致性标签从真实属性视角判断生成商品与目标是否一致:设 、 ,对属性 (如类目、品牌), 将商品映射到取值分桶,则
(4)
该维度可自由扩展——新增属性只需补上对应的判定函数 。随后,我们把初始草稿、反思标签、纠错结果三段拼成一条监督序列(三段以特殊 token 分隔):

其中 控制附加监督的权重。如此,模型在单条轨迹内就同时学会了生成、反思与纠错。
2.2 GRPO 强化学习:探索扩大后的纠错空间
SFT 由离线构造的标签驱动,既无法为整条"生成—反思—纠错"轨迹的成败提供端到端信号,也不鼓励模型探索模板之外的纠错策略。为此,我们把整条轨迹 视为一个 RL episode,用 GRPO 直接优化其中的反思-纠错策略。
奖励设计的核心思路是把"生成质量"与"纠错行为"解耦:
(7)
任务奖励 以 token 级命中数衡量最终序列的检索质量(并对纠错后的序列施以更高权重),把优化过程牢牢锚定在"预测下一个商品"这一原始目标上;纠错奖励 则围绕"诊断得准、改得对"来塑造行为——鼓励模型准确定位首个错误位置、正确判断类目/品牌等语义是否一致,并且只有当纠错后的序列确实优于草稿时,才给予正向激励。最后一点尤为关键:它促使模型拿出实打实的改进,而不是仅仅"发现错误"却改不回来。训练时以 SFT 权重初始化,并按用户分组计算组内相对优势进行更新。
2.3 熵引导的反思调度
线上以 beam search 部署时,对每条 beam 都执行完整的反思-纠错在计算上不可行。我们观察到:反思阶段天然为每条候选给出不确定性信号,且 beam 之间差异显著——置信的路径纠错收益有限,不确定的路径更可能从纠错中获益。据此,我们用反思 token 的平均熵 度量每条路径的不确定性,并在标准 beam score 上叠加一个熵校准项:
(8)
剪枝时改用 , 控制校准强度。如此,在固定 beam 预算下,高不确定路径更易存活、获得更多纠错机会,而反思已判定"正确"的草稿则直接跳过重生成。该机制不改变 beam search 接口,便于在实际时延约束下调参。
3. 实验
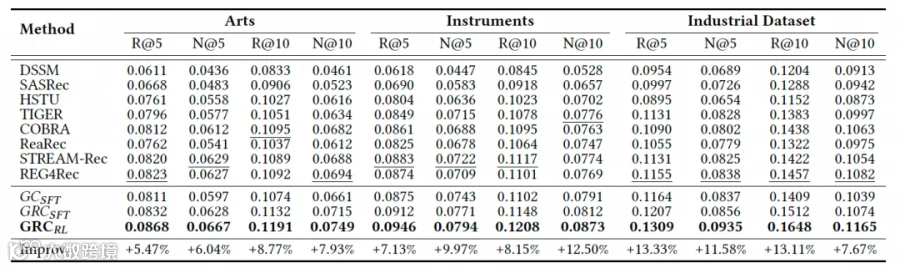
在公开数据集和大规模工业级数据集上的实验结果表明,GRC在所有指标上均取得最优效果。我们进一步进行了在线A/B实验,结果表明,能带来明显的广告收入和GMV提升。得益于 EGRS 的调度,线上推理时延仅有小幅增加,在效果与部署可行性之间取得了良好平衡。
4.关于我们
我们是阿里国际-智能技术-Lazada推荐广告算法团队,我们致力于融合前沿深度学习、生成式推荐、用户超长序列建模、多场景建模、大模型算法等技术构建工业级推荐大模型,通过更深刻地洞察用户个性化偏好与决策逻辑持续助力商家投放效益与平台收益的快速增长。近年来,我们在前沿算法领域持续深耕,已经在WWW、SIGIR、ICDE、CIKM、WSDM等顶级学术会议发表了多篇高质量论文。也欢迎感兴趣的同学加入我们,共同开创AI推荐的新篇章。
点击上方名片,关注我们吧~