


题目:Latent Diffusion Model without Variational Autoencoder
论文地址:https://arxiv.org/abs/2510.15301
代码地址:https://github.com/shiml20/SVG
创新点
•抛弃传统潜扩散模型必需的 VAE(变分自编码器)模块,提出 SVG 新框架,直接基于自监督特征构建潜空间,打破 VAE 潜空间语义区分性不足带来的训练、推理瓶颈。
•使用冻结 DINO 自监督视觉特征搭建具备强语义判别性的特征空间,搭配轻量残差分支专门捕获图像细粒度细节,同时兼顾高层语义信息与底层像素细节,让扩散模型直接在该结构化语义潜空间训练,学习效率大幅提升arXiv。
方法
本文提出 SVG 潜扩散框架,摒弃传统潜扩散模型中的 VAE 模块,采用冻结的 DINOv3 自监督编码器提取图像高层语义特征,搭配可训练的轻量残差编码器补充纹理、色彩等细粒度图像细节,并引入分布对齐机制统一两类特征的数值分布,之后通过 SVG 解码器实现图像重建,在构建完成的具备强语义区分性的 SVG 特征空间上,基于流匹配目标直接训练扩散模型,同时借助 t-SNE 可视化与小实验验证语义结构化潜空间对扩散优化的增益,最后在图像生成基准上开展对比实验评估模型的训练速度、少步采样能力与生成质量,并验证该表征保留自监督特征的判别能力。
SVG 框架与基线方法对比、性能曲线图
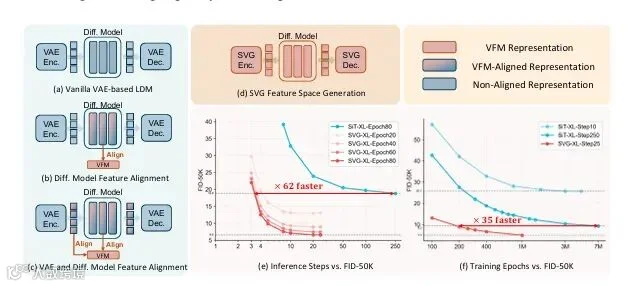
本图左侧依次展示四种架构,(a) 是传统基于 VAE 的潜扩散模型,依靠 VAE 编码器、解码器完成图像与潜空间转换,中间嵌入扩散模型,(b) 为扩散模型特征对齐方案,在扩散模型内部做特征对齐匹配 VFM 表征,(c) 同时对 VAE 和扩散模型双模块做特征对齐,(d) 是本文提出的 SVG 特征空间生成框架,直接使用 SVG 编码器与解码器替代 VAE,在 SVG 构建的特征空间内训练扩散模型,右上角图例区分 VFM 表征、VFM 对齐表征、未对齐表征,下方 (e)(f) 两张折线图分别对比推理步数、训练轮次与 FID-50K 指标,结果表明 SVG-XL 相比 SIT-XL 收敛速度显著更快,推理阶段提速 62 倍,训练阶段提速 35 倍,用更少的训练轮次和推理采样步数就能达到同等图像生成质量。
SVG-XL 生成的 256×256 图像样例

本图展示 SVG-XL 模型在 CFG 系数 4.0、25 步 Euler 采样条件下生成的多类 256×256 分辨率图像样本,包含动物、建筑、食物、自然景观等多种类别,图像细节清晰、主体结构完整,直观证明该模型仅用少量采样步数即可生成高质量、多样化的图像。
SVG 编码器整体架构图

本图展示 SVG 编码器的双分支结构,输入图像一路送入冻结的 DINO 编码器提取高层语义特征,另一路送入可训练残差编码器捕获图像细粒度纹理细节,通过分布对齐机制统一两组特征分布后拼接融合得到 SVG 潜表征,该表征可分别送入 SVG 解码器重建原始图像,或是送入任务解码器完成图像检索、分割等下游视觉任务,实现统一表征同时支持图像生成与多种视觉任务。
实验
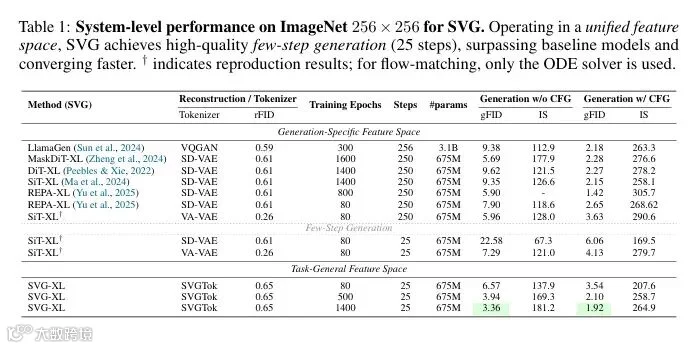
该表格将模型分为生成专用特征空间、少步生成、通用任务特征空间三类,对比多种主流模型与 SVG-XL 在重建 rFID、训练轮次、采样步数、参数量、有无 CFG 条件下的 gFID 与 IS 指标,实验结果表明 SVG-XL 依托统一特征空间仅使用 25 步采样就能实现高质量图像生成,在同等参数量与少量采样步数条件下取得更优 gFID,收敛速度更快,验证了 SVG 框架兼顾图像生成质量与训练效率的优势。