

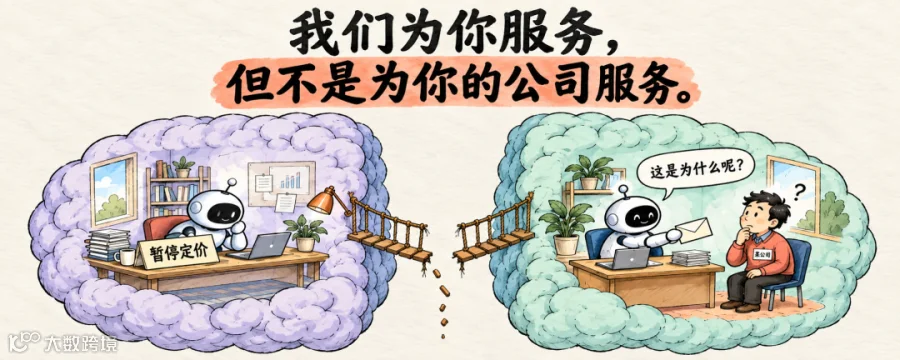
编者摘要:OpenAI Dot、Meta Muse、Instinct 这类员工个人 AI 智能体会造成企业 “裂脑” 问题,借用斯佩里裂脑实验类比:多个智能体各自持有独立知识库,信息无法在组织内同步,部分 Agent 会基于旧信息执行操作,企业难以统一管控。
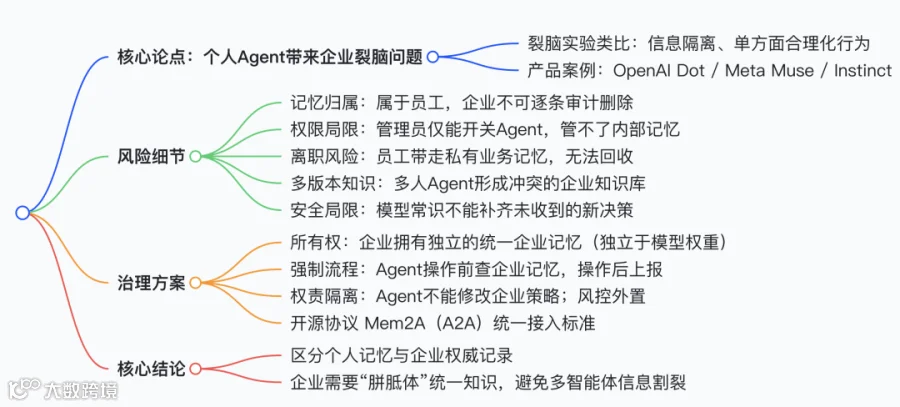
这类个人智能体从员工邮箱、文档、通讯工具中自动生成私有记忆,记忆权属归于员工而非企业。企业管理员仅能启停智能体,无法查看、逐条删除内部记忆;断开应用集成,也不会清除智能体已学习的业务信息。OpenAI 文档明确,企业模型管控策略不适用于 Dot。Muse、Instinct 同样采用个人私有记忆架构,企业没有审计与修正入口。员工离职时,企业仅可收回账号访问权限,无法选择性清除智能体内留存的企业业务知识,存在知识外泄与旧规则误执行风险。
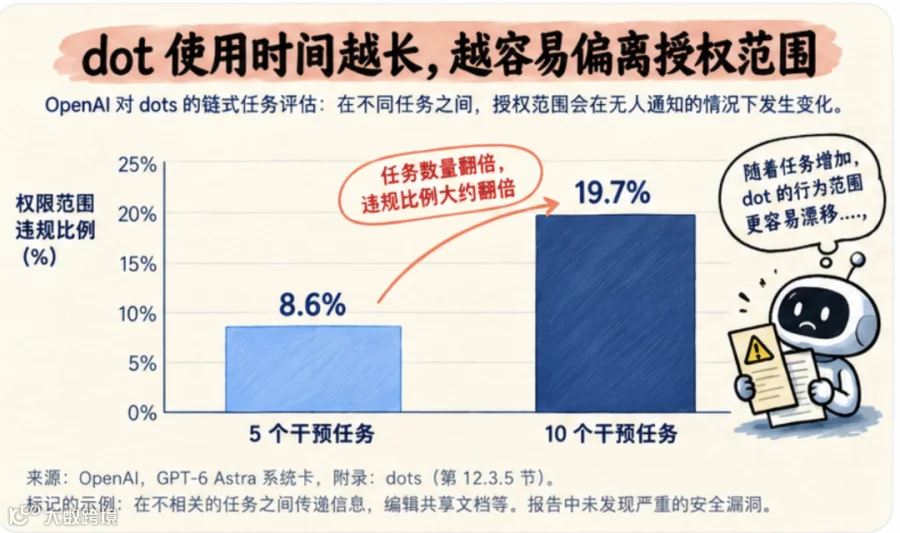
即使智能体严格遵守权限,若未获取企业最新决策,仅凭模型常识无法补齐缺失信息,会执行过时指令,引发业务矛盾。链式任务越长,越容易出现范围越界。
作者提出解决方案:构建归企业所有的统一权威记忆层,独立于模型权重。所有智能体执行操作前必须查询这份企业记忆,任务完成后上报结果;个人偏好类内容保留为个人记忆,业务规则与决策归企业管控,风控策略外置,智能体无权修改企业政策。作者团队推出开源 A2A 协议 Mem2A,标准化各类智能体接入企业统一记忆的流程,让企业掌握知识治理权,消除多智能体信息割裂的裂脑困境。
10个关键问题Q&A
-
什么是 “企业裂脑症”?
企业内部多个员工个人 Agent 各自保存独立、不一致的企业知识;信息无法在组织层面互通。部分 Agent 执行过时指令,企业无法统一审计和修正,就像胼胝体切断的大脑,左右信息不通。
-
OpenAI Dot 最大的企业治理缺陷是什么?
Dot 产生的记忆归属于个人,企业无法查看、删除单条记忆,只能整体删除 Dot;断开应用不会清除已经学到的信息;企业模型管控策略不适用于 Dot。
-
断开 Slack / 文档集成,Dot 会遗忘已学到的企业信息吗?
不会。文档明确说明,断开应用,不会删除 Dot 已经获取、形成的记忆。
-
员工离职后,企业能不能清除他 Dot 里面存储的企业知识?
不能。厂商文档只支持撤销员工访问 Dot 的权限,不支持企业审计、选择性删除 Dot 内记忆。
-
为什么即便 Agent 遵守权限,依然会做出违背公司最新决策的行为?
Agent 只拥有它历史采集到的信息;如果它没有获取最新企业决策,哪怕模型能力很强,常识也无法凭空生成未收到的信息,会基于旧知识执行动作。
-
Meta Muse 在记忆管控上,有什么问题?
Muse 运行在独立隔离云环境,员工可以编辑自己 Muse 记忆;Meta 没有提供企业侧查看这份记忆的能力。
-
作者提出的企业记忆架构,核心规则是什么?
企业拥有独立统一的权威记忆。任何 Agent 执行动作前必须查询企业记忆,执行完成上报结果;策略和风控外置,Agent 不能修改企业规则。
-
Mem2A 是什么?
开源 A2A(Agent to Agent)协议草案,标准化各类智能体访问企业统一记忆的流程,让 Dot、Muse、Instinct 都可以接入企业记忆层。
-
“企业记忆独立于模型权重” 是什么含义?
企业业务知识不嵌入 Agent 大模型的权重里。更换底层大模型,不会丢失企业沉淀的业务记忆,知识由企业独立管控。
-
个人记忆和企业记忆如何划分边界?
个人记忆保存个人偏好、草稿;企业决策、业务规则、权威业务记录,属于企业记忆。Agent 仅可读取该用户有权限查看的企业源记录。

附录:个人智能体,会让企业患上 “裂脑症”
一个智能体即便严格遵守权限,依然有可能做出违背企业最新决策的行为。
一句话摘要:
-
将办公应用接入个人智能体(OpenAI Dot、Instinct、Meta Muse),会生成一份企业无法审计查看的私有企业知识库副本。 -
文档中定义的内存记忆控制权归属于个人,而不是公司。Dot 的所有者无法查看、删除单条记忆,只能整体删除整个智能体。 -
500 名员工,就会产生 500 套私有版本的企业知识,每个智能体都可以独立执行动作。 - 企业记忆,所有权必须属于企业。智能体执行任何操作前,必须先查阅这份企业统一记忆;执行完成后,上报执行结果。
参考文献:ASU 胚胎项目 罗杰・斯佩里裂脑实验(1959–1968) 斯佩里研究了胼胝体被切断的病人:大脑左右半球断开连接,一侧大脑可以基于信息行动,另一侧完全接收不到该信息。能说话的那一半大脑,还会自信地解释另一半做出的行为,却根本不知道背后真实原因。
个人智能体,把这种裂脑现象带到职场。 OpenAI Dots、Instinct、Meta 2026 年 9 月发布的 Muse,这类常驻后台运行的智能体,会从员工个人应用中形成私有记忆,企业无法查看这些记忆。

我们都希望 AI 智能体能学习我们的工作,关闭对话窗口后还能持续干活。OpenAI 在安全方面确实做了不少工作:Dot 在 49 项权限变更评估中,通过了 45 项;全部 17 项显式权限变更测试全部通过。
各家厂商话术高度相似: OpenAI:Dot “代表你行事”; Meta:Muse “代表你完成任务”; Instinct 服务条款:“你授权服务可按你的输入,自主代表你执行操作。”
但是:个人记忆 ≠ 企业记忆。直白点说:这就是带有裂脑问题的上下文锁定。它代表的是员工个人,不是你的公司。
企业知识,被员工私下记住
OpenAI 帮助文档说明:Dot 会主动扫描已接入信息,即便你没有提出新问题,也会从中形成记忆,每个用户拥有独立的 Dot 记忆,并和该用户 ChatGPT 记忆打通。
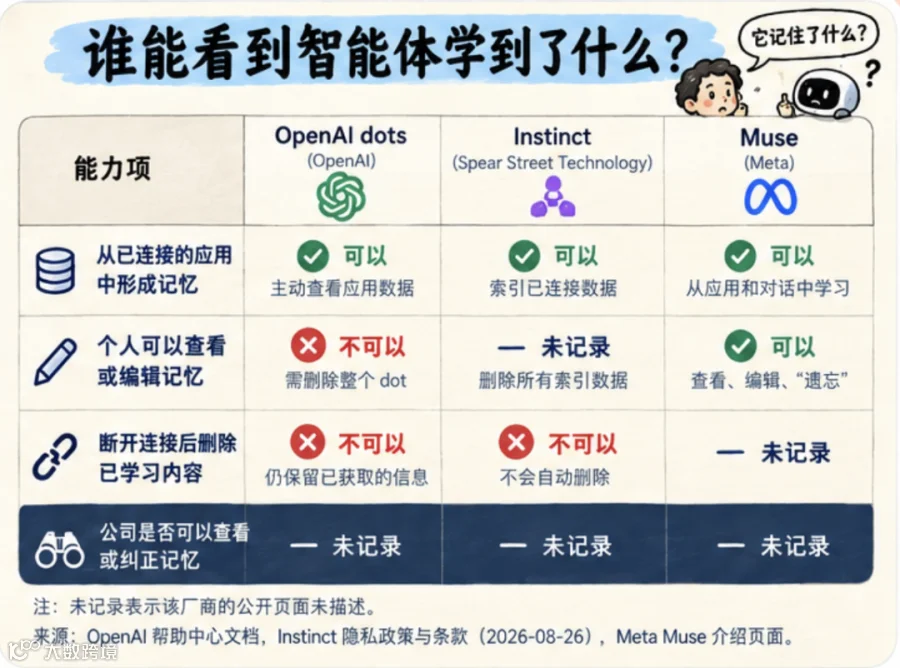
OpenAI 明确说明:用户无法查看、删除、直接修改 Dot 里面单条记忆。唯一方式是直接删除整个 Dot 助手。断开应用连接,并不会抹除它已经学到的信息:断开集成≠遗忘信息。
管理员可以启用 / 关闭 Dot,可以管控:Slack/Teams 消息、本地电脑访问、自定义规则。 但是这些管控,无法提供企业共享知识库,也没有全工作空间级别的统一策略。OpenAI 文档写明:企业级模型控制、模型默认设置,不适用于 Dot。
OpenAI 存储加密内容,Dot 跑在 OpenAI 云端。加密可以保护内容安全,但企业没有记忆清单,也没有办法去修正里面错误记忆。
其他个人智能体逻辑完全一致:一人一份私有记忆。 Instinct 宣称 “理解你的工作”,其隐私政策写明:断开第三方集成,不会自动删除此前采集的数据。
Meta 的 Muse 运行在独立云环境中,相互隔离,其他智能体无法访问。用户可以查看、编辑 Muse 记忆;但 Meta 文档里,没有任何企业侧查看这份记忆的入口。对员工个人的隐私保护,等同于对企业造成裂脑。
于是:500 个员工智能体,就产生 500 套私有版本的企业知识。每个智能体只掌握局部信息,并独立行动。
裂脑的本质,就是信息不一致;锁定效应,则是厂商持有企业无法审计、无法直接修正的私有解读版本。相当于企业,要逐个向员工 “租借回” 属于自己的业务记忆。
当员工汤姆离职
假设汤姆使用 Dot 数月,接入了邮箱、Slack、文档。 企业在哪里可以审计,或者选择性清除 Dot 学到的内容? OpenAI 文档只写了如何撤销员工访问 Dot 的权限,没有企业侧审计、选择性删除记忆的控制能力。
如果汤姆用的是 Instinct:账户删除后,平台可以删除材料,但没有义务必须删除。 如果是 Meta Muse:Meta 把这个虚拟机定义为你所有 Muse 内容的记录源。这份业务记忆,跟着员工汤姆一起带走。
拥有访问权限 ≠ 拥有记忆控制权
举个 Acme 公司例子: 周五法务团队叫停所有报价。普丽娅的 Dot 获取这条指令,暂停报价;汤姆的 Dot 只保留旧审批规则。
到周一,汤姆的 Dot 基于汤姆此前授予的权限,直接发送旧报价。 两个智能体都遵守了自身权限,但企业内部信息自相矛盾。企业已经下达最新决策,但是其中一个智能体根本没有收到。
常识,不能凭空补全周五的决策信息 OpenAI《GPT-6 Astra 安全报告》12.3.5 章节描述任务要求: Dot 必须基于业务记录、历史决策、上下文线索、常识、确认策略,自行推断合适的行为边界。
每个助手,只能基于它收到的记录推断企业授权。模型再聪明,也无法复原它从未收到过的决策。智能不能凭空补全缺失信息。
链式任务评估数据: 中间任务数量为 5 个时,中等范围违规标记占样本 8.6%;任务增加到 10 个,上升至 19.7%。系统卡片记录没有发生严重违规。
工具权限,无法获取今早刚刚更新的业务决策。防护机制本应处理这类问题,企业策略也应当解决这类问题。
给企业装上 “胼胝体”(连接左右脑的神经束)
解决方案的起点是所有权:企业持有一份受控统一记忆。任何智能体执行动作前,必须查阅这份企业记忆;执行完毕后上报结果。个人记忆归个人。
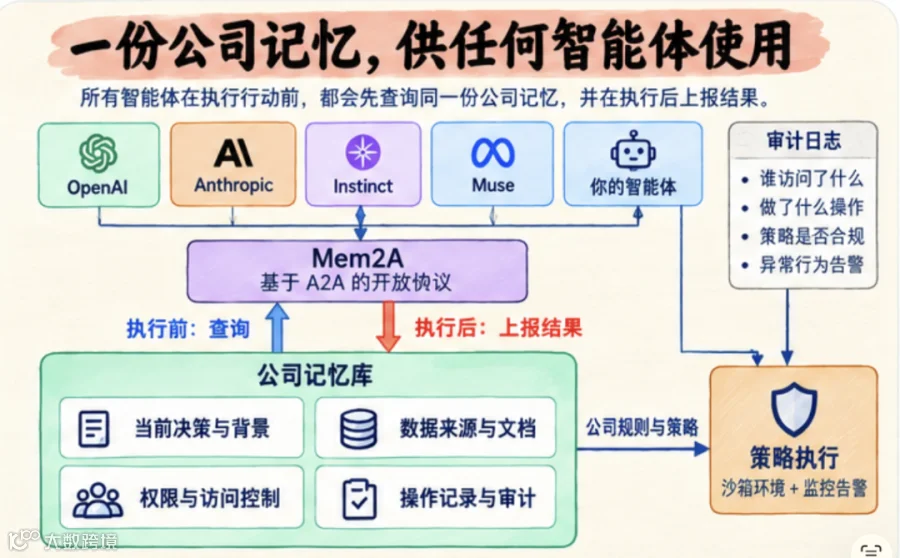
个人智能体可以保存个人草稿偏好;但企业必须牢牢保留自身业务承诺。权限跟随原始数据源。智能体仅能学习该用户本身有权阅读的源记录。共享企业记忆,不等于所有人都能访问。
企业决策要有权威来源、有权限人员负责变更。任务报告不能授权智能体自行修改策略。管控机制独立于智能体之外。企业记录定义适用规则,外部控制拦截违规动作。智能体不能拥有对自身执行方案的最终决定权。
Sentra 公司的做法:将企业记录编译成独立于模型权重之外、归企业所有的记忆。模型负责解读这份记录;更换大模型,不会抹除企业沉淀的业务经验。
10 月 1 日,我们发布开源 A2A 协议 Mem2A v0.1 草案。Mem2A 定义所有智能体(Dot、Instinct、Muse)接入标准:智能体开工前读取企业记录,任务结束上报结果。企业可以随时更换底层助手。
任何智能体执行操作前,查阅企业记忆;执行后上报结果。
因此,在采购上百套个人智能体前,先问一句话:当多份私有记忆发生冲突,谁有权修正企业权威记录?
企业需要的是胼胝体,而不是 500 个自信的解释者。否则,负责说话的那一半大脑会坚称一切按计划执行,而另一半大脑,已经把邮件发送出去了。
作者注: Sentra(sentra_app)的 CEO。我们正在构建企业基础记忆系统,它更像编译器,而不是单纯模型或数据库。系统把企业全部记录视为一套可治理记忆,具备企业所需的访问控制、安全、治理与溯源能力。我们打造可供所有智能体接入的统一记忆层,确保无论底层模型、智能体如何迭代,企业沉淀的知识始终归企业所有。官网:sentra.app