


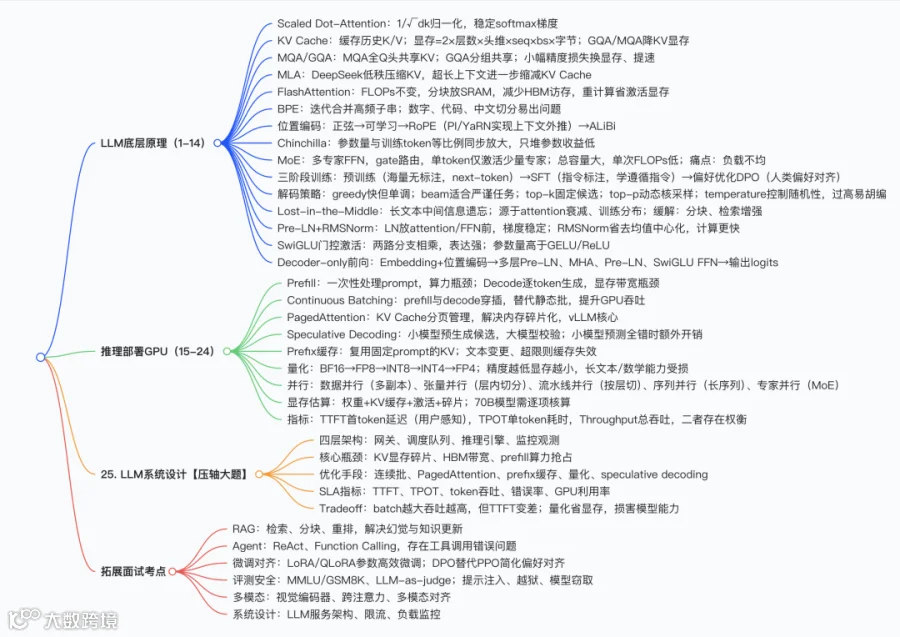
编者摘要:AI 工程师大厂 LLM 面试必考25题核心考点分为底层原理、推理部署、拓展三大模块。 底层核心是 Decoder-only Transformer。缩放点积注意力用\(1/\sqrt{d_k}\)做归一化,防止点积过大造成 softmax 梯度消失。KV Cache 缓存历史 K、V 向量,避免重复计算,显存由层数、头维、序列长度、批大小决定;MQA、GQA 通过 Q 头分组共享 KV,牺牲少量模型质量降低 KV 显存;DeepSeek MLA 进一步低秩压缩 KV,适配超长上下文。FlashAttention 不减少 FLOPs,依靠分块加载到高速 SRAM,降低 HBM 访存开销。位置编码从正弦、可学习编码演进到 RoPE,依靠 PI/YaRN 实现上下文外推,ALiBi 直接增加距离偏置。Chinchilla 定律指出参数量与训练 token 应同步扩容,只堆参数收益有限。MoE 包含多个专家 FFN,路由仅激活少量专家,实现总容量提升而单次 FLOPs 不变,但存在负载不均衡风险。预训练学习基础语言知识,SFT 学习指令遵循,DPO 等偏好优化对齐人类偏好。解码策略中 top-p 是当前主流;长上下文存在 Lost-in-the-Middle 中间信息丢失问题;现代模型普遍采用 Pre-LN+RMSNorm 与 SwiGLU 门控激活。
推理部署区分 Prefill 与 Decode,Prefill 算力密集,Decode 受显存带宽限制。Continuous Batching 动态混合请求,PagedAttention 分页管理 KV Cache,解决显存碎片,是 vLLM 核心。Speculative Decoding 依靠小模型预生成候选加速,小模型预测失效时反而增加开销。Prefix 缓存复用固定提示 KV,文本改动会失效。量化从 BF16 到 FP4 逐级压缩显存,代价是数学、长上下文能力衰减。并行策略包含数据、张量、流水线、序列、专家并行,大模型常混合使用。显存计算需要逐项统计权重、KV 缓存、激活值与内存碎片。TTFT 代表首 token 延迟,TPOT 是单 token 耗时,吞吐量与首 token 延迟存在权衡。
拓展模块覆盖 RAG 检索增强、Agent 工具调用、LoRA/QLoRA 微调、DPO 对齐、模型评测、安全防护、多模态以及 LLM 系统架构设计,面试常用来做综合追问。
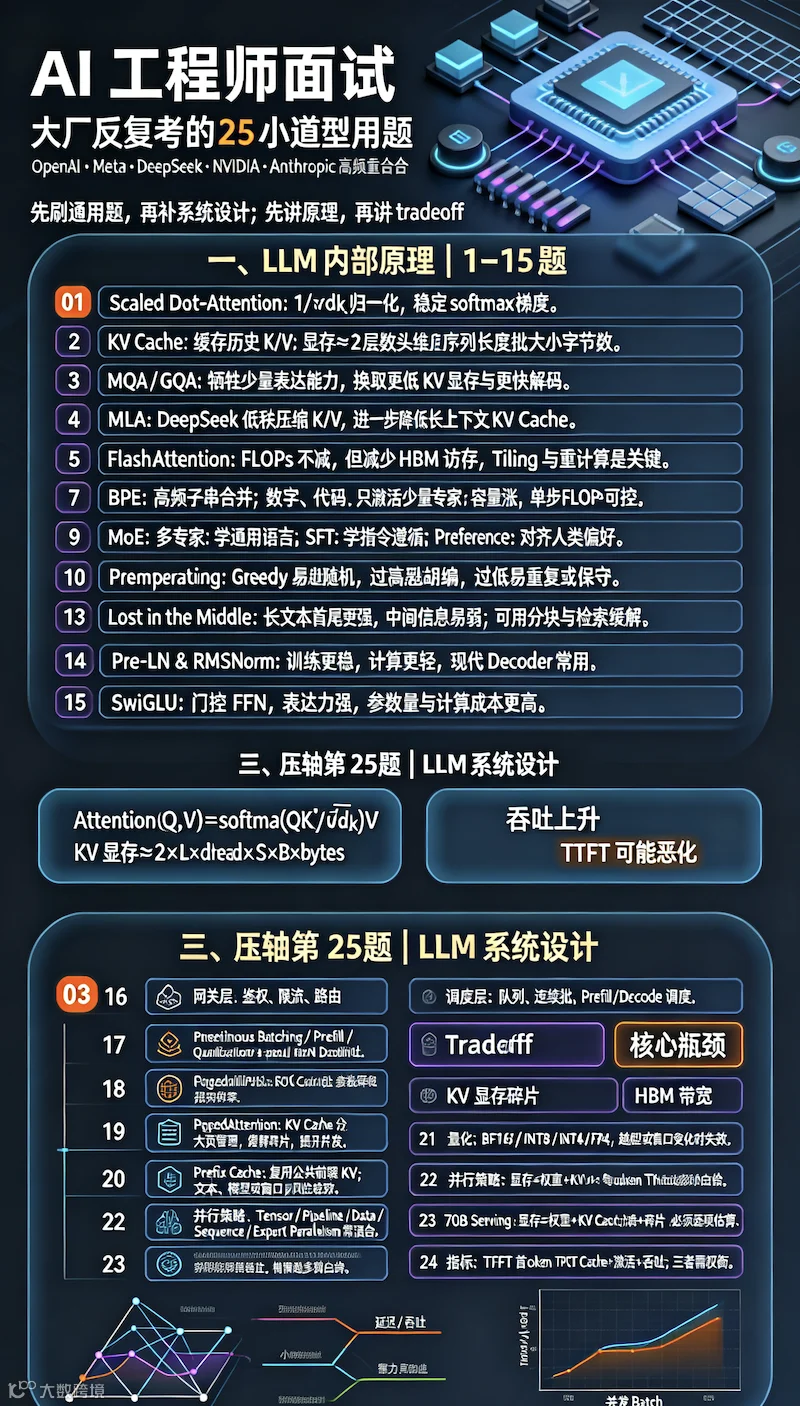
附录:AI 工程师大厂面试 25 道通用题(精简答案版)
适配 LLM 底层原理 + 推理部署,是 OpenAI/Meta/DeepSeek/NVIDIA 等高频考点,适合面试口述,重点抓原理 + tradeoff。
一、LLM 内部原理
1. Scaled Dot-Product Attention:\(1/\sqrt{d_k}\)缩放因子作用
公式:\(\text{Attention}(Q,K,V)=\text{softmax}(\frac{QK^T}{\sqrt{d_k}})V\)
-
点积随\(d_k\)增大而变大,softmax 输入数值会趋向极端,梯度极小、训练不稳定。 -
\(\sqrt{d_k}\)做归一化,把 QK 点积的方差拉回≈1,保证 softmax 分布不会极度尖锐,稳定梯度。
2. KV Cache:定义、显存计算
- 是什么
Decoder 自回归生成时,把历史 token 算好的 K、V 向量缓存下来,新 token 只计算新的 Q,不再重复计算前面所有 token 的 K/V,大幅减少计算。 -
显存计算公式:
\(\text{KV显存}=2\times \text{层数} \times \text{头维度} \times \text{序列长度} \times \text{批大小} \times \text{数据类型字节数}\)
×2 是 K 和 V 两份;注意:GQA/MQA 会减少 K/V 头数量,显存会下降。
-
痛点:长上下文 + 大 batch 下 KV Cache 是显存大头,极易碎片化。
3. MQA / GQA:是什么,取舍
- MQA(Multi-Query Attention)
所有头共享同一组 K、V,Q 头独立。 ✅优点:KV Cache 显存大幅降低,decode 更快;❌代价:表达能力略降,模型质量轻微损失。 - GQA(Grouped-Query Attention)
:把 Q 头分组,每组共享一组 K/V,介于 MHA 和 MQA 之间。 ✅权衡:可控的质量损失,显著减少 KV 显存,现在主流大模型(Llama2、Mistral)基本用 GQA。
4. MLA(Multi-Head Latent Attention,DeepSeek)
把 K、V 做低秩压缩,先投影到隐空间,再做 attention。 核心目的:进一步压缩 KV Cache 体积,超长上下文场景下,KV 显存开销大幅降低,同时尽量保留 attention 表达能力,是 DeepSeek 长上下文模型的核心改进。
5. FlashAttention:FLOPs 没变,为什么更快
FLOPs 是总计算量,但是 GPU 瓶颈很多时候不是计算,而是HBM 显存读写带宽。
-
FlashAttention 采用分块(tiling),把 Q/K/V 切小块,放到高速 SRAM 上计算,减少 HBM 反复读写。 -
重计算代替完整保存 activations,以少量额外计算换取巨大的显存 IO 节省。
本质:减少显存访存,而不是减少数学运算次数。
6. BPE 原理 + 缺陷
-
原理:Byte Pair Encoding,从字符 /byte 开始,统计高频连续子串,迭代合并,构建词表。优先合并出现频率最高的 pair。 -
翻车点: -
数字:长数字会被切得很碎; -
代码:标识符容易不合理切分; -
非拉丁文字(中文):单字粒度、字间没有天然分隔,分词片段不稳定,词表利用率低。
7. 位置编码演进:Sinusoidal → Learned → RoPE → ALiBi
-
Sinusoidal:固定三角函数位置编码,泛化到更长序列,但表达有限; -
Learned:可学习位置 embedding,训练固定长度,外推差; -
RoPE(旋转位置编码):对 Q、K 做复数旋转,相对位置信息;配合Position Interpolation / YaRN:通过缩放旋转角度,在不大量微调的情况下扩展上下文窗口; -
ALiBi:不编码位置,直接给 attention score 加随距离衰减的偏置,天然支持外推。
8. Chinchilla Scaling Laws
核心结论:模型参数量和训练 token 应该同步等比例放大。 之前的直觉(固定 token,无脑堆参数)是错的。Chinchilla:模型大小 ×4,训练数据也要 ×4,才能最优。单纯做大模型、数据不够,收益很低。
9. MoE(Mixture of Experts)
-
架构:一层内有多个 Expert(FFN),Gate 路由,每个 token 只激活少量专家。 -
“容量涨,FLOPs 不涨”:总参数量是所有专家之和(容量变大);但每次前向只激活少量专家,单次推理 FLOPs 只和少量专家相关。 -
痛点:负载不均衡、路由崩溃、通信开销大。
10. Pre-training / SFT / Preference Optimization 区别
-
Pretraining:预训练,原始海量无标注文本,学习语言、知识、世界模型;目标:next token 预测。 -
SFT(监督微调):高质量标注问答 / 指令数据,教会模型遵循指令;固定目标 next token loss。 -
Preference Optimization(如 DPO/IPO):偏好数据(好回答 vs 坏回答),对齐人类偏好,不再依赖人工打分 Reward Model。
11. 解码策略:greedy /beam search /top-k/top-p /temperature
-
Greedy:每一步选概率最大 token,快,容易重复、单调。 -
Beam search:保留 top-k 候选序列,适合需要严谨、确定性输出(翻译);长生成容易呆板,大模型生成少用。 -
Top-k:只从概率最高 k 个 token 采样;k 固定,长尾分布会出问题。 -
Top-p(nucleus):累积概率≥p 的最小集合,动态候选集,现在最常用。 -
Temperature:对 logits 缩放,T→0 趋近 greedy;T 越大越随机。 -
翻车场景:T 过高胡编;top-p 太小缺乏多样性,太大容易采样低质量 token。
12. Lost-in-the-Middle(中间信息丢失)
长上下文时,模型更容易记住开头和结尾,中间段落信息召回差。 成因:attention 衰减、位置编码衰减、训练数据分布(很多文档开头结尾信息密度更高)。 缓解:窗口分块、位置编码改进、重新构造训练数据、检索增强。
13. Pre-LN vs Post-LN,RMSNorm
-
Post-LN:原始 Transformer,LN 放在残差相加之后;深层训练不稳定,需要精细初始化。 -
Pre-LN:LN 放在子层(attention/ffn)之前,残差通路干净,梯度更稳定,现在 decoder-only 大模型标配。 -
RMSNorm:简化 LayerNorm,去掉均值中心化,只做方差缩放;计算更快,数值效果接近 LN,LLama 系列使用。
14. SwiGLU:Gated Activation
\(\text{SwiGLU}(x) = (\text{swish}(W_1 x) \odot W_2 x)W_3\) Gated 结构,把输入分成两路,一路激活、一路线性,逐元素相乘。相比 ReLU/GELU,表达能力更强;代价是 FFN 参数量上升。Meta LLaMA 系列标配。
15. 终极大题:手推 Decoder-only Transformer forward
输入 token → token embedding + 位置编码 → 循环 N 层 Decoder Block:
-
Pre-LN -
MultiHeadAttention:QKV 投影 → scaled dot-product attention → dropout + 残差连接 -
Pre-LN -
SwiGLU FFN → dropout + 残差连接 最后一层 LN → Linear 输出 logits → softmax 得到 token 概率。 自回归:每一步输出一个 token,追加到输入,循环解码。
二、推理、部署与 GPU 性能
16. Prefill vs Decode
-
Prefill:一次性处理整个 prompt,并行计算所有 prompt token;算力密集,算力利用率高。 -
Decode:逐一生成输出 token,每轮只新增 1 个 token;显存带宽瓶颈,KV Cache 读写是主要开销。
17. Continuous Batching(In-flight batching)
Static batching:等一批请求全部 prefill 完成,统一一起解码;空闲资源浪费。 Continuous batching:请求的 prefill 和 decode 可以穿插,只要 GPU 有空,随时把新请求塞进来。提升 GPU 吞吐量,现在主流推理引擎(vLLM)核心。
18. PagedAttention(vLLM 核心)
KV Cache 碎片化问题:不同请求序列长度不一样,申请连续显存块会产生大量空洞,显存浪费。 PagedAttention:把 KV cache 拆成固定大小的页(page),不需要连续内存,类似操作系统虚拟内存。解决碎片化,大幅提高显存利用率,支持更大并发。
19. Speculative Decoding(推测解码)
用小模型快速预生成一串候选 token,交给大模型并行校验;大模型一次性接受多个 token,确认正确的直接输出。 ✅速度提升,质量不变;❌失效场景:小模型猜的全错,大模型全部拒绝,反而额外开销,白给。
20. Prompt / Prefix Caching
-
把固定不变的系统 prompt、长前缀的 KV 预先缓存。新用户请求只要复用这个前缀 KV,不用重复 prefill。 -
缓存失效:前缀文本变化、上下文窗口超限、模型版本变更。适合大量共享相同系统提示的场景(客服)。
21. 量化鄙视链 FP16/BF16 → FP8 → INT8 → INT4 → FP4
每降低精度:显存占用减半,推理速度提升;代价:
-
BF16/FP16:原生训练精度; -
FP8:介于浮点和整数,保留指数,现代新 GPU 原生支持; -
INT8:整数量化,对激活 / 权重做缩放,一般损失很小; -
INT4:权重 4bit,显存大幅压缩;会损失模型能力,尤其数学、长上下文; -
FP4:低精度浮点,部分场景比 INT4 更稳定,但硬件支持更少。
22. 并行策略全家桶
-
Data Parallel:多卡复制完整模型,不同数据样本,训练用; -
Tensor Parallel:单一层张量切分到多卡,跨卡通信,大模型推理; -
Pipeline Parallel:模型按层切分,流水线执行,掩盖通信延迟; -
Sequence Parallel:长序列,把序列维度切分,减少激活显存; -
Expert Parallel:MoE 场景,专家分散到不同 GPU。
大模型通常多种并行混合。
23. 70B 模型显存计算题
显存 = 模型权重 + KV Cache + Activations + 碎片开销
-
权重:70B × 精度字节。如 BF16:70B×2 = 140GB;INT4:70B×0.5=35GB。 -
KV Cache:使用前面 KV 公式,和 batch、上下文长度强相关。 -
Activations:训练时大;推理 decode 阶段激活很小,prefill 阶段激活高。 -
Fragmentation:额外预留 10~20% 碎片。
24. 延迟指标:TTFT / TPOT / ITL / Throughput
-
TTFT(Time To First Token):首 token 延迟,用户感知最敏感,聊天产品核心指标;prefill 决定 TTFT。 -
TPOT(Time Per Output Token):每生成一个新 token 耗时,代表解码速度。 -
ITL(Inter-Token Latency):token 之间间隔,和 TPOT 近似。 -
Throughput:每秒生成 token 数,系统吞吐量,面向资源利用率。 Tradeoff:调高 batch 提升 throughput,但 TTFT 会变差。
第 25 题(原题清单里预留的终极大综合题:LLM 系统设计题,大厂 AI 工程师面试压轴大题)
题目:设计一个支持多用户在线对话的大模型推理服务,简述整体架构、核心瓶颈、优化手段与 SLA 指标。
参考
问题:设计一个支持多用户在线对话的大模型推理服务,简述整体架构、核心瓶颈、优化手段与 SLA 指标。答:整体架构分为四层:接入网关层、调度层、推理引擎层、存储 & 观测层。
- 接入网关层
负责鉴权、限流、请求路由、负载均衡,过滤非法提示词,防止突发流量打垮后端。 - 调度层
请求队列管理,实现 in-flight continuous batching,区分 prefill/decode 请求,做资源调度。 - 推理引擎层
核心使用 vLLM 这类引擎,依赖 PagedAttention 管理 KV Cache,支持 prefix prompt 缓存;可开启 speculative decoding 加速;根据模型大小选择张量 / 流水线混合并行;采用量化降低显存占用。 - 存储 & 观测层
日志、请求 trace、监控指标,采集 TTFT、TPOT、吞吐、GPU 利用率,做告警。
核心瓶颈:
-
短 prompt、长生成场景:decode 阶段 HBM 显存带宽瓶颈,KV Cache 内存碎片; -
大量并发长上下文请求:显存资源最先耗尽; -
大量长 prompt 涌入:prefill 算力抢占,TTFT 恶化。
优化手段:
-
调度:continuous batching 提升 GPU 利用率; -
显存:PagedAttention、prefix 缓存、GQA/MLA、权重量化; -
加速:speculative decoding、FlashAttention; -
弹性:多实例集群,按负载自动扩缩容。
SLA 指标:
-
TTFT(首 token 延迟,聊天核心);TPOT;token 吞吐量;错误率;GPU 利用率;上下文长度上限。 安全上增加提示注入检测、输入输出内容审核。
风险与 tradeoff:调高 batch 提升吞吐,但 TTFT 会变差;量化降低显存,损失模型推理能力;speculative decoding 在难题场景收益消失,带来额外计算开销。
三、剩余模块考点(简要提纲)
- RAG & Retrieval
召回策略、向量库、chunk 切分、重排、幻觉、召回失败问题; - Agents & Tool Use
Function calling、ReAct、工具调用错误、规划、状态管理; - Fine-Tuning & Alignment
LoRA/QLoRA、参数高效微调、DPO vs PPO、数据污染; - Evaluation
基准评测 MMLU、GSM8K;人工评估、LLM as judge、评估集污染; - Safety & Security
越狱、数据泄露、提示注入、后门、模型提取; - Multimodal
CLIP、vision encoder、cross-attention、投影层、多模态对齐; - AI System Design
端到端 LLM 服务架构,限流、缓存、负载均衡、可观测; - Coding & DS
基础算法、GPU / 内存、并发,C++/CUDA 加分。