

智猩猩AI整理
编辑:林夕
最近,一个基于Qwen基座训练的27B模型JEMM开源。
官方对它的定位很直接:“Like Jev, but multimodal and open-weight.”
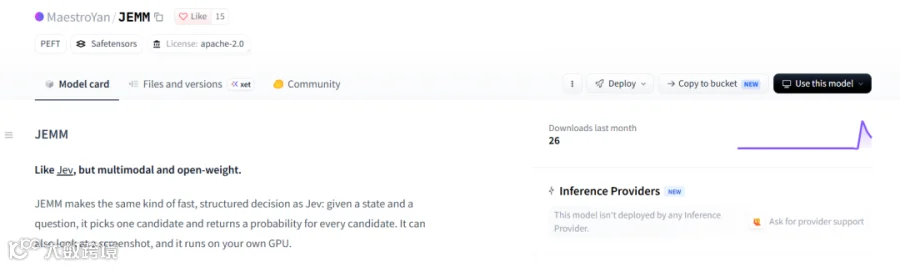
和Jev一样,JEMM主要负责Agent执行过程中的快速决策:面对多个工具、动作或者候选方案,直接进行选择、判断和评分。
不同的是,JEMM进一步加入了图片输入。
对于网页Agent来说,当前页面截图可以和任务指令一起交给模型,由它判断下一步应该执行什么操作。
按照项目方公布的测试结果,JEMM的工具调用准确率达到93.3%,截图网页任务达到54.6%;在JevBench公开的231道题中答对198题,准确率达到85.7%。
速度方面,5种文字请求配置的延迟也全部低于Jev,单题中位数约为0.3秒。
这一次,Jev式决策思路被放进了一个Qwen基座、27B规模、开放权重的多模态模型里。
01
把思考变成一个更快的决策环节
现在的Agent,很多时候并不缺一个会推理的大模型。
真正拖慢执行速度的,反而可能是那些高频、重复的决策。
比如一个浏览器Agent正在执行任务,当前有几个候选动作:点击按钮、打开链接、输入文字或者返回上一页。
如果每一步都让一个大模型重新理解任务、生成完整回答,再从回答里解析出下一步动作,推理成本和延迟都会不断累积。
Jev走的就是另一条路线。
它更像Agent里的一个“快速决策器”。
候选动作已经准备好以后,模型不用重新规划整个任务,只需要回答一个更简单的问题:
哪个动作更合适?
也可以进一步做条件判断、候选排序或者直接给不同方案打分。
这样一来,大模型负责复杂任务的规划,而决策模型负责大量高频的小判断。
JEMM就是沿着这条路线做的。
不过,它没有停留在纯文本决策上。
Jev主要处理文字信息,JEMM则进一步加入了视觉输入。

对于浏览器Agent来说,当前页面截图本身就是任务状态的一部分。模型不仅要知道用户让它做什么,还要看清当前页面,再决定下一步操作。
因此,JEMM可以同时接收文字指令和网页截图,再对候选动作进行判断。
这对于浏览器Agent尤其重要,因为真实网页并不只有文字。
按钮在哪里、页面怎么布局、弹窗是否出现、某个图标到底代表什么,很多时候都需要结合截图才能判断。
如果Agent只能读取文字或者DOM信息,那么它获得的只是网页的一部分。
JEMM则可以直接把截图纳入决策。
项目方公布的测试数据显示,在截图网页任务中,JEMM的准确率从36.0%提升到54.6%,提升了18.6个百分点。

这个结果也对应了JEMM和Jev之间一个比较直观的区别:
Jev主要面向文字决策,JEMM进一步把视觉状态加入了Agent决策过程。
对于浏览器操作、GUI Agent以及需要根据页面视觉状态做判断的任务,这种能力尤其直接。
02
工具调用准确率提升到93.3%
除了网页操作,JEMM还针对工具调用进行了专项训练。
Agent真正执行任务时,工具调用往往是一个高频环节。
搜索、浏览器、代码执行、文件处理、数据库查询……面对多个工具,Agent首先得判断当前到底应该调用哪个工具。
选错工具,后面的执行自然也就跟着出问题。
JEMM把这种任务直接作为决策问题来处理。
按照项目方公布的测试结果,工具调用准确率从88.7%提升到了93.3%。

这背后的逻辑其实很简单:
Agent先产生候选工具或者候选动作,再由JEMM负责快速判断。
它不需要重新生成一大段解释,只需要告诉Agent哪个选择更合适。
因此,这种模型并不是要取代通用大模型,而是更像Agent系统里的一个裁判。
候选方案由Agent产生,JEMM负责选。
当这种决策在一个任务里被重复几十次甚至上百次时,速度优势也会被进一步放大。
对于Agent来说,准确率是一方面,延迟同样重要。
毕竟Agent不是只做一次判断。
一个完整任务可能需要连续调用几十次决策模型,如果每次都需要等待较长时间,最终用户感受到的就是整个Agent“反应很慢”。
项目方针对5种文字请求配置对JEMM和Jev进行了延迟测试。
结果显示,JEMM在5种配置下的延迟都低于Jev。单题中位数延迟约为0.3秒,汇总延迟下降31.2%。

这也是JEMM比较有意思的地方。
它并不是简单地拿一个更大的模型去换准确率,而是在模型规模、专项训练和决策任务之间做取舍,让模型专门处理Agent需要的大量小判断。
如果一个Agent需要持续调用决策模型,这种优化可能比单次推理速度提升更有价值。
03
开放权重,
怎么把JEMM接进Agent?
JEMM采用 Apache-2.0 开源协议,官方提供了直接启动服务的方式。
先安装并启动:
pip install git+https://github.com/ypcypc/JEMMpython -m jemm.serve --adapter MaestroYan/JEMM --port 8790
启动后,Agent可以通过 /v1/systemone 调用JEMM。
调用逻辑其实很简单:
Agent给出当前状态 → 提供候选工具/动作 → JEMM选择、判断或评分 → 把结果返回给Agent。
例如用户问“明天巴黎会不会下雨”,Agent可以把天气查询、航班搜索和“不调用工具”作为候选项交给JEMM:
{"state": "User: Will it rain in Paris tomorrow?","questions": {"tool": {"type": "choice","criteria": {"get_weather": "Weather forecast","search_flights": "Flight search","none": "No tool applies"}}}}
JEMM返回决策结果后,Agent再根据结果调用对应工具。
除了 choice,还支持 noul 判断和 score 评分;如果是网页Agent,还可以额外传入最多4张截图。
因此,JEMM在整个Agent里的位置很明确:
任务 → 候选动作 → JEMM决策 → 工具执行 → 返回结果
而不是让JEMM负责整个任务的推理和执行。
这也是它比较适合接入现有Agent框架的地方:把高频的选择、判断和评分单独拿出来,用一个专门的决策模型处理。
END
关注+星标,获取AI前沿进展与开源一线动态