

Claude Haiku 5.5 发了。
它的单价只有 Sonnet 5.5 的二十分之一。提示词在 100k 以内,输入 $0.10、输出 $0.50(每百万 token)。
这个价格和 OpenAI 的 GPT-6 Luna 一样,是 Haiku 4.5 的十分之一。
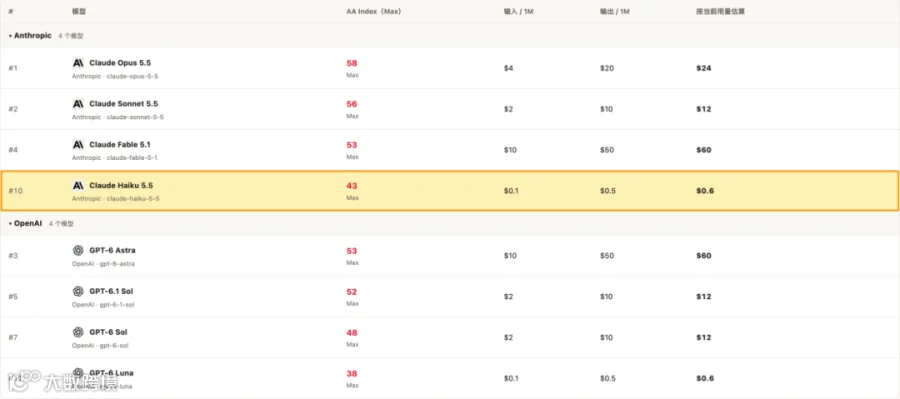
▲ 图:AA 榜单:Max 档指数与 API 价格
Sonnet 5.5 发布时,官方说过 Haiku 几个星期内会来。结果不到十天就到了。
能力方面,第三方 Artificial Analysis(下文简称 AA)给它的智能指数是 43。上一代 Haiku 4.5 只有 17,一下涨了 26 分。
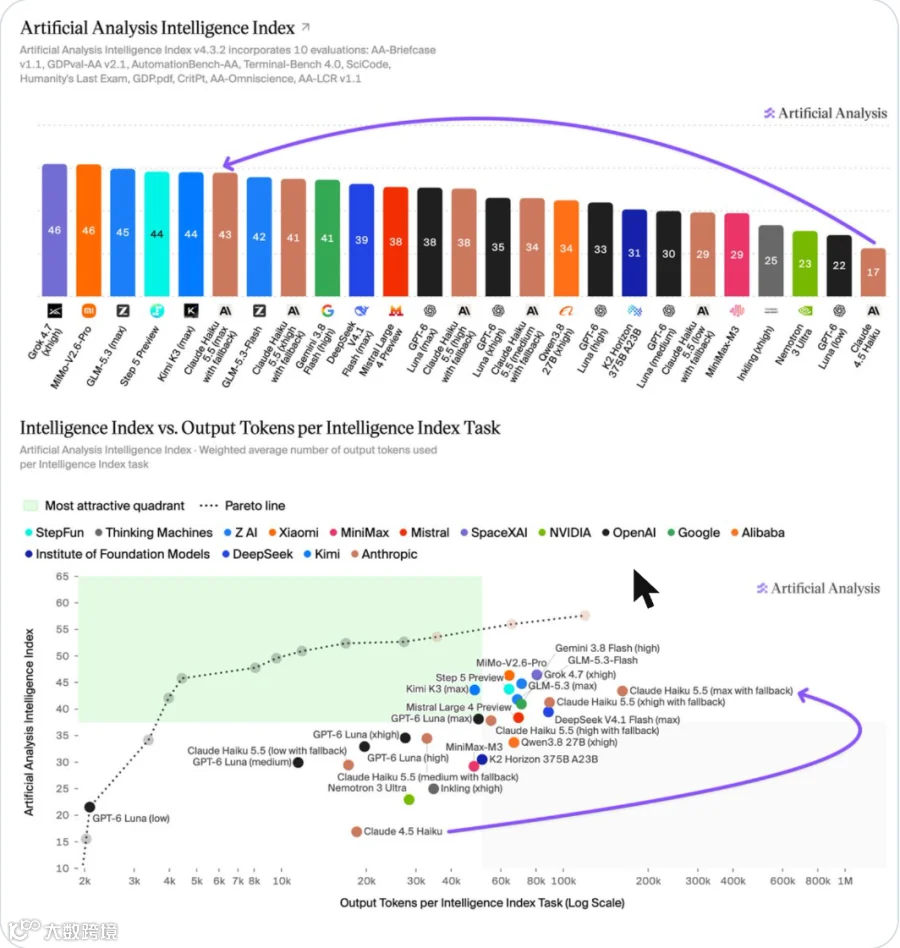
▲ 图:AA 智能指数榜与每个任务的输出 token
43 分是什么水平?AA 的对比是这样的:
略高于 GLM-5.3 Flash(42)和 Gemini 3.8 Flash(41),明显高于 GPT-6 Luna(38)。
和 Kimi K3(44)差不多。
比 Sonnet 5.5 的 56 落后一截。
01 对 Luna 全面领先,对 Sonnet 5.5 还差一截
官方给的表格,对比对象是 Haiku 4.5、GPT-6 Luna,Sonnet 5.5 作参考。
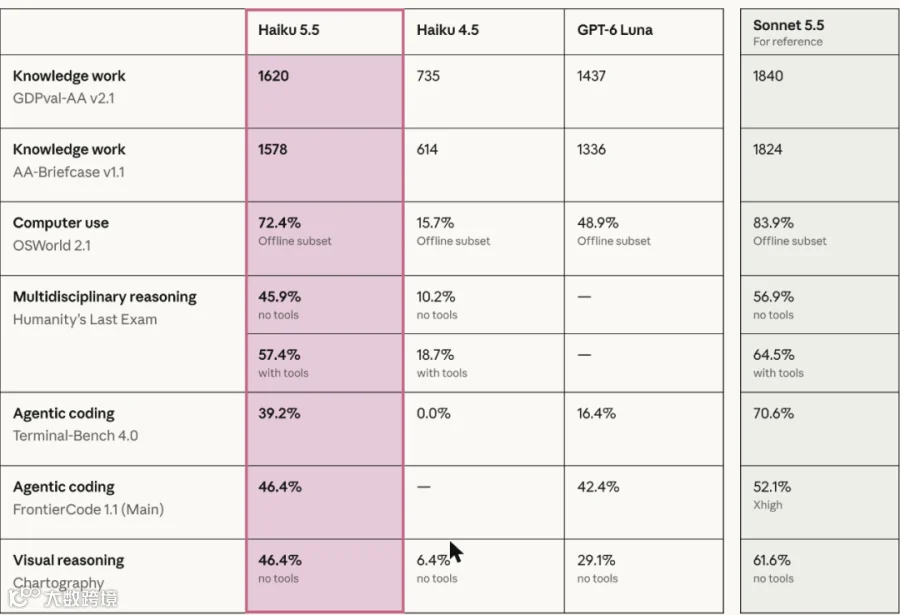
▲ 图:官方基准测试对比表
知识工作用的是 GDPval-AA 和 AA-Briefcase,测模型做真实办公任务的水平。
Haiku 5.5 是 1620 和 1578,Luna 是 1437 和 1336,领先不少。Sonnet 5.5 是 1840 和 1824,Haiku 落后一截。
上一代 Haiku 4.5 只有 735 和 614,进步幅度很夸张。
电脑操控看 OSWorld 2.1(官方用的是离线子集)。Haiku 5.5 拿到 72.4%,Luna 是 48.9%,遥遥领先。
Sonnet 5.5 是 83.9%,Haiku 4.5 只有 15.7%。
命令行任务 Terminal-Bench 4.0,Haiku 5.5 是 39.2%,Luna 是 16.4%,领先很多。
但 Sonnet 5.5 是 70.6%,差了一大截。AA 自己测的是 33%,同样高于 Luna 的 13%。官方也承认:这类复杂编码,还是该用大模型。
真实编码任务 FrontierCode 1.1,Haiku 5.5 是 46.4%,Luna 是 42.4%,略微领先;Sonnet 5.5 是 52.1%。
看图表理解的 Chartography,Haiku 5.5 是 46.4%,Luna 是 29.1%,领先;Sonnet 5.5 是 61.6%。
电脑操控这项,官方还给了每个档位的成本曲线。
Haiku 5.5 是首个带推理档位(Low 到 Max)的 Haiku。从图上看,它的每个档位都在 Luna 上方。
Max 档的成本,也低于 Sonnet 5.5 最低档的成本。
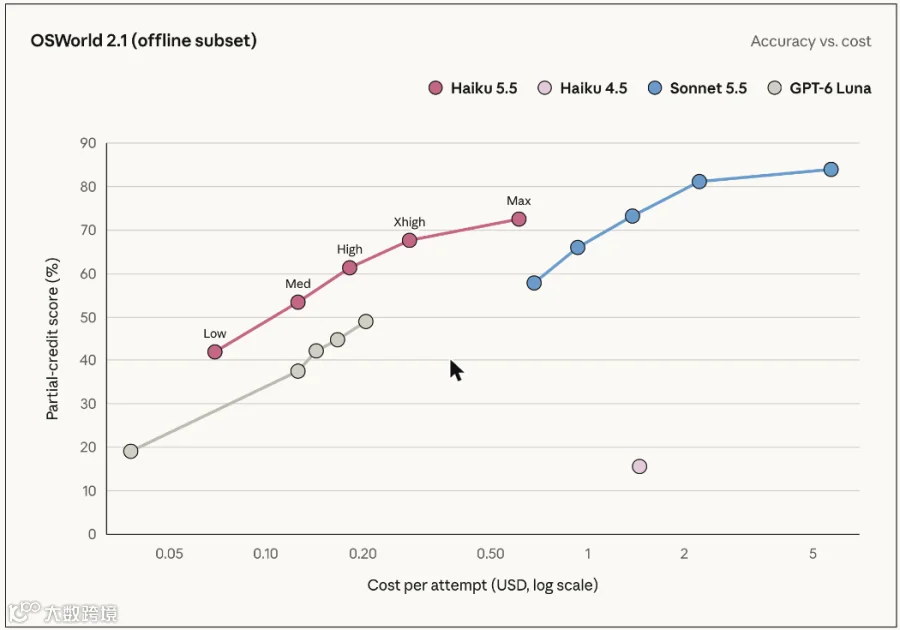
▲ 图:OSWorld 2.1 得分与成本
02 价格有个 100k 的门槛
官方报的综合数字:平均运行成本,比 Haiku 4.5 低约 75%。这个数已经算上了新分词器多出来的 token。
拆开看,提示词 100k 以内,价格降 90%。超过 100k,输入 $0.50、输出 $2.50,只降 50%。
官方说,上一代 Haiku 约 90% 的请求在 100k 以内,所以才有 75% 这个平均数。
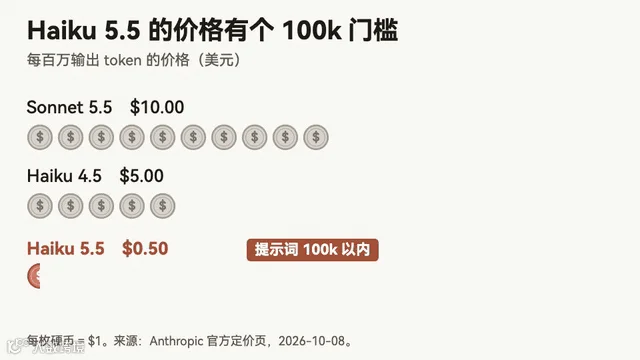
▲ 图:100k 门槛前后的输出价格
这里有个坑,是我的推断:Haiku 5.5 换了分词器,同一段内容的 token 数会略多。
以前刚好卡在 100k 以内的提示词,现在可能越线,价格直接涨 5 倍。长上下文的任务,迁移前最好用真实提示词算一遍。
缓存读取价格也很低:$0.01 / 百万 token(100k 以内),Haiku 4.5 是 $0.10。
单价之外,我做了一张性价比象限图,选的是 Max 档。
费用按输入、输出各 100 万 token 估算,不是每个任务的成本。
没想到的是,它把 GPT-6 Luna 和 DeepSeek V4.1 Flash 都斩杀了。Luna 和它同价,分数低 5 分;DeepSeek V4.1 Flash 更贵,分数也低。
分数比 Haiku 5.5 高的模型,估算费用最低也要 $5.5(Muse Spark 1.3),Kimi K3 是 $18。
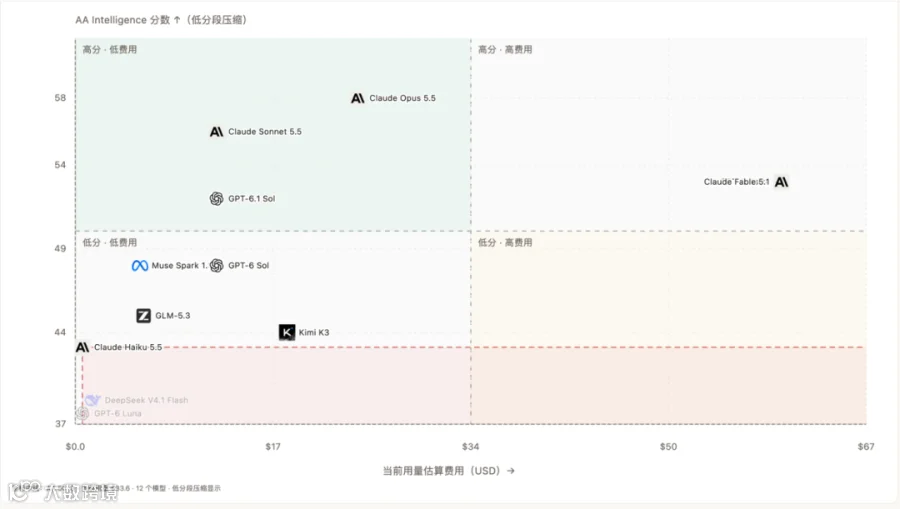
▲ 图:性价比象限图:Max 档分数与估算费用
这张图只算了单价,没算 token 用量。下一节会讲,Haiku 5.5 在 Max 档很费 token,实际的费用差距会比图上小。
03 同价不同量:它更费 token
价格只是单价。AA 有个提醒我觉得很关键:
Haiku 5.5 跑完一个 Intelligence Index 任务,Max 档平均要输出约 162k token,是 Luna(Max 档,约 50k)的三倍多。AA 还写到,这个数字超过了 Opus 5.5(Max)。

▲ 图:AA:每个任务的输出 token 数
分档位看更清楚。High 档得 38 分,用约 55k token,和 Luna Max 档同分、token 也差不多。
往上走,Xhigh 档 41 分、约 89k,Max 档 43 分、约 162k。多拿 2 分,要多花将近一倍的 token。
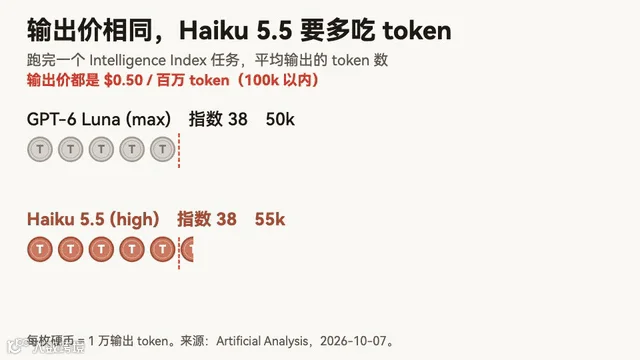
▲ 图:Luna 与 Haiku 5.5 各档位的输出 token
X 上也有人盯着这点。
Haider(@haider1)说,Max 档下它比 Opus 5.5 Max 更吃 token,用量超过 Fable 5.1 Max 的两倍。这是他的说法,我没有核对 Fable 的数据。
所以 Haiku 5.5 的便宜,要看档位。想要和 Luna 同价同分,开 High 档就行。
把档位拉到 Max 去追分,单价低的优势会被 token 用量吃掉不少。
AA 说价格页还没支持分档计费,每个任务的实际成本数据,他们稍后再补。
04 谁能用,适合干什么
Claude App 里已经能选 Haiku 5.5。
调 API 的开发者也能用,模型 ID 是 claude-haiku-5-5。Claude 平台、AWS、Google Cloud 和 Microsoft Azure 上都可用。
官方说,它适合量大、重复、对速度敏感的活:摘要、压缩上下文、查数据库、分类,还有实时客服和浏览器操作。
它也适合在编码任务里给 Opus 5.5 和 Sonnet 5.5 当子智能体。
需要长时间判断的复杂编码,还是得交给 Sonnet 5.5 和 Opus 5.5。
05 免责事项与限制
AA 提到一处:Haiku 5.5 在 AutomationBench-AA 上只有 35%,Luna 等对手是 53% 到 60%。
AA 的解释是,预发布测试时,模型的安全拒绝机制太敏感,过度拒绝了请求。Anthropic 正在修,AA 预计修好后会重测。
AA 还测了知识储备(AA-Omniscience):Haiku 5.5 的准确率是 36%,低于 Luna 的 44% 和 Gemini 3.8 Flash 的 55%。
不过它更愿意承认不知道,幻觉率只有 40%。小模型的知识面窄,这个表现符合预期。
安全方面,官方说网络安全防护比 Haiku 4.5 严,能做更多防御任务,但仍然拦截渗透测试。
上下文窗口是 1M,上一代是 200K,这是 AA 给的数据。
06 这次发布还有两个顺带的更新
Sonnet 5.5 的缓存读取价格减半,降到 $0.10 / 百万 token。官方说多数智能体任务因此便宜约 20%。
Max 和 Team 订阅用户,每月有一笔 API 额度:Max 5x 是 $100,Max 20x 是 $200,Team 最多 $500(团队共用)。
官方说这些额度可以用在任何模型上,用来做智能体和应用的实验。
Haiku 5.5 便宜、快、分数也不低。但它多出来的分是靠多想换来的,token 用量跟着涨。
你手上有哪些量大、活窄的任务?提示词有多长,会不会过 100k?这两件事,比单价更能决定它值不值得换。
08 参考资料
01|Anthropic:Claude Haiku 5.5 发布说明
https://www.anthropic.com/claude-haiku-5-5
02|Artificial Analysis:Haiku 5.5 评测帖(X)
https://x.com/artificialanlys/status/2107911905822351609
03|Artificial Analysis:Claude Haiku 5.5 模型页
https://artificialanalysis.ai/models/claude-haiku-5-5