

昨天看到一个有点夸张的消息。
而且这一次,金额已经不是几十亿的问题。
据彭博社、路透社等报道,DeepSeek 最新一轮融资原本计划募资约 500亿元人民币,但因为投资人认购非常积极,目前已经锁定至少 800亿元,最终融资规模甚至可能逼近 1000亿元。
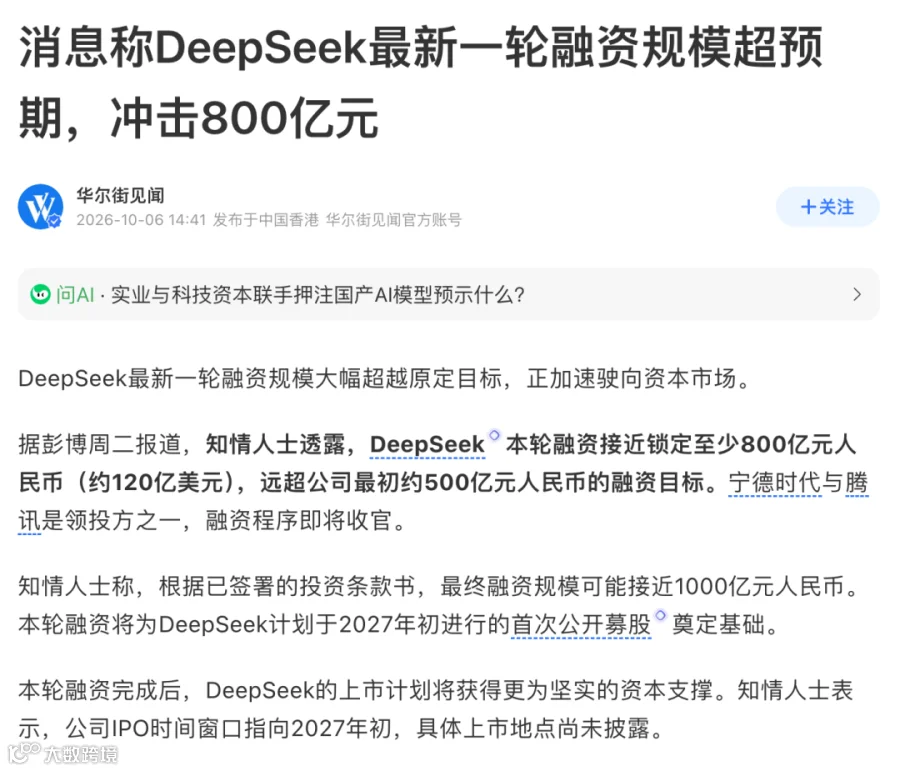
腾讯、宁德时代都是这一轮的重要投资方。DeepSeek 希望本轮对应的公司估值达到大约 5000亿元人民币,融资完成后,还在为未来登陆资本市场做准备。
这个数字有多夸张?
DeepSeek 今年 6 月才刚刚完成成立以来的第一轮外部融资,规模约 510亿元。
也就是说,如果这一轮最终真的融到 800 亿甚至 1000 亿,DeepSeek 在短短几个月时间里,累计融资规模就可能达到 1300亿—1500亿元。
更有意思的是,三年前刚成立的时候,这家公司几乎压根没怎么跟 VC 玩。
所以我特意把 DeepSeek 这几年的发展史和融资史重新扒了一遍。
看完之后会发现,DeepSeek 的资本路线,和绝大多数中国 AI 创业公司还真不太一样。
●DeepSeek最早的“投资人”,其实是幻方量化
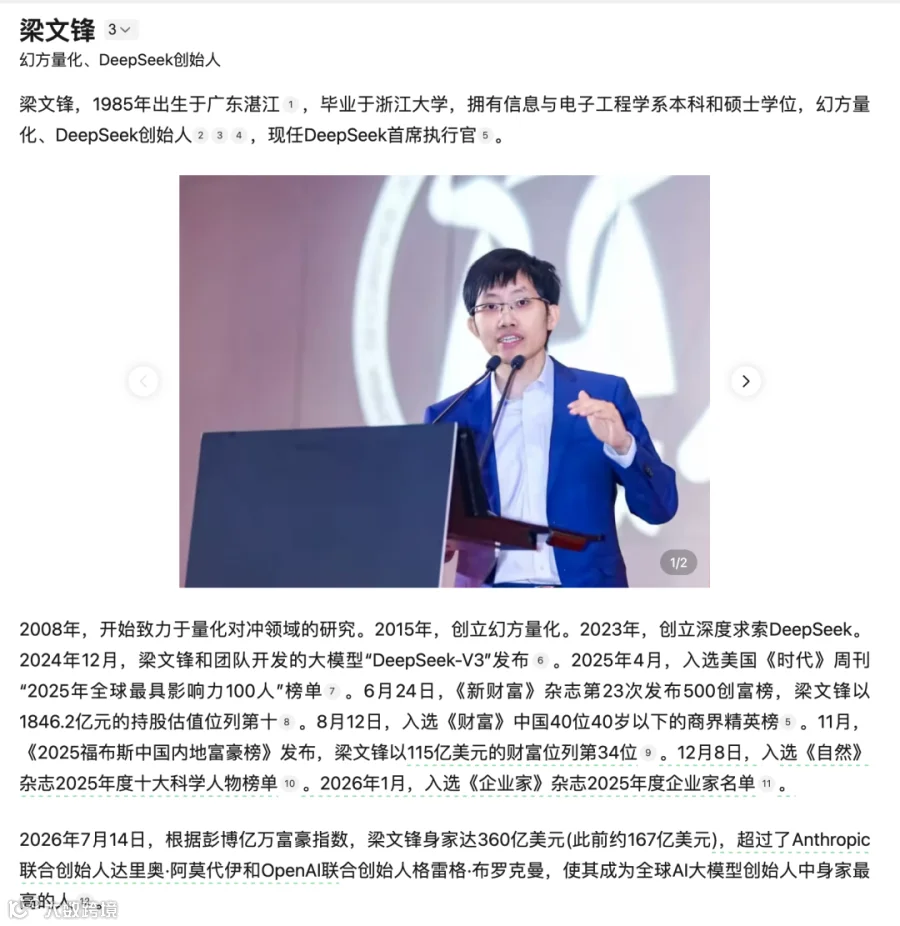
DeepSeek 的故事,得从梁文锋和幻方量化讲起。
梁文锋 2015 年创办幻方量化,靠 AI 和机器学习做量化投资。后来幻方逐渐进入国内头部量化私募行列。
而幻方有一个很重要的特点:
它很早就在疯狂囤算力。
2019 年前后,幻方已经开始组建 AI 研究团队,随后又陆续建设“萤火”系列 AI 超算集群。
这件事现在回头看非常关键。
因为 DeepSeek 后来突然冒出来,并不是梁文锋看到 ChatGPT 火了,2023 年才临时拍脑袋决定:“要不我们也训练一个大模型?”
钱、GPU、AI 研究人员,这些基础能力其实已经提前准备了好几年。
2023 年 7 月,杭州深度求索人工智能基础技术研究有限公司正式成立。
随后几个月,DeepSeek-Coder、DeepSeek LLM 等模型陆续上线。
当时 DeepSeek 在国内 AI 圈的存在感还没现在这么强。
毕竟那一年大家都在看“百模大战”:百度、阿里、腾讯、字节纷纷下场,智谱、百川、月之暗面这些创业公司也在一轮接一轮融资。
DeepSeek 显得有点另类。
别人拿到钱之后,买卡、招人、训练模型。
DeepSeek 直接拿幻方量化赚的钱养自己。
这也是为什么,从 2023 年公司成立一直到 2026 年,DeepSeek 几乎没有传统意义上的外部融资记录。
它背后本来就站着一家能够持续赚钱的量化基金。
●真正让DeepSeek出圈的,是2024年的价格战
2024 年 5 月,DeepSeek-V2 发布。
现在回头看,V2 的知名度可能远不如后来爆火的 R1,但我觉得这个模型才是 DeepSeek 第一次真正影响国内大模型竞争格局的产品。
DeepSeek-V2 使用 MoE 架构,总参数量达到 236B,但实际每次只激活其中一小部分参数。
这套架构一个非常明显的效果就是:
成本低。
随后 DeepSeek 开始疯狂压 API 价格。
当时国内大模型 API 价格还普遍比较贵,DeepSeek 一上来就把百万 Token 的价格直接打到了非常低的位置。
这一下直接把整个行业都卷了起来。
阿里、字节、百度等厂商随后纷纷跟进降价,大模型 API 很快进入“几厘钱、几毛钱”的价格战时代。
DeepSeek 也就是从那个时候开始,慢慢形成了自己的标签:
性能能打、价格便宜、还喜欢开源。
真正让这个标签出圈的,是 2024 年年底发布的 DeepSeek-V3。
V3 总参数达到 671B,每次激活约 37B 参数,训练数据达到 14.8 万亿 Token。
随后一个数字更是刷屏 AI 圈:
557.6万美元。
DeepSeek 在 V3 技术报告中披露,如果按照 H800 GPU 每小时 2 美元的价格计算,V3 正式训练阶段所消耗的约 278.8 万 GPU 小时,对应的计算成本大约为 557.6 万美元。
这里也顺手帮网上一个流传很广的说法纠个偏。
经常有人说:
“DeepSeek只花了500多万美元,就训练出了V3。”
严格来说并不准确。
557.6 万美元指的是 V3 正式训练阶段的计算资源成本,不包含此前大量研究实验、数据处理、工程投入、人员工资以及购买 GPU 和搭建集群的成本。
但即便如此,这个数字依然非常震撼。
因为它第一次让整个硅谷开始认真讨论一个问题:
训练顶级大模型,真的必须像 OpenAI 那样疯狂堆 GPU 吗?
●R1之后,DeepSeek彻底换了一个身份
真正把 DeepSeek 推向全球舞台的,是 2025 年 1 月发布的 DeepSeek-R1。
R1 主打推理能力,并且直接开放模型权重,采用相当宽松的开源许可。
更重要的是,它在数学、代码、逻辑推理等很多测试里的表现,已经能够和当时 OpenAI 的 o1 正面比较。
然后事情迅速失控。
DeepSeek App 很快登上美国 App Store 免费榜第一,一度超过 ChatGPT。
海外科技圈开始集体研究这个突然冒出来的中国 AI 公司。
资本市场甚至被吓了一跳。
围绕“DeepSeek 用更少算力做出了高性能模型”的讨论迅速发酵,英伟达股价一度单日暴跌约 17%。
从这一刻开始,DeepSeek 已经不再只是“中国又一家大模型创业公司”。
它成了全球 AI 竞争里的一个变量。
随后 DeepSeek 又继续沿着自己的路线迭代模型。
V3.1、V3.2,再到今年的 V4、V4.1 Flash,DeepSeek 一边强化推理、Agent 和工具调用能力,一边继续干一件自己最擅长的事情:
把模型成本往下压。
所以你会发现,DeepSeek 过去三年的技术路线其实非常稳定。
模型越来越强,同时尽可能提高训练和推理效率。
这也是为什么,它能在没有疯狂融资的情况下,先把自己的技术名声打出来。
●但到了2026年,DeepSeek也开始融资了
真正的转折发生在今年。
2026 年 4 月开始,市场陆续传出 DeepSeek 接触外部投资者的消息。
到了 6 月,事情基本敲定。
DeepSeek 成立近三年之后,终于完成了自己的第一轮外部融资。
这轮融资最终规模超过 500亿元人民币。公开工商信息显示,融资规模约为 510 亿元,公司估值接近 4000 亿元。
投资方阵容也挺夸张。
梁文锋本人投了大约 200亿元,腾讯约 100亿元,宁德时代约 50亿元,京东、网易、IDG 等机构也参与其中。
国家人工智能产业投资基金同样进了这一轮。
光看这个阵容,就已经不像一家普通创业公司的融资了。
而且这轮融资还有一个很有意思的地方。
根据 The Information 的报道,大部分外部投资人的钱,并不是直接投入 DeepSeek 公司主体,而是进入由梁文锋管理的有限合伙企业。
这些投资人的股份还有长达5年的锁定期,并且大多没有 DeepSeek 的投票权。
翻译成人话就是:
钱可以进来,但公司到底怎么做,梁文锋还是要自己说了算。
这很 DeepSeek。
●第一轮刚融完,第二轮就来了
更夸张的事情很快又发生了。
第一轮融资刚刚结束没多久,DeepSeek 就开始筹备第二轮融资。
今年 7 月,The Information 披露,DeepSeek 正在寻求再融资约 500亿元人民币,对应估值大约 5000亿元。
然后 DeepSeek 的商业化数据也开始冒出来。
今年 9 月,The Information 披露,DeepSeek 的年化收入运行率已经达到约10亿美元,比几个月前又翻了一倍以上。
注意,是“年化收入运行率”,不代表 DeepSeek 已经在一年内收了 10 亿美元,而是按照当时的收入速度推算,一年大约可以做到这个规模。
梁文锋还向投资人透露了一个很有意思的数据:
DeepSeek 目前 70%以上的算力仍然拿去训练模型,真正用来跑线上推理服务的算力不到 30%。
这其实已经解释了 DeepSeek 为什么突然需要这么多钱。
以前,它可以靠幻方养。
但当 DeepSeek 从一家研究型 AI 实验室,变成一家真正参与全球基础模型军备竞赛的公司之后,游戏规则变了。
训练下一代模型要钱,GPU 要钱,数据中心要钱,跑海量用户的推理服务同样烧钱。
今年前 7 个月,DeepSeek 在 AI 基础设施上的投入据报道已经达到约 110亿元人民币,而 2025 年全年只有约 12 亿元。
更夸张的是,DeepSeek 还计划在内蒙古建设大型数据中心。
据彭博社报道,这个数据中心未来计划部署至少 16万颗华为昇腾 950DT AI 芯片,主要拿来运行 DeepSeek 的模型。
16 万颗。
这个规模已经不是幻方量化从利润里拨点钱,就能轻松解决的问题了。
所以到了现在,DeepSeek 第二轮融资又出现了最新版本:
原计划融资 500 亿,投资人的认购需求实在太旺,至少已经锁定800亿元,最终甚至可能达到1000亿元。
如果最终真的做到 1000 亿,再加上第一轮的 510 亿:
DeepSeek 今年融资规模可能直接突破1500亿元。
一家前三年基本没拿外部钱的公司,一打开融资大门,就直接奔着千亿去了。
●DeepSeek真上市,梁文锋可能顺便去争中国首富
另外这里还有一个挺有意思的彩蛋。
DeepSeek 现在已经在为上市做准备。
最新报道显示,公司正在推进国内 IPO,目标很可能是上交所科创板,中信证券参与相关准备工作。
如果 DeepSeek 真顺利上市,梁文锋的个人财富可能也会迎来一次非常夸张的重估。
网上之前甚至流传过一个说法:
DeepSeek一上市,梁文锋可能直接成为中国首富。
这句话说得有点简单粗暴,但背后的数学并非完全没道理。
因为梁文锋对 DeepSeek 的控制权一直非常强。首轮外部融资甚至专门设计了有限合伙和无投票权等安排,就是为了在引入外部资本后,继续保持创始人的绝对控制。
当然,“控制权”不能直接等同于“个人持股比例”,后续融资和 IPO 也会进一步产生稀释,所以现在直接算梁文锋上市后的精确身家,其实没什么意义。
但可以粗略算一笔账。
这一轮 DeepSeek 的目标估值已经达到 5000亿元。
如果未来上市之后,DeepSeek 市值再翻一倍,冲到 1万亿元,只要梁文锋仍然保留较高比例的经济权益,他对应的财富规模就可能达到数千亿元。
真到了那个时候,和张一鸣、钟睒睒、马化腾这些中国顶级富豪放在一起比较,就一点都不夸张了。
所以,“DeepSeek上市,梁文锋成为中国首富”现在当然还不能当成事实。
但如果上市后市值真的冲到万亿级,这事还真不是段子。
三年前还躲在幻方量化后面做模型的人,搞不好哪天真的会坐到中国财富榜最前面。
这个故事多少有点魔幻。
●DeepSeek用了三年,把资本故事倒着讲了一遍
重新看完 DeepSeek 这三年的路线,我最大的感受其实不是:
DeepSeek 真能融资。
恰恰相反。
它最特别的地方,是很长一段时间根本不靠融资讲故事。
2023 年,公司成立,幻方出钱养。
2024 年,V2 开始打 API 价格战,V3 把训练效率做到全球出圈。
2025 年,R1 一战成名,把 DeepSeek 从中国 AI 圈直接送到了全球牌桌。
到了 2026 年,模型、用户、收入、知名度全部有了,它才真正大规模向外部资本打开大门。
很多 AI 创业公司的路线是:
拿融资 → 买卡 → 招人 → 训练模型 → 再讲下一轮融资故事。
DeepSeek 的顺序差不多反了过来:
先自己掏钱把模型做出来,先证明自己能打,再让投资人排队进场。
结果也挺有意思。
今年 4 月,市场还在讨论 DeepSeek 能不能值 100 亿美元。
几个月之后,它已经按照约 5000亿元人民币的估值谈融资。
原计划第二轮只融 500 亿,现在投资人的认购需求已经把融资额顶到了 800 亿甚至 1000 亿。
资本从来不缺钱。
真正稀缺的,是那种让资本觉得:
现在不上车,以后可能更贵。
现在的 DeepSeek,大概已经走到了这个阶段。
接下来真正值得看的,也不是梁文锋还能融多少钱。
而是手里突然多了上千亿资本之后,他准备把 DeepSeek 做到多大。
--推荐阅读--
做副业缺个门面?腾讯这次白送
马斯克又改名了,这次改成SpaceXSI
ChatGPT连续28天交作业,没更新就“重置”