


一份英译中的本地化基准测试,最近在外贸圈里被转得不少。很多人第一反应是看谁排第一、国产模型和西方模型谁更强。这种读法容易走偏。真正值得外贸团队拿走的,不是一张排行榜,而是一套分流的思路:哪些内容可以放手给 AI,哪些必须留人,以及选型时到底该拿什么做比较。
先把这份测试的边界说清楚,再谈怎么用。
这份测试到底测了什么
这项研究由 EC Innovations 与 Jademond Digital 联合开展,两家公司本身都在卖与所评测做法相关的服务。这一点不影响它有价值,但读结论时要留个心眼——研究方在自证一个它参与的市场。
测试规模是 774 份本地化产出,覆盖 6 种内容类型、7 类工作流模式、3 种任务类型。评分按准确性、流畅度、风格与文化适配三个维度,各占三分之一,由中文母语的专业本地化人员盲评。
三个限定词很关键:英译中、中文母语者评分、只评本地化质量。外贸团队日常面对的往往是从中文或英文出发,落到德语、西语、阿拉伯语。方法可以借,分数不能直接搬过去排座次。
按内容类型分流,而不是按“AI 行不行”分流
“AI 翻译到底行不行”这个问题问得太粗。同一份测试里,不同内容类型的结论并不一致。
SEO 内容上,人工得 74.1 分排第一,比最好的 AI 工作流高 2.8 分。这个差距存在,但不大——意味着在这类重精确度的内容上,人工仍有领先,只是领先幅度已经不支持“非人不可”的绝对判断。资讯类内容也属于这一档:人工占优,差距有限。
营销、UI、技术、社交这几类,人工未必占优。营销内容尤其需要盯住一个细节:AI 初稿容易把语气改得过于书面,原文里那种直接、口语、带点锐度的表达,很容易被磨平。这类内容不是不能用 AI,而是用完之后要专门检查语气,而不是只检查有没有错译。
所以决策顺序应该是:先问这段内容属于哪一类,再问这类内容上人工和机器的历史表现差多少,最后才决定谁来主导。反过来做——先定了工具,再想它能干什么——就会把不该交出去的内容也交出去。
别按“国产”“西方”这类标签选型
测试里有个数字很容易被误读:未经编辑的中国 LLM 平均分和西方 LLM 平均分都是 60.7。
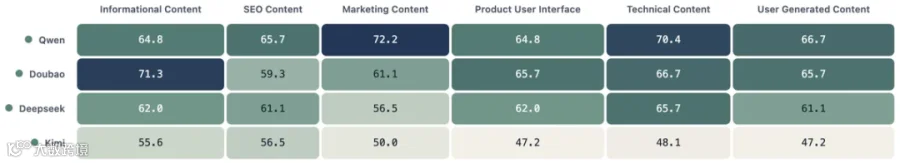
这个“中国 LLM:60.7”是 Qwen、Doubao、DeepSeek、Kimi 四个模型的简单平均。而同样这四个模型,在技术内容上的分差达到 22.3 分,在 SEO 内容上是 9.2 分。
22.3 分是什么概念?它比人工和最好的 AI 工作流在 SEO 上的差距(2.8 分)大出不少。也就是说,同一类别内部的差异,可能大于类别之间的平均差异。拿“国产大模型”“西方 LLM”这种标签去做选型,容易用一个是被平均掉的数字,掩盖具体模型之间的差别。
实际要对比的是具体模型,而且要落到具体内容类型上比。一个模型在技术内容上表现好,不代表它在营销内容上也行。选型表应该按“模型 × 内容类型”来填,而不是按“厂商 × 总分”来填。
译后编辑不是默认加分项
很多团队的默认流程是:AI 出初稿,人再过一遍。听起来稳妥,但这份测试提示,译后编辑本身是一个需要单独验证的变量,不是无条件的加分动作。
用户生成内容上,对 Google 翻译输出做一遍译后编辑,从 33.3 分升到 63.9 分,提升非常明显。但在营销内容上,对西方 LLM 初稿做译后编辑,类别层面是 −0.9 分——负收益。
同一个动作,在不同内容类型上方向相反。原因不难理解:用户生成内容原本质量低,人一改就往好走;营销内容如果初稿的语气本来是对的,人工编辑反而可能把它改得更书面、更“安全”,丢掉了原有的锋利。
所以译后编辑要按内容类型分别测,而不是全站统一规定“必须人工过一遍”。测的方法是:同一批内容,比较“AI 初稿”和“AI 初稿 + 人工编辑”两组评分,看差值是正还是负。负收益的内容类型,就该考虑减少人工介入,或者换一种编辑方式。
翻译质量不等于搜索表现
这份测试只衡量本地化质量,没有收集任何排名、流量、转化数据。这一点必须说透,否则很容易把“翻译分高”直接等同于“能带来询盘”。
公开证据里,Portent 爬取了 756,297 个有排名页面,未发现可读性与 Google 排名位置之间存在相关性。这至少说明,内容读起来顺不顺,和它能不能排上去,不是一回事。
对多语种站点来说,还有两个问题需要另行验证:关键词在目标语言里是否真的有人搜,以及多语种页面能否被正常收录。这两件事和翻译质量是独立的,不能靠翻译评分来回答。
你可以马上做的一次检查
不用等下一份报告,也不用换工具。挑出你站点上最近上线的 20 个多语种页面,按内容类型分成 SEO、营销、UI、技术、社交、用户生成这几堆,每堆里再标一下:这篇是 AI 直接出的、AI 出加人工编辑的、还是人工主导的。
然后只问一个问题:这一堆里,人工主导的那几篇,和 AI 主导的那几篇,在客户反馈或询盘上有没有可感知的差别?如果没有,说明这一堆可以更多地交给 AI;如果有,就保留人工。
这个动作不需要额外预算。它做的是把你自己的页面表现,和那份测试的结论对上一次——测试提供的是参考,你自己的页面提供的是实际反馈。