独角兽早知道 iponews
10月6日,据彭博社援引知情人士消息,DeepSeek接近在最新一轮融资中锁定至少800亿元人民币(约合120亿美元),募资规模远超公司最初设定的约500亿元目标。宁德时代与腾讯控股是承诺出资金额最高的投资方之一,融资程序即将收官。
知情人士补充,根据已签署的投资条款清单,本轮最终融资总额有望逼近1000亿元人民币。这一轮融资将为DeepSeek计划于2027年初进行的首次公开募股奠定基础。
从500亿到800亿、再到可能突破千亿,DeepSeek的融资规模在短短两个月内经历了三级跳。
综合 | 彭博社 华尔街见闻 编辑 | Arti
本文仅为信息交流之用,不构成任何交易建议

这是DeepSeek不到半年内的第二轮外部融资,两轮融资共同改写了中国AI行业的融资纪录。
2026年6月,DeepSeek完成成立以来的首轮外部融资,募资总额达510亿元,投后估值接近4000亿元,创下当时国内AI行业单轮融资规模最高纪录。
该轮融资由创始人梁文锋个人出资约200亿元,腾讯出资100亿元,宁德时代体系出资约50亿元,网易、京东及IDG资本各出资30亿元,国家人工智能产业投资基金战略跟投。该轮交易采用有限合伙架构,外部投资方多不具投票权,股份锁定五年,梁文锋仍掌握近100%表决权。
首轮融资完成后,DeepSeek于7月中旬迅速启动第二轮融资,最初目标融资约500亿元、目标估值约5000亿元,计划10月底前完成交割。然而,最新AI模型发布后的市场反应远超预期,投资者认购热情推动募资规模持续上修。
从6月首轮到10月二轮,DeepSeek在四个月内完成了两轮合计超过1300亿元的融资规模,估值从不足4000亿元升至5000亿元以上。这一融资体量和节奏,在中国AI行业历史上尚无先例。
腾讯和宁德时代的持续加码,对应着两家产业方不同的战略逻辑。腾讯将AI能力融入旗下各个平台的需求日益迫切,宁德时代则看中为AI行业供应零部件、为数据中心供货的增量市场。两者在首轮融资中就已入场,二轮中进一步加大投入,成为出资金额最高的投资方。
支撑融资超募的核心变量,是DeepSeek在商业化上的实际兑现。
据The Information报道,DeepSeek年化营收运行率已突破10亿美元,较数月前不足5亿美元的数字翻了一番有余。CEO梁文锋在近期投资者会议上披露了这一数据,并明确表示API价格上调并未造成客户流失,用户需求依旧强劲。
营收翻倍的核心驱动力来自8月中旬的API价格调整。DeepSeek将模型调用价格上调至原来的2.3至4.5倍,其中缓存命中部分的涨幅尤为显著,以V4 Pro为例,高峰时段缓存命中输入价格较此前上涨约1100%。涨价并未导致客户流失,梁文锋在投资者会议上直言,调价后用户需求依然强劲。
更值得关注的是收入质量。2026年前七个月,DeepSeek收入约为4.75亿元,已是2025年全年收入的约十倍,同期API接口业务毛利率高达82.9%,综合毛利率为44.6%。同期净亏损约7.15亿元,较2025年全年9.35亿元的亏损明显收窄。
这意味着DeepSeek的收入模型不是“烧钱换规模”,而是在低价策略建立起市场壁垒之后,通过逐步提价将技术优势转化为利润空间。截至目前,DeepSeek的收入几乎全部来自模型API调用收费,其广受欢迎的对话机器人App仍保持免费且无广告,尚未产生直接收入。换句话说,10亿美元的ARR是在尚未激活C端变现的情况下实现的,这为未来的收入增长留下了可观的想象空间。
2026年4月24日,DeepSeek发布并以MIT协议开源V4系列预览版,V4-Pro与V4-Flash均支持百万Token上下文与“思考/非思考”双模式;7月底至8月初,V4-Flash正式版落地;9月10日,DeepSeek再度发布全新架构下的V4.1-Flash,具备原生多模态视觉理解能力,GPQA Diamond评测达到90.9分。
技术架构上,V4.1 Flash为552B参数的MoE模型,采用了全新的Causal-Encoder-Decoder结构,输入和输出不对称,输入激活仅8B,输出激活16B,成本显著低于同尺寸模型。在基准测试中,V4.1 Flash多项指标超越了DeepSeek V4 Pro在内的旗舰模型。
彭博行业研究10月5日发布的报告显示,自V4.1 Flash推出后,中美顶尖模型的基准测试得分差距已缩小至约3%,而今年5月这一数字约为9%、年初约为15%。9月,V4.1 Flash在LiveBench榜单上位列第六、得分81.1,成为DeepSeek自2025年R1一战成名以来排名最高的中国模型,表现已可媲美Anthropic、OpenAI的领先系统,而调用价格显著更低。
这种“性能接近、价格更低”的定位,使DeepSeek在全球AI模型市场中形成了一种独特的竞争范式:用极致的性价比建立用户规模,再通过逐步提价将规模转化为利润。
与其他AI企业一样,DeepSeek需要持续投入巨额资金以支撑其人工智能业务发展。
据知情人士透露,DeepSeek计划在内蒙古建设大型数据中心,部署至少16万枚华为高端AI加速器,若规模落地,将可能成为目前已知规模最大的华为AI芯片集群之一。与此同时,DeepSeek已正式开源面向华为AI芯片算力平台的基础设施组件,进一步深化与华为生态的绑定,也为国产AI算力自主化路线提供了更具参照价值的落地案例。
值得关注的是,梁文锋此前曾向投资者透露,公司把70%以上算力分配给模型训练,留给已有模型推理运行的算力不足30%。轻量化模型可在游戏显卡上稳定运行,能够处理用户绝大多数日常任务,这一策略在缓解推理算力紧张的同时,也降低了推理环节对高端芯片的依赖。在训练端,DeepSeek正加速向国产芯片迁移,内蒙古数据中心的大规模部署正是这一迁移的具体落地。
DeepSeek的IPO筹备,需要放在2026年港股大模型板块集体冲刺的背景下理解。
2026年1月,智谱在港交所挂牌,成为全球“大模型第一股”,MiniMax紧随其后登陆港交所。两家竞争对手先后完成上市,为DeepSeek的估值提供了一个可参照的公开市场锚点。
在融资和IPO推进的同时,DeepSeek的治理架构也在同步调整。
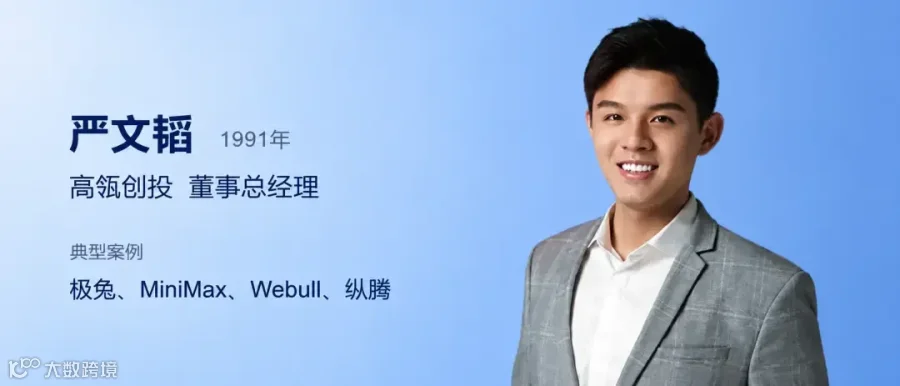
9月21日,原高瓴创投合伙人严文韬正式入职,出任首席财务官,终结了公司成立三年来CFO岗位的空缺。严文韬出生于1991年,毕业于复旦大学,2013年至2020年间先后在腾讯投资和H Capital任职,2020年加入高瓴创投并晋升为合伙人,参与投资过字节跳动、智谱、MiniMax、极兔等项目。
选择一位具有深厚AI投资背景的年轻财务负责人,传递的信号很明确:DeepSeek需要的不仅是财务合规能力,更是能够理解技术逻辑、对接资本市场的战略型人才。
严文韬到岗的时间节点颇具深意。9月9日,路透社援引两名知情人士消息称,DeepSeek已经与中信证券接触,正筹备在上海证券交易所科创板上市,并计划今年启动相关流程。中信证券已与DeepSeek方面接洽并进入尽职调查阶段,但双方尚未签订正式的上市辅导协议。
知情人士称,本轮融资落定后,DeepSeek的下一步将是推进公司重组,为IPO做准备。融资完成后DeepSeek的主要任务之一也是扩充公司人员规模。今年国庆期间,DeepSeek Harness发布了新版本,强化插件化和跨平台能力,DeepSeek Harness负责人崔添翼在社交媒体发文称,自己每天工作的相当一部分时间都用于为DeepSeek招人和面试。
从6月首轮510亿元融资到10月二轮锁定至少800亿元,从ARR不足5亿美元到突破10亿美元,从CFO到岗到科创板IPO筹备启动,DeepSeek在四个月内完成了从技术驱动的研究机构向公众公司转型的关键步骤。
腾讯和宁德时代的联合领投、API毛利率82.9%的盈利结构、V4.1 Flash在LiveBench榜单上第六名的表现、内蒙古16万枚华为芯片的数据中心规划,这些数据勾勒出DeepSeek在资本、产品、算力三个维度上的同步推进。
但从“融资超募”到“成功上市”,中间还隔着公司重组、监管审核和市场定价的多重检验。ARR从不足5亿美元到突破10亿美元的增长固然令人瞩目,但10亿美元ARR对应的5000亿元估值能否在公开市场获得认可,将取决于DeepSeek的收入增速能否在上市前持续保持。
内蒙古数据中心能否按计划落地、国产芯片训练大模型的效率能否达到预期、以及港股大模型板块在智谱和MiniMax股价大幅回撤后的情绪修复进度,都是影响DeepSeek上市窗口期的关键变量。

注:本文素材来源于互联网公开渠道,如有侵权请联系删除。内容所述仅代表个人观点,不作为指导依据,据此操作风险自担!
【公司回顾】