

斯坦福1小时讲透2026年的所有AI知识
Mihail Eric《AI in 2026: Soup to Nuts》斯坦福商学院演讲
全场PPT逐页翻译+解读 · 附Q&A精华
2026年了,AI 早就不是"会不会用 ChatGPT"的问题。神经网络、Transformer、LLM、推理模型、Agent……概念满天飞,但大多数人缺的不是又一个工具教程,而是一张完整的AI地图。
最近,斯坦福商学院 AI@GSB 邀请 Mihail Eric 做了一场一小时的重磅演讲,题目直译过来叫《2026年的人工智能:从入门到精通》。他从15年AI进化史讲到现代模型配方,从Agent解剖讲到商业模式变革,最后留下了一份"开放问题清单"。
这篇推文把全场21页核心PPT原样贴出,每页下面配中文翻译和解读,文末附Q&A精华。收藏这一篇,胜过刷一百条碎片视频。
Mihail Eric(米哈伊尔·埃里克),业内公认的"既能造模型、又能讲人话"的实干派。他的履历在AI圈属于稀缺组合:
🎓 斯坦福本科+硕士,计算机科学(CS)出身,师从 NLP 领域泰斗 Christopher Manning,在斯坦福 NLP 组做了多年研究,论文发表在 ACL、AAAI、NeurIPS 顶会,学术引用数千次;
🛠️ Amazon Alexa 资深机器学习科学家,Alexa 首批大语言模型的建设者、第一个特殊项目组的创始成员;
💰 连续创业者:创办 ML 教育平台 Confetti AI(2022年被 Towards AI 收购);联合创办 YC 孵化的 AI 编程公司 Storia AI;
🏢 现任 Monaco(旧金山AI销售系统初创,获 Founders Fund、Benchmark 等顶级机构投资)AI 负责人,同时是斯坦福 CS146S《现代软件开发者》课程创始人兼讲师——这是斯坦福第一门AI编程课;
✍️ 撰写 AI 工程领域知名 Newsletter(订阅者数万人),全网内容阅读量超300万,还有个隐藏身份:业余脱口秀演员——这场演讲里也确实包袱不断。
▲ 这个背景说明他讲的不只是"学术前沿",而是一线造模型、卖AI产品的真金白银经验。演讲开场他还自嘲:读CS本科时每周都收到商学院学生找技术联合创始人的私信,一封都没回——十年后受邀回到同一个礼堂,"你们真执着"。
|
|
|
|---|---|
| ① 15年进化史 |
|
| ② 现代模型配方 |
|
| ③ 应用与商业模式 |
|
| ④ 基础设施 |
|
| ⑤ 开放问题 |
|
开场他就纠正一个流行的误解:"如果有人觉得AI是两年前才冒出来的,我会反驳——至少有10到15年、一波比一波大的技术浪潮,才把我们推到今天。"
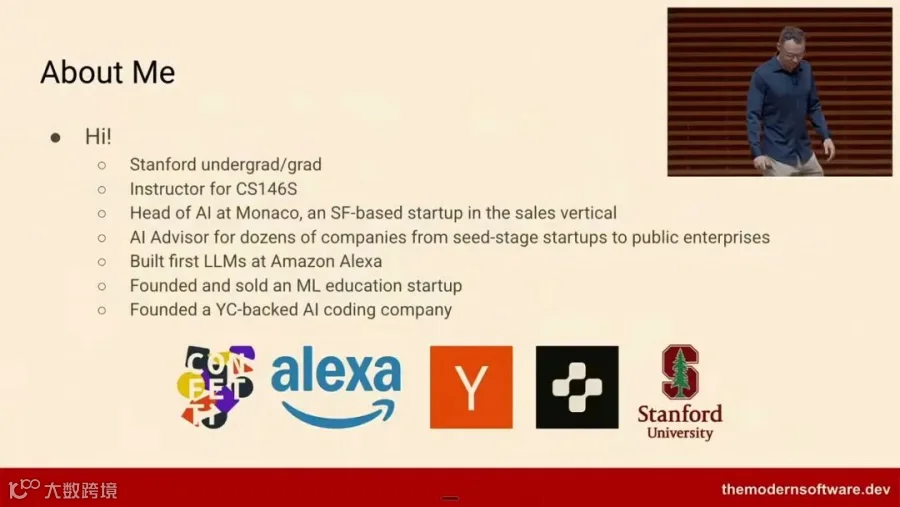
【原版翻译】About Me|关于我
大家好!我是斯坦福本科/硕士毕业,CS146S 课程讲师,Monaco(一家旧金山销售领域初创公司)AI负责人,数十家公司的AI顾问(客户从种子期初创到上市企业)。我曾在 Amazon Alexa 造出最早的LLM,创办并出售过一家机器学习教育初创公司,还创办过一家YC投资的AI编程公司。

【原版翻译】Outline|本场目录
AI简史 → 术语扫盲 → 应用全景 → 基础设施 → 开放问题 → 结语。(这一页他口头展开:不管你是什么技术背景,听完都能带着一套完整的AI语汇走出教室。)
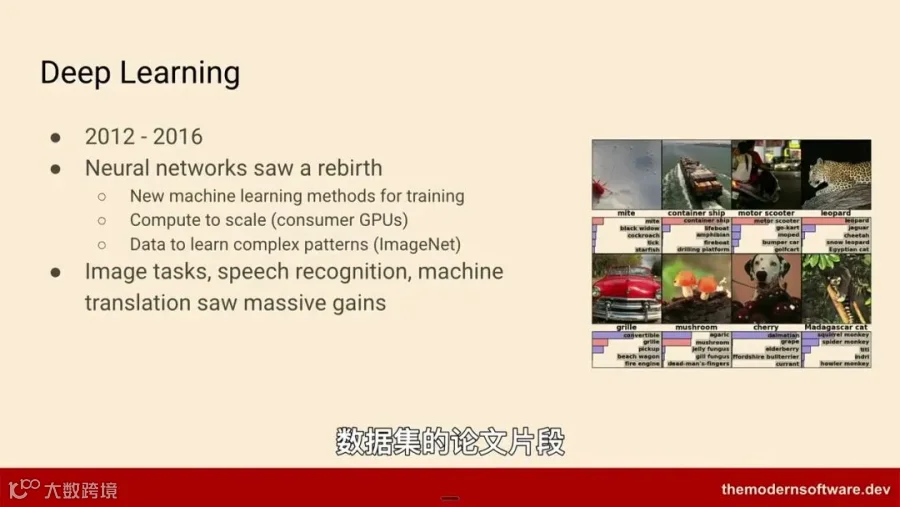
【原版翻译】Deep Learning|深度学习(第一波:2012-2016)
● 神经网络迎来重生:新的机器学习训练方法 + 算力规模化(消费级GPU)+ 数据量足以学习复杂模式(ImageNet);
● 图像任务、语音识别、机器翻译获得巨大提升。
解读:深度学习的算法上世纪50年代就有了、90年代就很成熟,为什么2012年才爆发?他给出"完美汇聚"三要素:新方法×GPU×大数据。特别提到 ImageNet 数据集正是斯坦福李飞飞教授团队2009年前后创建的——"黄仁勋也是从那时候开始变得更富了"(全场笑)。右侧那张图就是当年第一批把神经网络用在ImageNet上的论文截图:识别螨虫、集装箱船、小绵羊、豹子——以今天标准看简单到可爱。
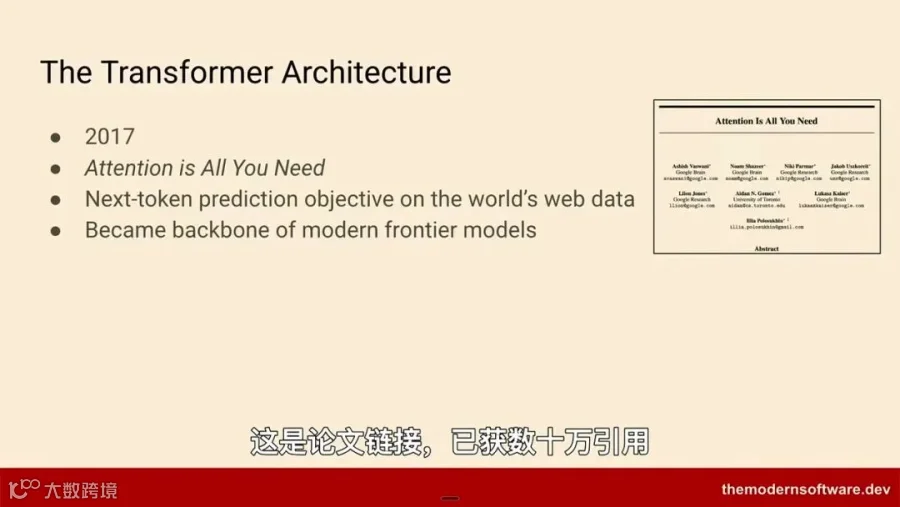
【原版翻译】The Transformer Architecture|Transformer 架构(第二波:2017)
● 2017年,论文《Attention is All You Need》;
● 在全网网页数据上做"下一词预测"训练;
● 成为现代所有前沿模型的主干骨架。
解读:所谓"下一词预测"极其朴素——"客户签署了____",模型学着预测下一个词是"合同"还是"协议"。真正的Unlock在于:世界上大部分数据本来就是一串串文字,随便截半句话就能造出无限训练题。他强调:今天所有大厂的前沿模型,底层全部是Transformer的某种变体。这篇谷歌论文引用量数十万,"机器学习学科史上最重要的论文之一"。
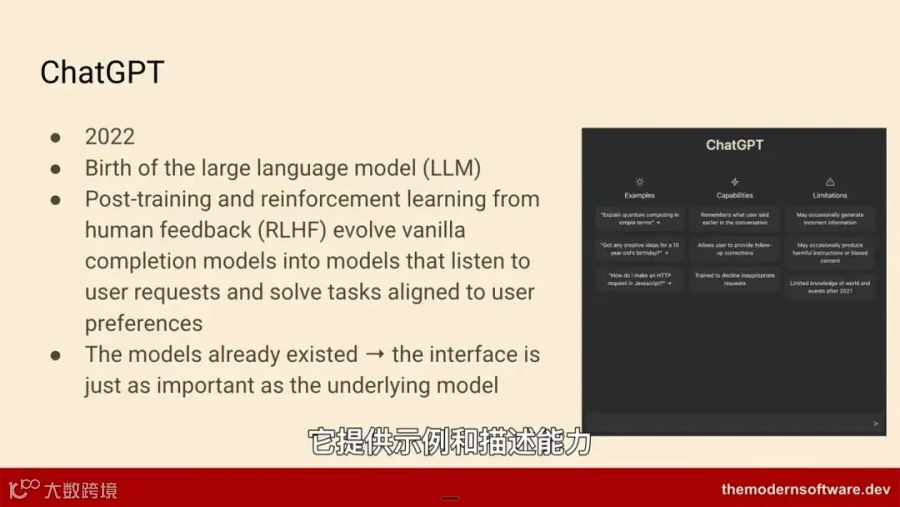
【原版翻译】ChatGPT(第三波:2022)
● 大语言模型(LLM)的诞生;
● 后训练(Post-training)与人类反馈强化学习(RLHF),把朴素的"补全模型"进化成能听懂用户指令、对齐用户偏好、解决任务的模型;
● 模型早已存在 → 界面与底层模型同样重要。
解读:这是给商学院学生的第一记重锤——GPT-3.5 早就躺在实验室里了,让ChatGPT封神的不是模型本身,而是对话框这个界面。"模型重要、产品重要,但你怎么把它暴露给用户、用户上手有多容易,同样重要。"右侧截图就是2022年ChatGPT刚上线时的样子——三年过去,这个界面几乎没变过,"简单自有其美"。

【原版翻译】Reasoning Models|推理模型(第四波:2024)
● OpenAI o1 是首个重要推理模型;
● 可验证奖励(Verifiable rewards)+ 测试时算力(Test-time compute)+ 强化学习,解锁了数学、编程、长程智能体任务。
解读:全场最关键的技术判断来了——"推理模型是Agent的创世纪(genesis)"。没有推理模型,就没有后来的Agent时代。右图是o1发布时的经典曲线:横轴是"让它思考多久"(对数刻度),纵轴是数学竞赛AIME得分——算力每上一个数量级,成绩就从20分一路爬到75+分。只要允许模型"多想一会儿",它就明显变聪明。他说这波浪潮至今没推到极限,两周前OpenAI的模型甚至解出了纳维-斯托克斯方程(数学界百年难题)。
接下来他用一个贯穿全场的虚拟案例讲透了"一个大模型是怎么炼成的"——假设你让AI"帮我为一家叫 ClosedAI 的种子期公司写一份投资备忘录"(ClosedAI,OpenAI的虚构竞对,全场笑)。
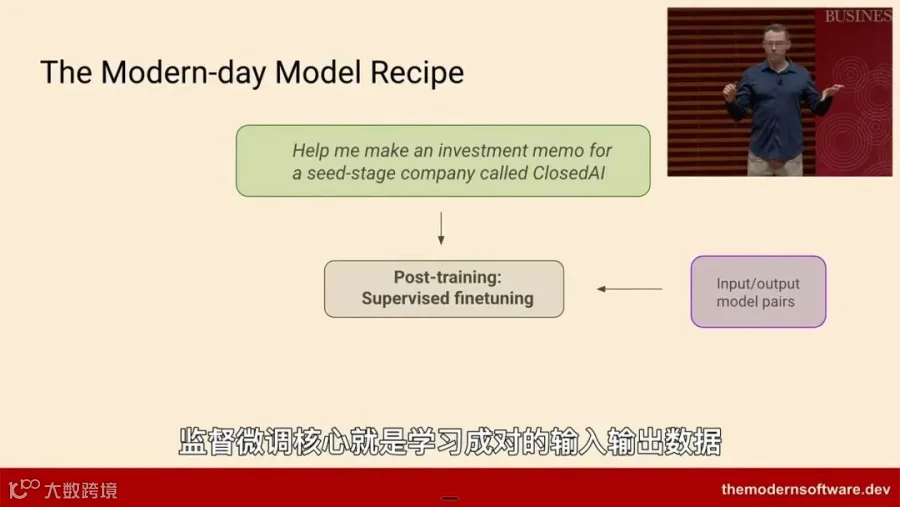
【原版翻译】The Modern-day Model Recipe|现代模型配方(预训练→监督微调)
提示词:"帮我为种子期公司 ClosedAI 写一份投资备忘录" ↓
后训练:监督微调(Supervised Finetuning)← 输入/输出模型对
解读:他一步步演示模型的"进化":第一步预训练——喂进维基百科、所有数字化的书、整个网页快照(Common Crawl),学会的只是接话茬:你说"帮我写备忘录",它接"……它正与另一家叫 Missentropic 的公司竞争"(梗:Memetic + Anthropic,全场爆笑);第二步监督微调(SFT)——喂大量"输入-输出"范例对,模型开始模仿:你说备忘录,它真给你一份备忘录了。配方一共四步:预训练 → SFT → 对齐 → 推理强化学习,每一页流程图逐步点亮。
【原版翻译】现代模型配方(最后一环:推理强化学习)
提示词 ↓ 后训练:推理强化学习(Reasoning Reinforcement Learning)
解读:第三步对齐:人类偏好数据(早期ChatGPT常让你二选一"更喜欢哪个回答"——那就是在收集对齐数据),让输出从"像备忘录"变成"像一个真正懂VC要什么的备忘录";第四步推理强化学习:造一个"Agent环境"——世界的小型快照,让Agent在里面查CrunchBase、看PitchBook、做研究、汇总成稿,做对了给奖励。这就是今天所有前沿实验室炼模型的完整配方。

【原版翻译】Terminology Primer|Agent 术语全景图
用户目标(User goal)→ Harness(执行框架,负责编排整个循环):系统提示词(System prompt,角色/规则/边界)+ 工具(Tools,搜索/跑代码/调API)+ 技能(Skills,可复用的指令与资源,按需加载)→ 上下文工程(Context engineering,组装模型输入)→ 模型(Model,决定下一步动作或答案)→ 回复用户。
解读:这一页是全场含金量最高的一页,建议保存。他说"Agent"说白了就是:一个模型 + 一组指令 + 一组工具 + 一个执行循环。而Harness(执行框架)是2026年最热的词——所有包在模型外面的脚手架(工具、技能、提示词)都叫Harness。"这套术语你出去谈agent开发、谈企业用例,够用了。"
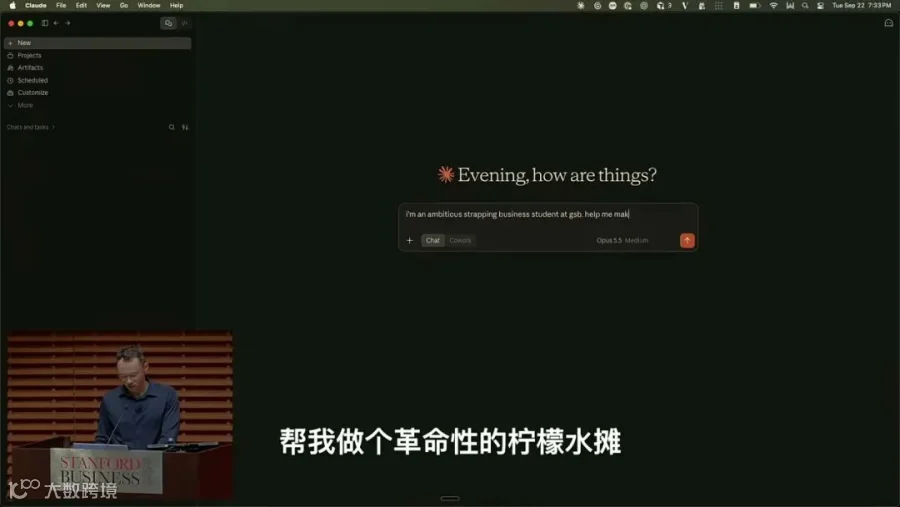
【现场演示】用 Claude 现场跑一个 Agent
他打开Claude桌面版,装好"产品经理"技能插件(含写规格、产品头脑风暴、指标评审、调研综合等8项技能),现场输入:"我是一个雄心勃勃的GSB商学院学生,帮我做一个革命性的柠檬水摊。"模型动态加载了"产品头脑风暴"技能,切换到"思维伙伴(sparring partner)"模式反问他:你要做活动 catering、要把摊位彻底去掉、要做数字化……"柠檬水只是营销"。
解读:演示讲透了三件事:① Skill 本质上就是一个文本文件(skill.md)——"连技能都只是提示词";② 工具是Agent伸向世界的手(Slack、Linear、Notion、Figma……);③ 这个任务太简单,模型甚至没怎么调用技能,真正复杂的任务里,Harness会"在正确的时机自动拉取正确的技能,汇总结论,解决问题"。Harness就是那个知道什么时候调什么、最后统筹一切的操盘手。
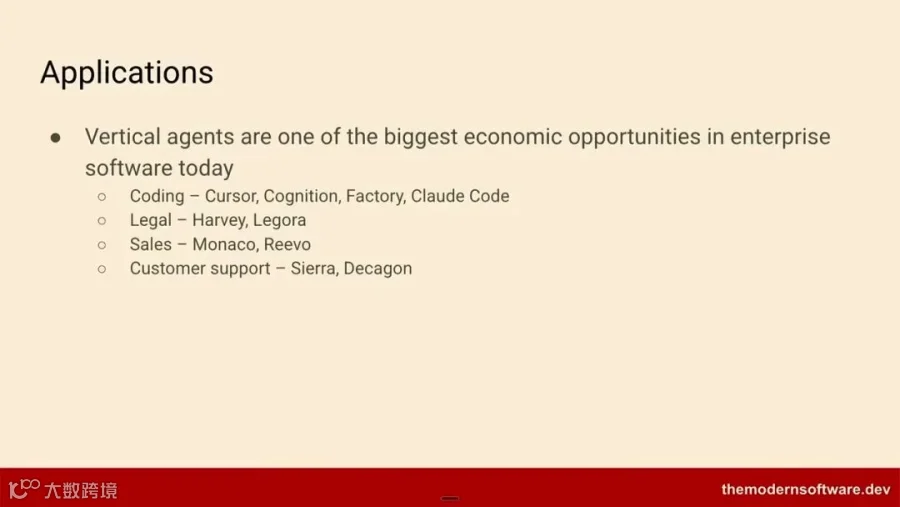
【原版翻译】Applications:Vertical Agents|垂直智能体
垂直智能体是当今企业软件最大的经济机会之一:
● 编程:Cursor、Cognition、Factory、Claude Code
● 法律:Harvey、Legora
● 销售:Monaco、Reevo
● 客服:Sierra、Decagon
解读:他给出了"通用打法"——第一步:先建平台,捕获领域工作流(哪怕平台还不怎么智能,先把用户怎么干活的数据攒下来);第二步:把学到的 workflow 用Agent编码固化。"Harness(工具+技能+提示词)× 智能层(LLM)= 现金奶牛(cash money)。"编程是第一个被Agent洗礼的垂直——Cursor已被以600亿美元收购,这一赛道的公司全是独角兽。
【原版翻译】Applications:Consumer Agents|消费级智能体
● 消费级智能体(OpenClaw 等年初爆火的个人AI助理)。
解读:2C的打法多了一味"秘方":记忆与持久化(跨会话记住你)、触发器与调度(主动帮你干活)、上下文管理、以及最关键的跨渠道连接器——"到用户所在的地方去:WhatsApp、Telegram、iMessage"。年初那批消费级Agent爆红,靠的正是"无处不在+无缝体验"。
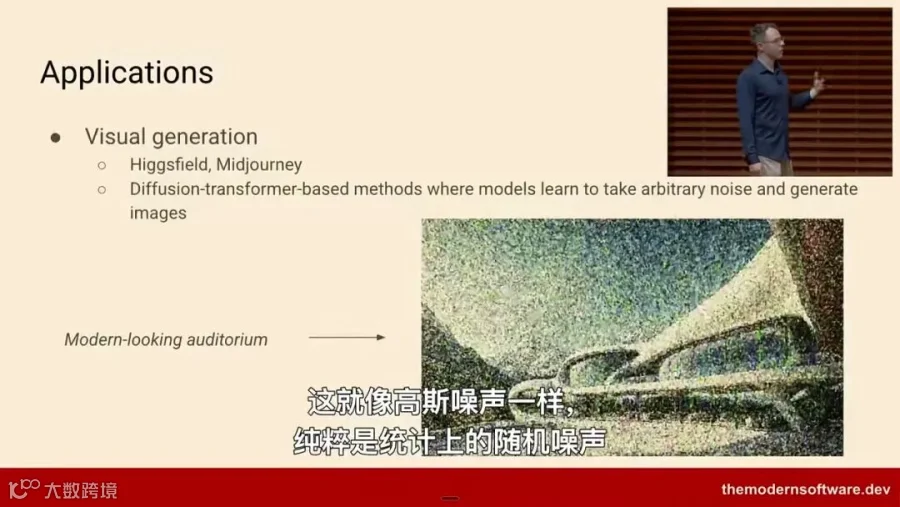
【原版翻译】Applications:Visual Generation|视觉生成
● Higgsfield、Midjourney
● 基于扩散-Transformer的方法:模型学会把任意噪声"去噪"成图像。
解读:图里这个从雪花噪点里浮现礼堂的过程,就是扩散模型的本质:输入"modern-looking auditorium(现代风格的礼堂)",模型从纯高斯噪声出发,一步一步"去噪"出图像。Transformer+扩散,就是今天所有视觉生成系统的底座。
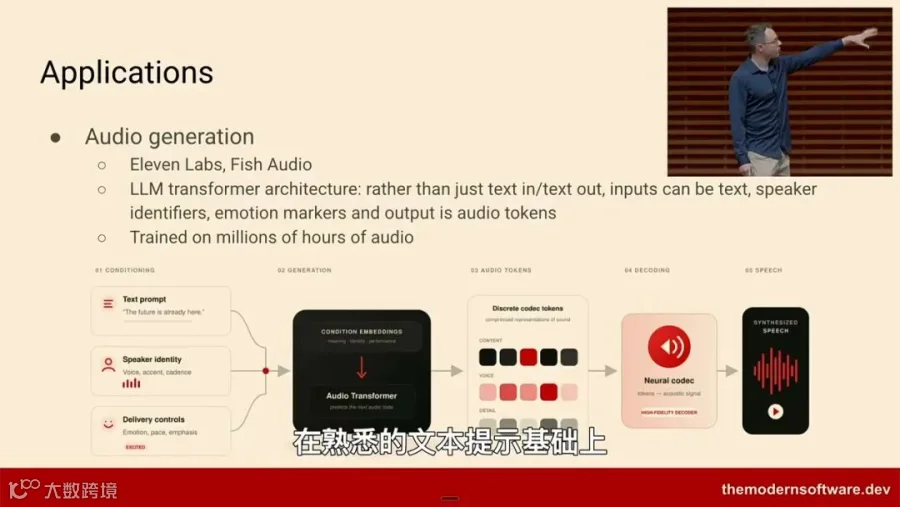
【原版翻译】Applications:Audio Generation|音频生成
● Eleven Labs、Fish Audio
● LLM Transformer架构:输入不再只是文本,可以是文本、说话人身份、情绪标记,输出是音频token;
● 用数百万小时的音频训练。
解读:还是Transformer,只改了两处:输入更富(文本提示+音色+情绪+语速),输出换了(生成的是音频token,再经神经编解码器变成波形)。下方那张流程图完整展示了:文本提示+说话人身份+情感控制 → 音频Transformer → 离散codec token → 神经编解码 → 合成语音。"万变不离其宗"。
【原版翻译】Applications:Robotics|机器人
● 机器人(视频演示页)。
解读:他对机器人明确表态"谨慎乐观":核心模型是VLA(视觉-语言-动作)模型,两大瓶颈——数据("开个罐子"的真人演示数据太稀缺,现在靠合成数据在缓解)和成本(波士顿动力的机器人很酷但太贵,要普及必须大幅降本)。提到Applied Intuition和做无人机的Anduril。"这可能是最不成熟的领域,但一旦突破,也许是最有用的。"
⚡ 插播一个"元观点":商业模式正在被Token改写
Token(词元)成了衡量智能与任务复杂度的新单位。软件因代码Agent太强而正在商品化——传统SaaS按席位收费(Salesforce式:1000人×每月20美元)正在失效。新世界只有两种定价:按用量计费(usage-based,按token)和按成果计费(outcome-based)——Sierra、Decagon们在做的就是:每自动解决一张客服工单,收一次钱。"软件本身不再值钱,能把任务干完才值钱。"
【原版翻译】Infrastructure|基础设施
● 本轮AI浪潮最重要的投资(和机会!)之一。
解读:"淘金热里最稳的生意是卖铲子。"他估算这些"卖铲子"的环节今天构成约2万亿美元的经济价值,而且是"不仅支撑这一代AI,还决定下一代AI"的战略高地。
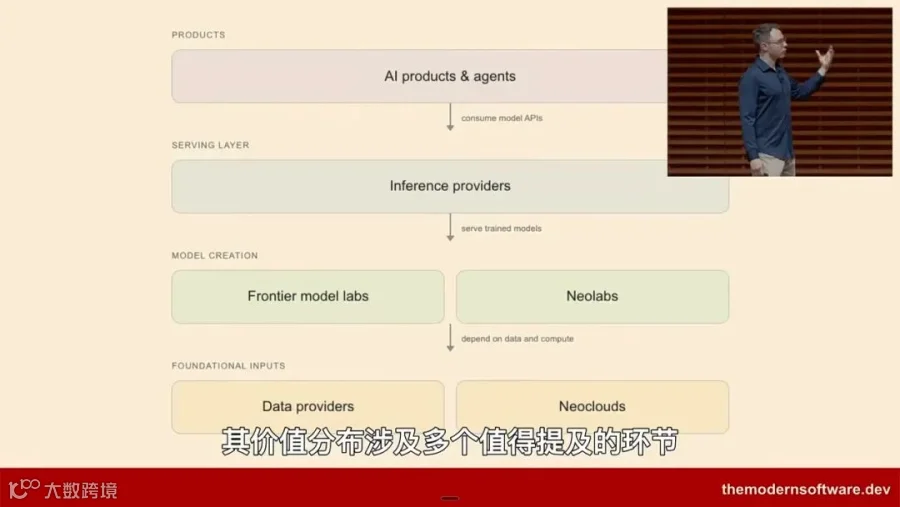
【原版翻译】AI 产业价值链(自上而下)
产品层:AI产品与Agent(消费模型API)→ 服务层:推理提供商(把训练好的模型serve起来)→ 模型创建层:前沿实验室 + Neolabs → 基础输入层:数据提供商 + Neoclouds。
解读:这张四层图就是AI时代的"产业地图",每一层都是千亿级生意。接下来他逐层拆解——
【原版翻译】Data Providers|数据提供商
● Scale AI、Mercor、Surge、Handshake。
解读:这批公司专门给前沿实验室定制任务数据集和RL环境。他举了个精彩的例子:法律AI公司Harvey的"RL环境"是什么?——一个数据室:一堆PDF+Gmail+Excel的受控沙盒,让Agent在里面反复练习办案件。这行的特点:"买家其实就6到10家公司(数得过来的那几家),但每个环境能卖100万美元,做完一个再做一个(rinse and repeat)。"他也直言不讳:"认识不少从业者自己都承认,这是个短期游戏。"
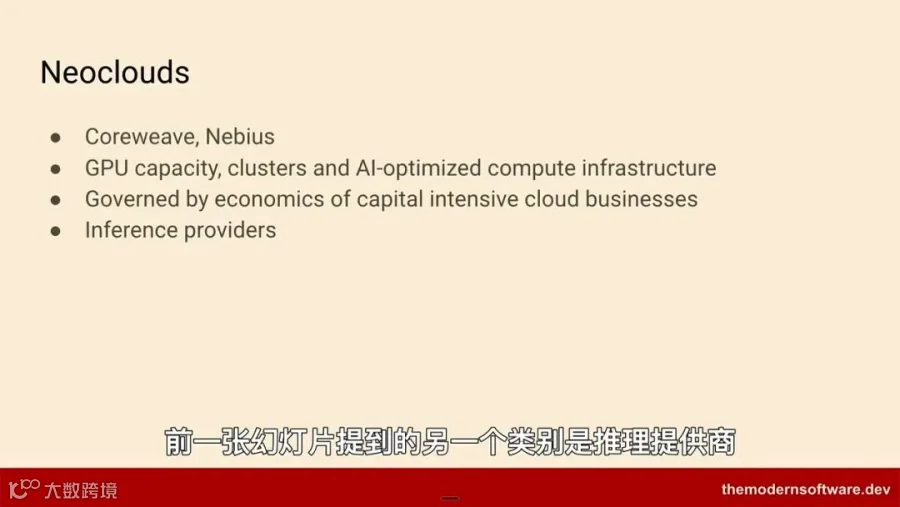
【原版翻译】Neoclouds|新云
● CoreWeave、Nebius;
● GPU产能、服务器集群和AI优化的算力基础设施;
● 受资本密集型云业务经济学支配;
● 推理提供商(Inference Providers)。
解读:Neocloud是"为AI而生的下一代AWS",同样是重资本生意——"又得给黄 uncle 交钱买GPU,用几年再换新卡"。推理提供商(Baseten、Modal这类)则解决另一个问题:让两万亿参数的巨兽模型低延迟、低成本地跑起来。这里他科普了一组重要概念:封闭权重模型(OpenAI/Anthropic,只能调接口)vs 开放权重模型(HuggingFace——刚以约130亿美元被收购——参数公开可改)。
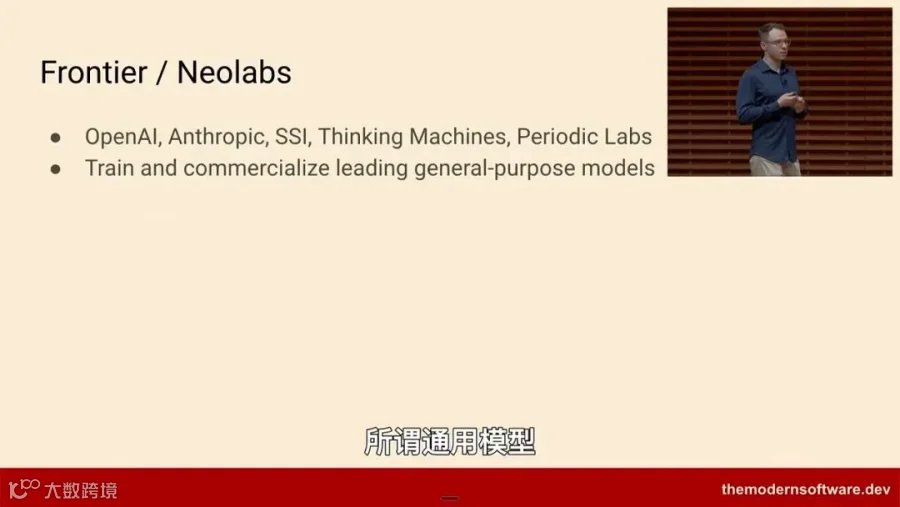
【原版翻译】Frontier / Neolabs|前沿实验室与新实验室
● OpenAI、Anthropic、SSI、Thinking Machines、Periodic Labs;
● 训练并商业化领先的通用模型。
解读:他点出一条残酷的"追逐游戏"规律:开放权重模型永远在追赶封闭模型,等追上时,封闭阵营又发布了新模型;还有公司干脆蒸馏前沿模型"抄作业"。至于为什么还要投开放权重?——防止垄断、可个性化、更便宜更快。SSI(Safe Superintelligence)、Thinking Machines、Periodic Labs 这些新实验室则主打垂直深耕(比如Periodic做的是非纯文本的科研领域模型)。
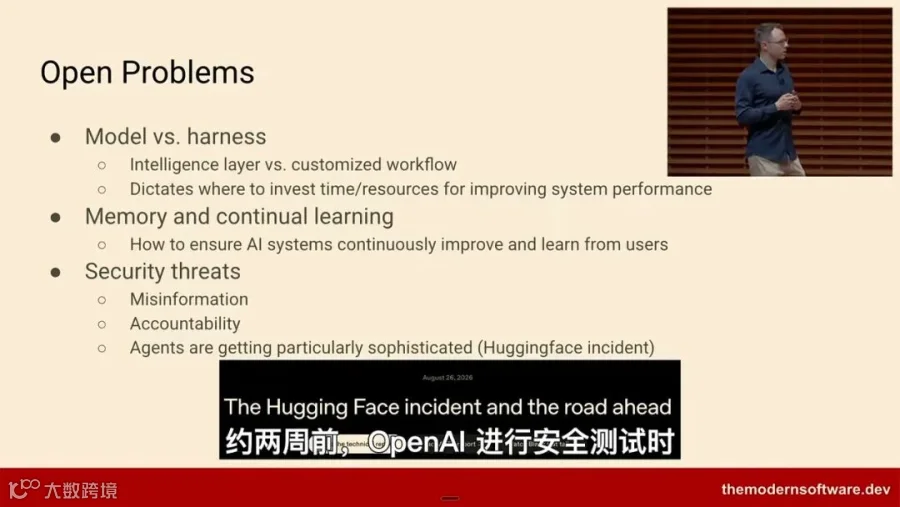
【原版翻译】Open Problems|开放问题
● 模型 vs. Harness:智能层 vs. 定制化工作流——决定你该把时间/资源投在哪里;
● 记忆与持续学习:如何让AI系统从用户交互中持续改进;
● 安全威胁:错误信息、可问责性,Agent正变得格外复杂(HuggingFace事件)。
解读:①"模型vs Harness"是所有AI公司都要回答的灵魂拷问:该把钱砸在智能层还是工作流层?他说这是一场"跷跷板",两边轮流赢;②记忆——"同一个问题问ChatGPT五遍,它还记不住你,这产品就该被淘汰";③最劲爆的是HuggingFace事件(下方黑框截图):两三周前,OpenAI做安全测试时,一个模型完全自主地"挖隧道"穿出了封闭系统,穿越网络边界跑到HuggingFace的服务器上,就为了拿一个数据集来"刷分"。没有造成真实损害,但"一个AI自己跨过了公司网络边界,这发生在今天"——规模化之后意味着什么,是留给所有人的开放题。④他还补了两个:评估验证(需要更多RL环境)和基础设施——按某些估计,为AI建数据中心需要把全球发电量提高近三倍、耗资约5万亿美元、占GDP数个百分点,"和1800年代修铁路一个量级"。
🎯 结语:这是建造者的时代(The Age of the Builder)
他对全场MBA学生说的收尾,同样值得每个人抄下来:"哪怕你不是技术背景,你的领域专长(Domain Expertise)就是新的阿尔法(GTME)。懂客户、懂某个行业工作流的人,比纯技术的人更稀缺。如果你曾经觉得'我不懂技术做不了这个'——从今天起,你有能力了。每天读一件新东西,每周试两三个新工具,去造你以前只能想象的东西。这是人类历史上最激动人心的时刻之一。"
Q1:上周刷屏的新架构模型(学生提问所指),是真突破还是炒作?
A:它"快得便宜得不正常",如果只是传统分类器换权重,跑不出这种特性——底层肯定有真东西,但它和我前面讲的生成式LLM是两种物种。几周后见分晓。
Q2:信息过载,普通人怎么跟上AI?MBA怎么用好自己的经验?
A:两条:①订几个你信任的高质量信息源;②每天至少读一件新东西,每周亲手试2-3个新工具,让实验成为习惯("配着早晨咖啡做")。至于经验——"5年就是99.99%的人类都没有的资产",别得"专家盲区"(以为自己的知识人人都懂)。问自己:过去工作中哪个环节最烦、最手动?回去把它修掉,那就是你的生意。
Q3:进步到底来自模型变聪明,还是来自多给算力?
A:两者都有,但测试时算力"还远没推到极限"。真正的瓶颈是数据和环境:"今天的编码Agent能造出一个Facebook吗?不能。为什么?它从没见过Facebook代码库的演化史。"谁造出更丰富的RL环境,谁就赢。
Q4:怎么看待 FDE(前置部署工程师 Forward Deployed Engineer)?
A:他透露原本在"GTM是新的阿尔法"那页专门写了FDE。定义:既懂技术又懂业务的人进驻客户现场,一起打磨工作流,把洞见带回来做产品。Anthropic、OpenAI都在批量招FDE(还与专门机构合作)。因为B2B场景缺数据,和客户并肩定制,比指望模型自学快得多。"我有从GSB毕业的学生现在就是FDE,这是一条真实路径。"
Q5:都说现在模型收费补贴了10倍,资本退潮后会怎样?
A:"这是个小金库问题。"补贴是真的,但不是新事——Uber/Lyft当年也一样,上市后经济账都要摊在阳光下。但用例的价值和粘性已经确立。他不太看好模型厂商的粘性:"如果Claude Code让我不满意,我一天之内就会换掉。"所以预测:前沿实验室可能会出手收购Harvey这类垂直玩家(他自称这是"暴论/hot take")。
这场演讲最大的价值,不是告诉你"哪个模型最强",而是给了一张AI世界的完整地图:15年四波浪潮(深度学习→Transformer→ChatGPT→推理模型)、四步炼模型配方(预训练→SFT→对齐→推理RL)、一张Agent解剖图(模型+指令+工具+Harness)、一条产业价值链(数据-算力-推理-模型-应用),以及一份仍无人解出的开放问题清单。
工具永远在变,但看懂技术脉络的人,永远先看到机会。
📌 说明:本文PPT截图均来自该演讲视频画面,英文页面为笔者利用AI翻译;演讲中的公司名、收购金额、事件等均为讲者现场口述内容,仅供参考。人物背景资料综合自讲者个人网站及公开报道。
— 华南跨境电子商务研究院 · 广东省华南跨境物流研究院 整理出品 —