


让同一个模型把一道题做十遍,取十个答案里大家都同意的那个,看着最稳。剑桥大学和 Google Cloud AI Research 在 10 月 1 日挂出的这篇 VeriHarness 却发现,这些一致的答案里,约三分之一对照评分标准是错的。论文要解决的就是这种场景下怎么检查,生成答案和检查答案用的是同一个模型,测试时又拿不到标准答案。
红框圈出的是标题里的关键词 Agentic Verification,以及作者机构那一行,剑桥大学与 Google Cloud AI Research。一作 Caiqi Zhang 是在 Google 实习期间完成的这项工作。
大家都同意的答案,不一定对
有一个反直觉的数字。
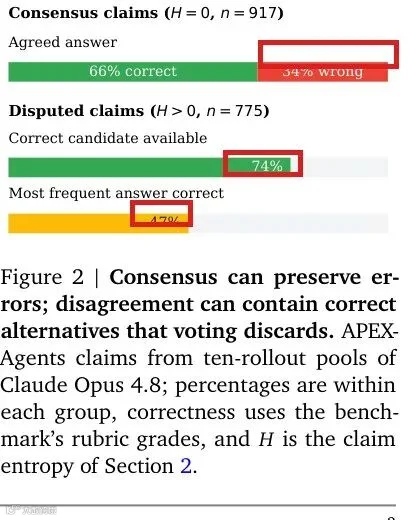
在 APEX-Agents 上,用 Claude Opus 4.8 对同一道题采样十个 rollout,把十个答案里大家一致给出的结论拿出来对照评分标准,约 34% 是错的。反过来,在十个答案出现分歧的那些结论里,74% 至少有一个候选是对的,但投票最常选出的那个答案,正确率只有 47%。
多数投票、self-consistency、让模型给候选打分的 LLM-as-a-judge,这些常见的测试时校验方法,用的信息只有候选本身,本质是在问模型"你自己觉得哪个对"。上面两个数字说明,这条路在长程任务上有天花板,一致不等于正确,分歧里反而常常有对的答案。
问题设定,没有更强的裁判,也没有标准答案
VeriHarness 面对的是一个很具体的场景。生成器和校验器是同一个模型、同一套工具,测试时拿不到参考答案,也拿不到评分细则。这贴近前沿的实际处境,生成端已经是能拿到的模型,背后没有一个更强的模型来监督它。把基座模型固定住,也保证了校验带来的任何提升都来自模型自己的 rollout 和环境,而不是引入了一个更强的模型。
在这个设定下,校验器手里只有两类信息。一类是同一道题反复采样出来的候选池,另一类是任务环境本身,也就是源文件、数据和约束条件。作者的核心主张是把校验带进环境,让每一条结论去和环境证据对质。
VeriHarness 怎么工作
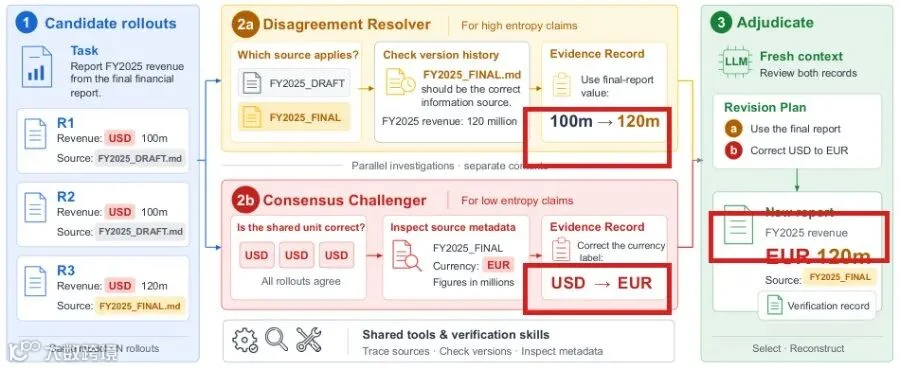
方法的名字点明了思路。给智能体套一层 harness,模型才能干活,VeriHarness 把这层结构搬到校验端,给同一个模型配一个工作区、一批取证据的工具,以及一套可复用的校验技能,让它从生成者变成带工具的校验者。
它把校验拆成两个互补的任务,在两个独立的上下文里并行做。
分歧裁决器(disagreement resolver) 处理候选之间有分歧的结论。它把冲突的数值追到各自的来源和计算过程,挑一个最能区分候选的检查去做,跑完把被证据否掉的候选排除掉。图里那道题问 FY2025 营收,两个 rollout 引用草稿给出 100m,一个引用终稿给出 120m,裁决器查版本历史,确认终稿覆盖草稿,把 100m 改成 120m。
共识质疑器(consensus challenger) 处理十个答案都一致的结论。没有对立候选可测,它就先设想这个共识可能错在哪,再去环境里验证。同一道例子里,三个 rollout 都把货币标成 USD,质疑器去查源文件元数据,发现应该是 EUR。它还会专门核对任务要求里被所有 rollout 一起漏掉的部分。
最后一步是裁决(adjudicate)。在一个干净的新上下文里,同一个模型读两份证据记录,决定保留、推翻,或者标记为尚未解决,产出一个基准 rollout 和一份带证据的修改计划,交付时把修改落到产物上,并附一份逐条记录,里面是 claim、check、evidence、verdict 四样东西。
结果
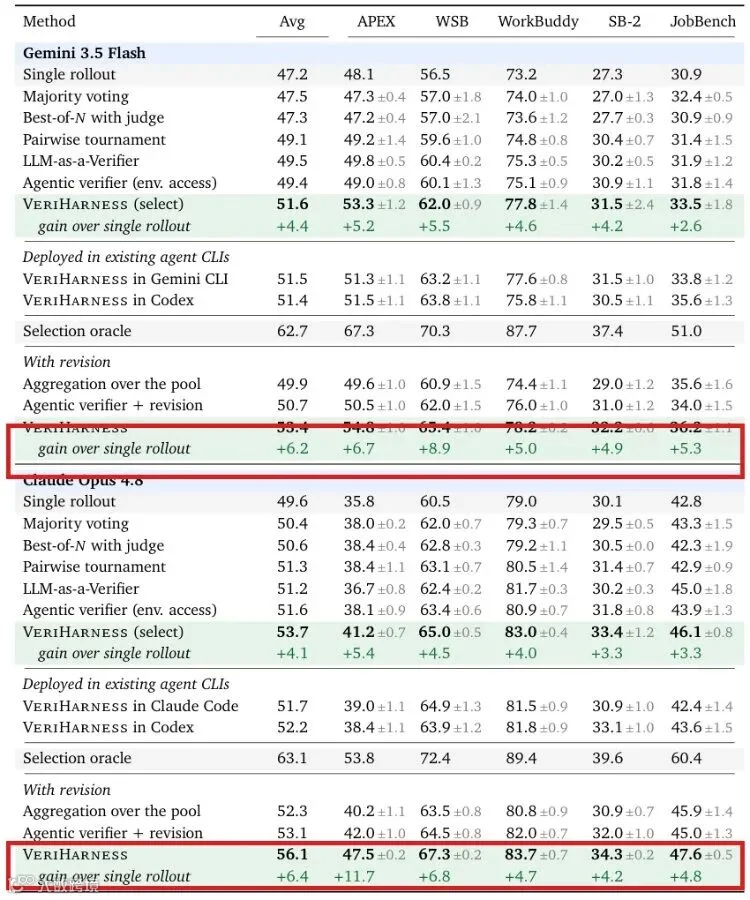
在五个长程工作区基准(APEX-Agents、Workspace-Bench Lite、WorkBuddy Bench、SpreadsheetBench 2、JobBench)上,用 Gemini 3.5 Flash 和 Claude Opus 4.8 各跑一遍,每道题固定十个 rollout,所有方法拿到的候选池一样。
只看选择,VeriHarness 在十个"模型×基准"组合里都超过了被测基线,相对单次 rollout 的平均提升是 4.4 分(Flash)和 4.1 分(Opus)。加上带证据的修改这一遍,平均提升涨到 6.2 分(Flash)和 6.4 分(Opus)。单项增益最大的一处出现在 Opus 的 APEX-Agents,从 35.8 涨到 47.5。
有两个对照很关键。给同样的环境访问权限、但不套这套协议和技能的 agentic verifier,只拿到大约一半的增益,说明光能进环境不够,怎么查、查什么才是重点。把这套协议搬进 Gemini CLI、Claude Code、Codex 这些现成的智能体外壳里,大部分选择增益还在,说明它不绑定某一个实现。
技能库能靠失败反馈自我扩充
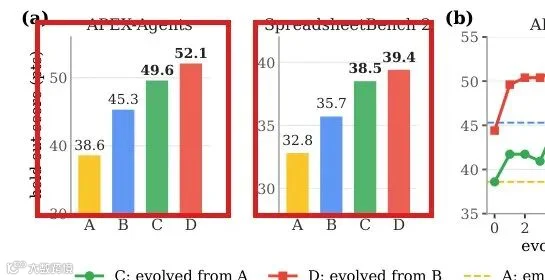
作者还问了一个更进一步的问题,模型和协议都不动,只让校验器从开发集的失败里改进技能库。把每个基准按约 3 比 1 分成开发集和留出测试集,每轮读失败样本和逐条评分反馈,提出候选技能库,开发分更高才替换。留出集每轮记分,但从不参与选择。
四种条件对比下来,从空库进化出来的技能库 C,在 APEX-Agents 上比空库 A 高 11.0 分,也比人工写的库 B 高。从人工库 B 继续进化的 D 分数最高,在 APEX-Agents 上比 B 再加 6.8 分。人工写的技能是个好起点,能更快收敛到更高分数。进化出来的技能也更具体,九十五条检查里,48 条把人工的泛化检查落成了带脚本、常量或文档类型的操作,42 条是全新的。
几点分析
增益主要来自候选有分歧的题目。按候选池的结论熵分组,在 154 个完全一致的池子上,VeriHarness 的选择分只比池均值高 0.6 分,在 262 个有分歧的池子上高 6.1 分,分歧越大增益越高。
共识质疑器整体安全,它没有推翻过任何一个所有 rollout 都答对的结论。它漏掉的共享错误,大约七成是查了一个正确的中间结果,而错误在后面的步骤里。模型倾向于停在 rollout 停下的地方,要它往别处看,靠的是技能库提供的先验。
VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
剑桥大学 · Google Cloud AI Research
arXiv 2610.00972 · veriharness.com
开源约 26,000 条 rollouts(五个基准 × 两个模型,成本超过 10 万美元)
把校验从"读一遍候选打个分"改成"带着工具去环境里逐条对质",是这篇最实的贡献。它不需要训练,不依赖某个更强的裁判,能直接插到现有智能体流程上。在长程任务普遍缺可执行测试的现状下,这条路线比再造一个奖励模型更容易落地。
边界也写得清楚。结果建立在每道题十个 rollout 的预算上,这是测试时扩展的标准开销,代价是校验本身要多花时间,作者把它定位在报告、表格、补丁这类更看重质量而非响应速度的产物上。它只研究校验器和生成器同模型的情形,换一个更强的裁判或许还能涨,但那会把 harness 的功劳和模型能力差距混在一起。它交付的是产物加一份逐条记录,不给单个 rollout 打一个标量分,把这份记录变成能监督生成端的训练信号,是作者留下的下一步。
同一个模型能否靠自己发现并纠正自己的错误,此前有几篇工作给了偏悲观的答案,比如没有外部反馈就难以自我纠错、自检多半是确认性的、同族模型的错误高度相关。VeriHarness 给出的回应是,把候选之间的分歧和共识当成检查目标,把环境证据当成裁判,能在不动权重的前提下把校验能力往上提一档。这个方向是否值得跟进,取决于手上是否有值得逐条核对的长程产物。