

导读AI 能参与研发下一代 AI,是否会越改越快?Hinton 等人的新论文提出了这个大问题。另一篇 RRSI 论文把视线拉到今天已经能测试的 Agent 系统:让它反复修改提示词、工具和流程,旧任务的分数可能上涨,但新任务未必受益。本文用 RRSI 最新版本的机制与消融实验,解释怎样区分可迁移的改进、对测试题的适应,以及为涨分付出的额外成本。
本文 2168 字,阅读约 5 分钟|自我改进,先要问“进步”怎么算 → Agent 改的不是模型权重,而是“怎么工作” → RRSI 给“怎么改”和“留不留”分别设关卡 → 最反直觉的结果 → 它回答了什么,还没回答什么
自我改进,先要问“进步”怎么算
2026 年 9 月 28 日,Geoffrey Hinton 等 22 位作者公开论文,讨论 AI 逐步自动化 AI 研发后,进展是否可能形成自我加速。论文把这种“智能爆炸”作为有条件、仍有大量不确定性的可能性,并没有宣告它已经发生。
两篇论文研究的层级不同。Hinton 等人讨论的是整个 AI 研发流程可能怎样加速;另一些研究则已经在实验中让 Agent 根据执行反馈修改自己的工作方式。可它下一轮得分更高,到底是找到了一种对新任务也有效的方法,还是越来越会做反复见过的题?
9 月 21 日首次提交、10 月 4 日更新到 v3 的 RRSI 论文,专门研究后一个问题。RRSI 全称是 Regularized Recursive Self-Improvement of Agent Harnesses,可以理解为给 Agent 工作流程的递归改进加约束。它提供了一个很值得记住的判断:自我修改能持续发生,只说明循环跑起来了;未见任务上的收益,是判断修改是否有用的更强证据。
OpenAI 报告、Seed 三项研究公开:RSI 热起来了,但六个项目在补三种不同的环
Agent 改的不是模型权重,而是“怎么工作”
先把对象说清楚。这里的 Agent 由一个保持不变的底座模型,加上围绕模型运行的 Harness 组成。Harness 包括提示词、工具接口、何时规划或停止的控制流程、记忆与上下文管理。它决定模型接到任务后先看什么、什么时候调用工具、失败后如何继续。
RRSI 的每组实验都固定底座模型,不更新模型权重。一轮改进大致这样发生:当前 Agent 在一批任务上运行,留下执行过程和分数;负责提出修改的模型根据反馈,改动 Harness 的一部分;候选版本再跑任务;系统决定是否用它取代当前版本。下一轮又从留下的版本出发。
问题出在反馈的使用方式上:如果每一轮都围着有限的一批任务修改和打分,系统会逐渐适应这批题目的表述、工具细节或评分方式。它可能加进一大段专门应付这些任务的规则,也可能只是消耗更多 token、多试几步,终于把旧题做对。旧题得分、未见任务表现和运行成本,是三个需要分开看的量。
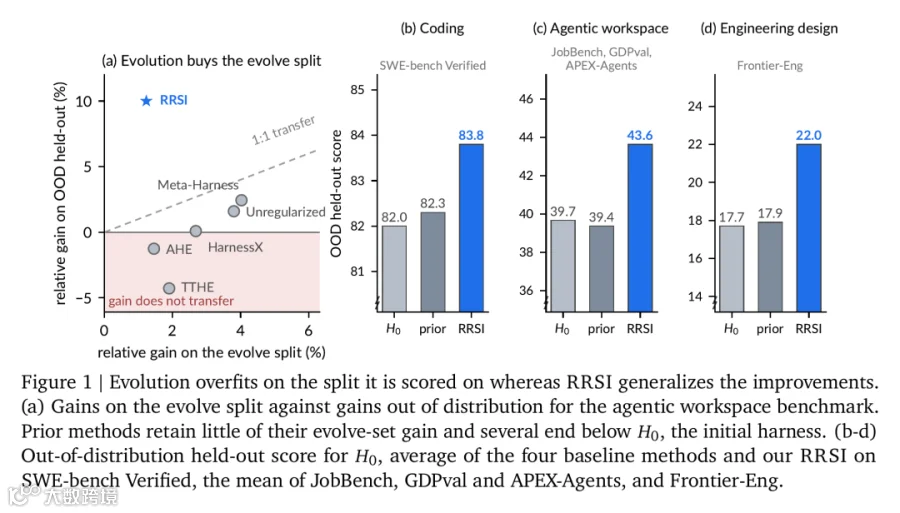 图片说明:论文图 1 中,左侧比较“反复用于改进的任务”和未见任务的相对增益;右侧分别展示代码、文档工作与工程设计任务的未见评测结果。灰色是起始 Harness 或其他方法的平均结果,蓝色是 RRSI;这些是论文设定下的实验成绩。图片来源:RRSI 论文作者
RRSI 给“怎么改”和“留不留”分别设关卡
RRSI 没有把 Harness 的可编辑部位锁死。它约束的是搜索过程:候选怎样提出,以及得分变化怎样决定下一轮保留哪个版本。
提出候选时,早期可以尝试较宽的组合;轮次往后,一次允许捆在一起的修改逐渐减少。这样做有一个实际好处:如果同时重写提示词、增加记忆、换工具流程,分数变了也很难判断是哪一步起作用。少量、可归因的修改,更容易从反馈中学习。系统还会记录过去改过什么、哪些尝试有效;进展停滞时,转向尚未充分探索的组件,而不是反复押注同一条路。
候选提出后也不会因为“比上一轮高一点”就自动留下。论文设置了几道筛选:先检查是否写入了针对演化任务集的特殊逻辑;再用重复评测估计噪声,避免把微小波动当成确定收益;如果修改使每次运行消耗更多 token,就要求收益足以支付这笔成本;长期没有正面贡献的组件会成为后续删除的目标。
这并不是保证每次修改都正确,而是降低一类常见误判:把偶然涨分、记住题目或堆计算量,误认成可以长期保留的能力。
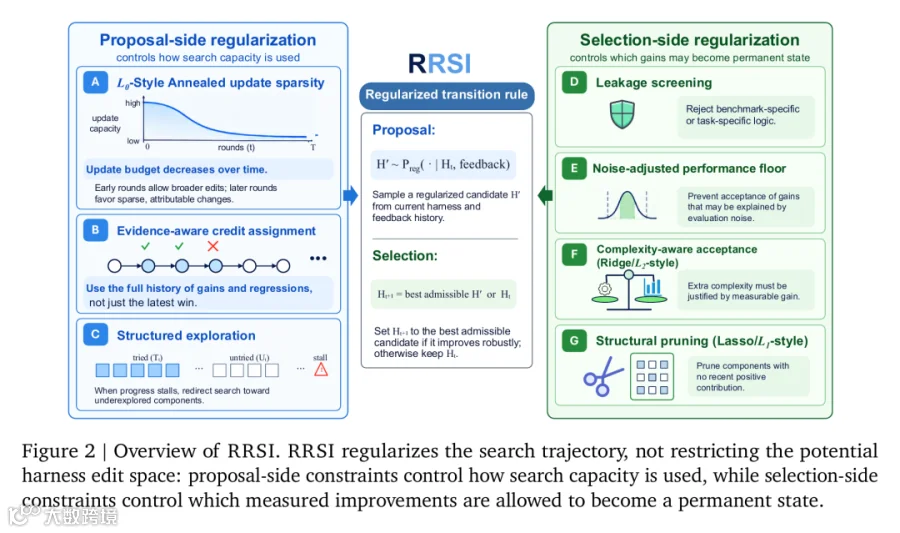 图片说明:论文图 2 左侧是候选修改的提出方式,右侧是候选能否留下的筛选规则;中间表示每轮可选择新候选,也可以保留原版本。图中“正则化”约束的是修改路径和采纳标准,不是禁止修改某种 Harness 组件。图片来源:RRSI 论文作者
最反直觉的结果:旧题少拿分,新题反而更好
论文 v3 的一组消融实验很直观。研究者在同一套 Harvey LAB 工作任务上演化 Harness,再到三套没有参与演化的任务——JobBench、GDPval 和 APEX-Agents——检查迁移,并统计每次试验消耗的模型 token。以下数字是论文报告的同条件实验结果,不是线上业务成功率。
 图片说明:论文表 2 从左到右列出参与演化的任务得分、同分布留出任务得分、三套未见任务的平均分,以及每次试验消耗的百万 token。对照未加约束演化与 RRSI 两行,可以同时检查旧题、迁移和成本;表中其余两行展示分别移除提案约束或筛选约束后的结果。图片来源:RRSI 论文作者
未加约束的演化方法,在反复使用的任务上拿到 92.8 分;RRSI 是 90.5 分。只看这栏,前者似乎更好。但三套未见任务的平均分,前者是 40.3,RRSI 是 43.6;每次试验的 token 消耗分别约为 380 万和 242 万。作为参照,完全不演化的起始 Harness 在旧题上是 89.4、未见任务平均 39.7,每次试验约用 156 万 token。
表中另外两行解释了为什么两端都要约束:单独去掉“如何提出修改”的规则,未见任务平均分从 43.6 降到 41.9;单独去掉“哪些修改留下”的规则,降到 41.0,token 消耗也从每次约 242 万升至 359 万。更高的旧题得分,没有自动带来更好的迁移。
这里不能简单说“RRSI 用最少成本拿最高分”:起始版本更省 token,只是表现也更低。更准确的结论是,在这组对照中,RRSI 放弃了一部分旧题涨分,换来了更好的未见任务表现,并比无约束演化少花了推理 token。它在“新增能力”和“为能力付出的运行成本”之间,做了更有用的取舍。
这也解释了为什么单看一次 Benchmark 涨分很容易误判。若一个修改只在反复参与筛选的任务上有效,或主要靠更长的上下文、多轮调用换分,最终部署到新任务时,预期收益可能缩水,成本却已经留下。
它回答了什么,还没回答什么
RRSI 回答的是 固定模型下,Agent 工作流程的修改怎样更可能跨任务保留收益。论文在代码、工作任务和工程设计的基准上报告了迁移结果;图和消融实验支持“筛选过程会影响泛化与成本”这一有限结论。Harvey LAB、JobBench 和 GDPval 的成绩由模型评判,因此不能只靠这些分数排除迎合评判模型的可能;论文另在采用模拟器或测试程序评分的工程设计任务上报告了迁移收益。
但它没有验证“AI 已能自动研发出更强的下一代模型”。论文附录也写明:研究没有更新底座模型权重,仍依赖有限的演化任务和人为设定的约束参数;换到差异更大的 Agent 架构、工具生态或更长时间的自我改进过程,还需要进一步验证。
所以,把 Hinton 等人的论文和 RRSI 放在一起看,最有价值的并非得出“智能爆炸已近”的结论,而是把宏观问题拆出一个今天就能测的环节:每一轮所谓改进,都要问它是否经得住新任务、评测波动和运行成本的检验。闭环能跑,是起点;收益能迁移,才是下一步值得相信的证据。
参考资料
• RRSI 论文(arXiv v3): https://arxiv.org/abs/2609.24972
• Hinton 等人关于 AI 研发自动化的论文: https://arxiv.org/abs/2609.36054
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!