


目录
一、引言
二、eval 函数全表
三、完整调度顺序
四、五层循环的意义
五、调度框架的复用
六、边沿检测:eval_act 的核心
七、always 块在哪个 eval
八、阻塞赋值 vs 非阻塞赋值
九、各 eval 区域的实例对照
十、两套调度模型
十一、性能特征
十二、总结
一、引言 📖
Verilator 把 Verilog 编译成 C++ 时,不是把所有逻辑塞进一个大函数,而是按照 IEEE 1800 SystemVerilog 标准的分层事件队列,把仿真调度拆成多个区域。每个区域对应一个 eval_* 函数。
这套机制的存在,是为了精确模拟 SystemVerilog 的调度语义:组合逻辑要迭代到稳定,非阻塞赋值要延迟提交,断言要在特定区域采样。没有这些区域,仿真结果就会和标准仿真器不一致。

二、eval 函数全表 📋
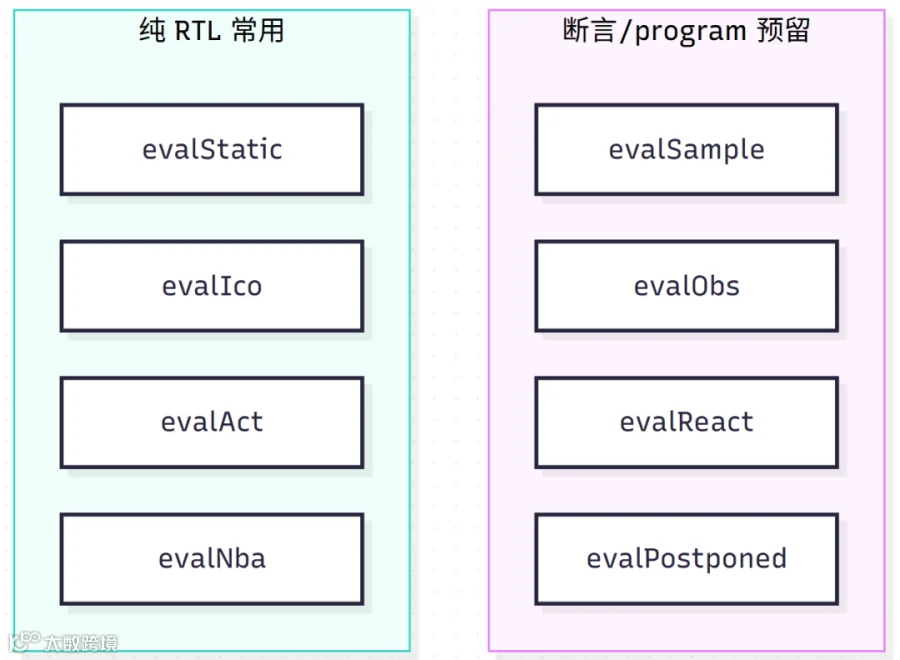
Verilator 生成的模块类里,每个 eval_* 函数对应一个调度区域:
纯 RTL 设计通常只用到 evalStatic、evalIco、evalAct、evalNba 四个,其余是给断言和 program 块预留的空壳。
三、完整调度顺序 🗓️
Verilator 5.x 的调度逻辑封装在 VlEvalLoop::evalImpl() 里,所有模块共用这一份通用代码:
   void VerilatedEvalLoop::evalImpl() {
    m_model.evalBegin();

    // 一次性初始化
    if (!m_didInit) {
        m_model.evalStatic();
        m_model.evalInitial();
        do { checkConvergence(...); }
        while (m_model.evalStl(firstIteration));
        m_didInit = true;
    }

    // 采样(每次 eval)
    m_model.evalSample();

    // 输入组合逻辑循环
    do { checkConvergence(...); }
    while (m_model.evalIco(firstIteration));

    // 五层嵌套事件循环
    do {                                    // React
        do {                                // Observed
            do {                            // NBA
                do {                        // Inactive
                    do {                    // Active
                        checkConvergence(...);
                    } while (m_model.evalAct());
                } while (m_model.evalInact());
            } while (m_model.evalNba());
        } while (m_model.evalObs());
    } while (m_model.evalReact());

    // 时间步末尾
    m_model.evalPostponed();
    m_model.evalEnd();
}
三层结构

四、五层循环的意义 🔄
五层循环是 IEEE 1800 分层事件队列的直接实现:

嵌套而不是顺序,是因为每个区域的副作用会触发更内层的区域:
-
• Active 触发 NBA:阻塞赋值可能改变寄存器输入 -
• NBA 触发 Active:寄存器更新后组合逻辑要重算 -
• NBA 触发 Observed:寄存器变化触发断言 -
• Observed 触发 Reactive:断言触发 program块 -
• Reactive 触发 Active: program块的赋值又回到 Active
所以外层每迭代一次,都要重跑所有内层,直到全部收敛。
收敛条件
每层循环的退出条件是 eval_X()返回 false:
-
• evalAct返回true→ 还有 Active 工作,继续循环 -
• evalAct返回false→ Active 稳定,跳出 -
• 五层全部返回 false→ 整个evalImpl结束
checkConvergence 设置上限(默认 10000 次),防止真正的死循环。
五、调度框架的复用 🏗️
每个模块的 eval_step() 只有一行:
   void Vfp_adder::eval_step() {
    VL_DEBUG_IF(...);
    m_evalLoop.eval();     // ← 所有调度在这
}
调度顺序是通用的,Verilator 5.x 把它封装在 VlEvalLoop 里。每个模块类通过虚函数实现 evalAct / evalNba / evalIco 等钩子。
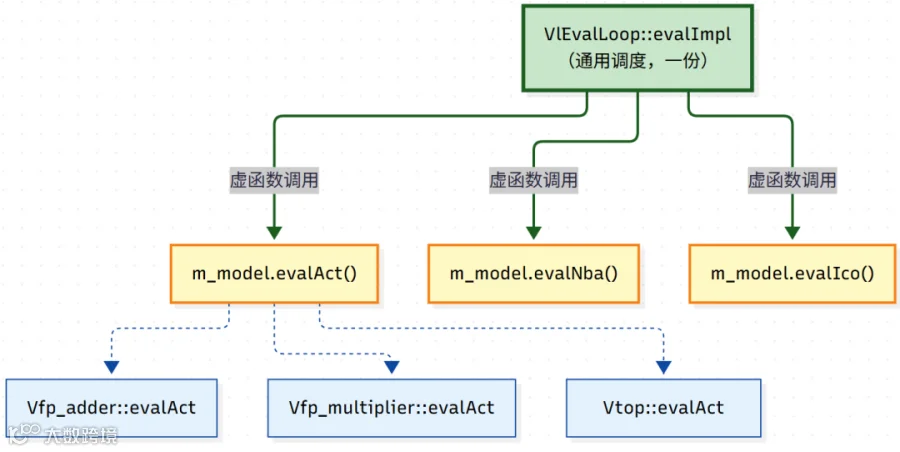
VerilatedModel 里定义纯虚函数,每个模块类重写它们。这就是 evalBegin / evalNba 声明里全是 override final 的原因。
框架复用,逻辑各异——这是 Verilator 5.x 相比 4.x 的重要改进。
六、边沿检测:eval_act 的核心 🔍
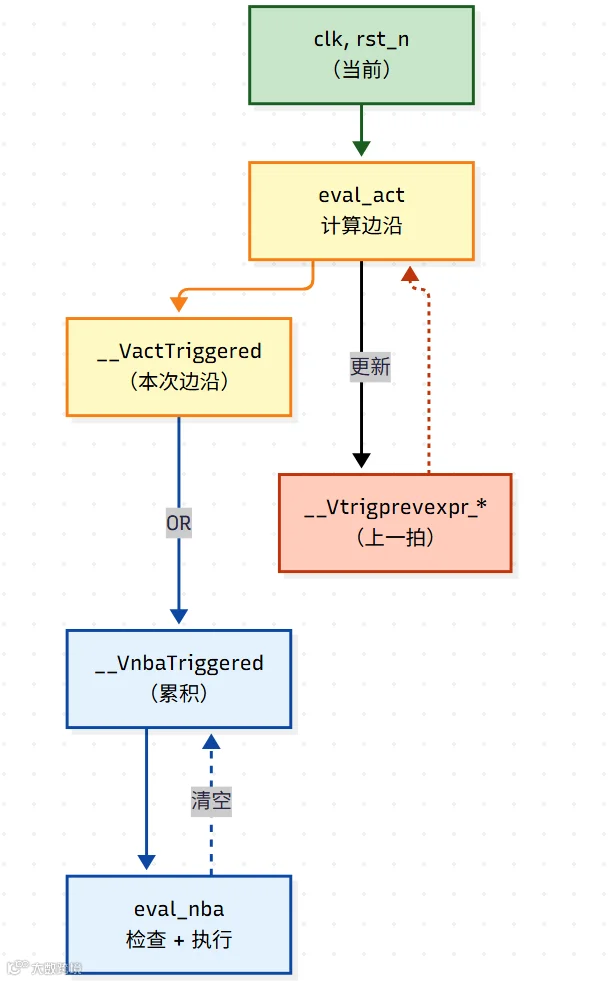
posedge clk / negedge rst_n 的检测在 eval_act 里完成:
   bool Vfp_adder___024root___eval_act(Vfp_adder___024root* vlSelf) {
    vlSelfRef.__VactTriggered[0] =
        (((~rst_n) & __Vtrigprevexpr_rst_n) << 1)   // negedge rst_n
      | ((clk & ~__Vtrigprevexpr_clk) << 0);        // posedge clk

    vlSelfRef.__Vtrigprevexpr_clk   = clk;
    vlSelfRef.__Vtrigprevexpr_rst_n = rst_n;

    trigger_orInto__act_vec_vec(__VnbaTriggered, __VactTriggered);
    return 0;
}
两个触发变量
firstIteration 参数
eval_ico(firstIteration) 和 eval_stl(firstIteration) 带一个布尔参数:
-
• 第一次迭代: true—— 强制所有触发位置位,让所有逻辑至少跑一遍 -
• 后续迭代: false—— 只处理新增触发
这是为了区分"初始化"和"增量更新"。
七、always 块在哪个 eval 📦
always 块的逻辑分散在多个 eval 函数里,取决于敏感列表:
时序逻辑拆两半
   always @(posedge clk or posedge rst) begin
    if (rst) i <= 0;
    else     i <= i + 1;
end
边沿检测在 eval_act:
__VactTriggered[0] = (clk & ~clk_prev) | ((~rst) & rst_prev) << 1;
块内逻辑在 eval_nba → nba_sequent__TOP__0:
   if (rst) __Vdly__i = 0;
else     __Vdly__i = i + 1;
i = __Vdly__i;

拆两半的意义:在没有边沿的周期里,eval_nba 直接返回 false,不进入时序逻辑。只有边沿来了才跑。
八、阻塞赋值 vs 非阻塞赋值 🔀
两种赋值在 Verilator 生成代码里的处理不同:
混合场景
   always @(posedge clk) begin
    a = b;      // 阻塞:立即写
    c = a;      // 看到新 a
    d <= e;     // 非阻塞:写到临时变量
    f <= d;     // 看到旧 d
end
生成代码:
   vlSelfRef.a = vlSelfRef.b;        // ① 阻塞:直接写
vlSelfRef.c = vlSelfRef.a;        // ② 读到新 a

__Vdly__d = vlSelfRef.e;          // ③ 非阻塞:临时变量
__Vdly__f = vlSelfRef.d;          // ④ 读到旧 d

vlSelfRef.d = __Vdly__d;          // 末尾统一提交
vlSelfRef.f = __Vdly__f;
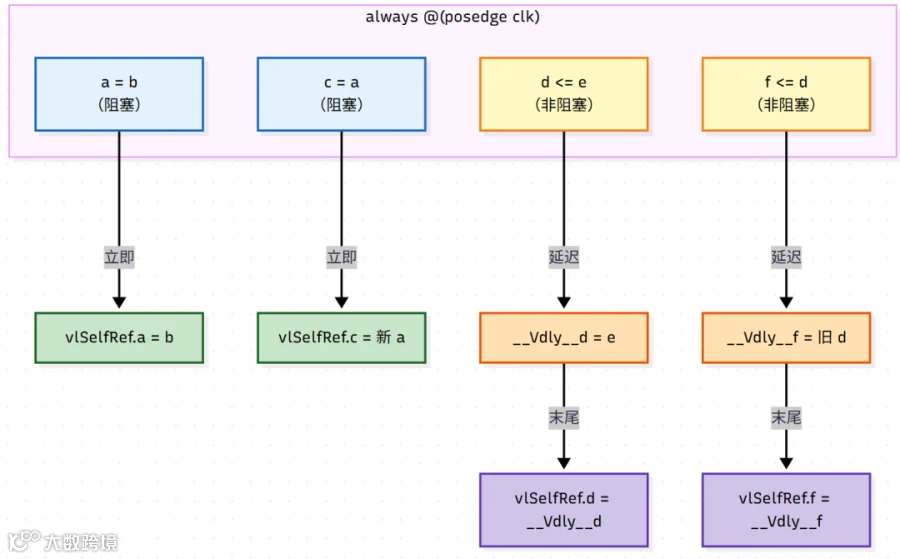
同一个 always 块里两种赋值共存,Verilator 用两套机制处理。
九、各 eval 区域的实例对照 🧪
9.1 eval_static
   localparam LUT [0:3] = '{1, 2, 4, 8};
assign y = LUT[idx];
   void Vmod___024root___eval_static(Vmod___024root* vlSelf) {
    vlSelf->__Vtable_LUT[0] = 1;
    vlSelf->__Vtable_LUT[1] = 2;
    vlSelf->__Vtable_LUT[2] = 4;
    vlSelf->__Vtable_LUT[3] = 8;
}
-
• 只在首次 eval()之前执行一次 -
• 处理 localparam、静态查找表、常量数组 -
• 后续所有 eval()都不再调用 -
• 生成代码位于 *__Slow.cpp文件
9.2 eval_initial
   initial begin
    rst = 1;
    #10 rst = 0;
end
   void Vmod___024root___eval_initial(Vmod___024root* vlSelf) {
    vlSelf->rst = 1;
    vlSelf->__Vtiming_initial_coroutine =
        Vmod___024root___eval_initial__TOP__Vtiming__0(vlSelf);
}
-
• 时间零点执行一次 -
• 处理 initial块里的顺序语句 -
• 带 #delay时启动协程(需要--timing) -
• 不带 --timing时无#delay,直接执行赋值
9.3 eval_stl
   wire a, b, c;
assign a = ~b;
assign b = ~c;
assign c = ~a;
   bool Vmod___024root___eval_stl(Vmod___024root* vlSelf, bool firstIteration) {
    if (firstIteration) {
        vlSelf->a = 0; vlSelf->b = 0; vlSelf->c = 0;
    }
    vlSelf->a = ~vlSelf->b;
    vlSelf->b = ~vlSelf->c;
    vlSelf->c = ~vlSelf->a;
    return (vlSelf->a != __Vprevexpr_a) | (vlSelf->b != __Vprevexpr_b);
}
-
• 只在首次 eval()时进入 -
• 迭代求解组合逻辑环路,直到信号稳定 -
• 超出 --converge-limit时报错 -
• 普通设计里通常一轮收敛,几乎不占时间
9.4 eval_sample
assert property (@(posedge clk) req |-> ##[1:3] ack);
   void Vmod___024root___eval_sample(Vmod___024root* vlSelf) {
    vlSelf->__Vsampled_req = vlSelf->req;
    vlSelf->__Vsampled_ack = vlSelf->ack;
    vlSelf->__Vsampled_clk = vlSelf->clk;
}
-
• 每次 eval()都执行 -
• 在 Observed 区域之前采样,保证断言看到的是时间步开始的值 -
• 没有 SVA 断言时为空函数 -
• 采样值存在 __Vsampled_*前缀的变量里
9.5 eval_ico
   input wire a, b;
wire sum = a ^ b;
wire cout = a & b;
   bool Vmod___024root___eval_ico(Vmod___024root* vlSelf, bool firstIteration) {
    vlSelf->__VicoTriggered[0] =
        ((vlSelf->b != vlSelf->__Vtrigprevexpr_b) << 1)
      | ((vlSelf->a != vlSelf->__Vtrigprevexpr_a) << 0);
    vlSelf->__Vtrigprevexpr_a = vlSelf->a;
    vlSelf->__Vtrigprevexpr_b = vlSelf->b;

    if (vlSelf->__VicoTriggered[0] & 0b11) {
        vlSelf->sum  = vlSelf->a ^ vlSelf->b;
        vlSelf->cout = vlSelf->a & vlSelf->b;
    }
    return 0;
}
-
• 处理顶层输入驱动的组合逻辑 -
• 用 __VicoTriggered位图记录哪些输入变了 -
• 只重算依赖变化输入的逻辑,其余保持 -
• 在五层嵌套循环之前独立执行
9.6 eval_act
   always @(posedge clk or negedge rst_n) begin
    q <= d;
end
   bool Vmod___024root___eval_act(Vmod___024root* vlSelf) {
    vlSelf->__VactTriggered[0] =
        (((~vlSelf->rst_n) & vlSelf->__Vtrigprevexpr_rst_n) << 1)
      | ((vlSelf->clk & ~vlSelf->__Vtrigprevexpr_clk) << 0);
    vlSelf->__Vtrigprevexpr_clk   = vlSelf->clk;
    vlSelf->__Vtrigprevexpr_rst_n = vlSelf->rst_n;

    Vmod___024root___trigger_orInto__act_vec_vec(
        vlSelf->__VnbaTriggered, vlSelf->__VactTriggered);
    return 0;
}
-
• 只做边沿检测,不执行逻辑 -
• 检测 posedge clk和negedge rst_n -
• 结果累积到 __VnbaTriggered -
• 函数本身恒返回 0
9.7 eval_inact
   always @(posedge clk) begin
    a <= b;
    #0 a = a | c;
end
   bool Vmod___024root___eval_inact(Vmod___024root* vlSelf) {
    if (vlSelf->__VinactTriggered & INACT_BIT) {
        vlSelf->a = vlSelf->a | vlSelf->c;
        vlSelf->__VinactTriggered &= ~INACT_BIT;
    }
    return 0;
}
-
• 处理 #0延迟的语句 -
• 在 Active 之后、NBA 之前执行 -
• 没有 #0时为空函数 -
• 大部分设计用不到
9.8 eval_nba
   always @(posedge clk or negedge rst_n) begin
    if (!rst_n) q <= 0;
    else        q <= d;
end
   bool Vmod___024root___eval_nba(Vmod___024root* vlSelf) {
    if (!Vmod___024root___trigger_anySet__act(vlSelf->__VnbaTriggered))
        return false;

    CData __Vdly__q = vlSelf->q;
    if (!vlSelf->rst_n) {
        __Vdly__q = 0;
    } else {
        __Vdly__q = vlSelf->d;
    }
    vlSelf->q = __Vdly__q;

    Vmod___024root___trigger_clear__act(vlSelf->__VnbaTriggered);
    return true;
}
-
• 执行非阻塞赋值的时序逻辑 -
• 用 __Vdly__临时变量模拟<=语义 -
• 函数末尾统一提交到实际寄存器 -
• 返回 true表示有工作,触发外层循环
9.9 eval_obs
   assert property (@(posedge clk) req |-> ##1 ack)
    else $error("ack missing");
   bool Vmod___024root___eval_obs(Vmod___024root* vlSelf) {
    if (vlSelf->__Vsampled_req && !vlSelf->__Vassert_pending) {
        vlSelf->__Vassert_pending = 1;
    }
    if (vlSelf->__Vassert_pending && vlSelf->__Vsampled_ack) {
        vlSelf->__Vassert_pending = 0;
    } else if (vlSelf->__Vassert_pending && vlSelf->__Vassert_timeout) {
        VL_WRITEF("assertion failed: ack missing\n");
        vlSelf->__Vassert_pending = 0;
    }
    return 0;
}
-
• 执行 SVA 断言检查 -
• 在 NBA 之后、Reactive 之前 -
• 没有断言时为空函数 -
• 断言失败时打印错误信息
9.10 eval_react
   program test_prog(input clk);
    initial begin
        @(posedge clk);
        $display("program executed");
    end
endprogram
   bool Vmod___024root___eval_react(Vmod___024root* vlSelf) {
    if (vlSelf->__VreactTriggered & PROG_BIT) {
        VL_WRITEF("program executed\n");
        vlSelf->__VreactTriggered &= ~PROG_BIT;
    }
    return 0;
}
-
• 执行 program块和clocking块 -
• 最外层循环 -
• 没有 program时为空函数 -
• 普通 RTL 设计不会用到
9.11 eval_postponed
   initial begin
    $monitor("time=%0t q=%b", $time, q);
    $strobe("q=%b", q);
end
   void Vmod___024root___eval_postponed(Vmod___024root* vlSelf) {
    if (vlSelf->__Vmonitor_enabled) {
        VL_WRITEF("time=%0t q=%b\n", vlSelf->__Vtime, vlSelf->q);
    }
}
-
• 时间步末尾只执行一次 -
• 处理 $monitor、$strobe等输出 -
• 此时所有信号已稳定,打印的是最终值 -
• 没有相关系统任务时为空函数
9.12 eval_final
   final begin
    $display("simulation ended, total=%0d", counter);
end
   void Vmod___024root___eval_final(Vmod___024root* vlSelf) {
    VL_WRITEF("simulation ended, total=%0d\n", vlSelf->counter);
}
-
• 仿真结束时执行 -
• 处理 final块 -
• 只跑一次,不参与 eval()循环 -
• 没有 final时为空函数
十、两套调度模型 🆚
Verilator 的调度实现经历了一次重要重构。
4.x:每个模块生成完整调度
   void Vfp_adder::eval() {
    eval_static();
    eval_ico();
    do {
        eval_act();
        eval_nba();
    } while (还有触发);
    eval_end();
}
每个模块都有一份完整的调度代码——冗余严重,大设计里生成代码体积庞大。
5.x:统一调度框架
   void Vfp_adder::eval_step() {
    m_evalLoop.eval();     // 通用
}
所有模块共用 VlEvalLoop——通过虚函数回调到具体区域实现。

改进效果
代价:虚函数调用开销。但因为每区域调用次数少,实际影响可忽略。
十一、性能特征 ⚖️
eval 调用的开销来源
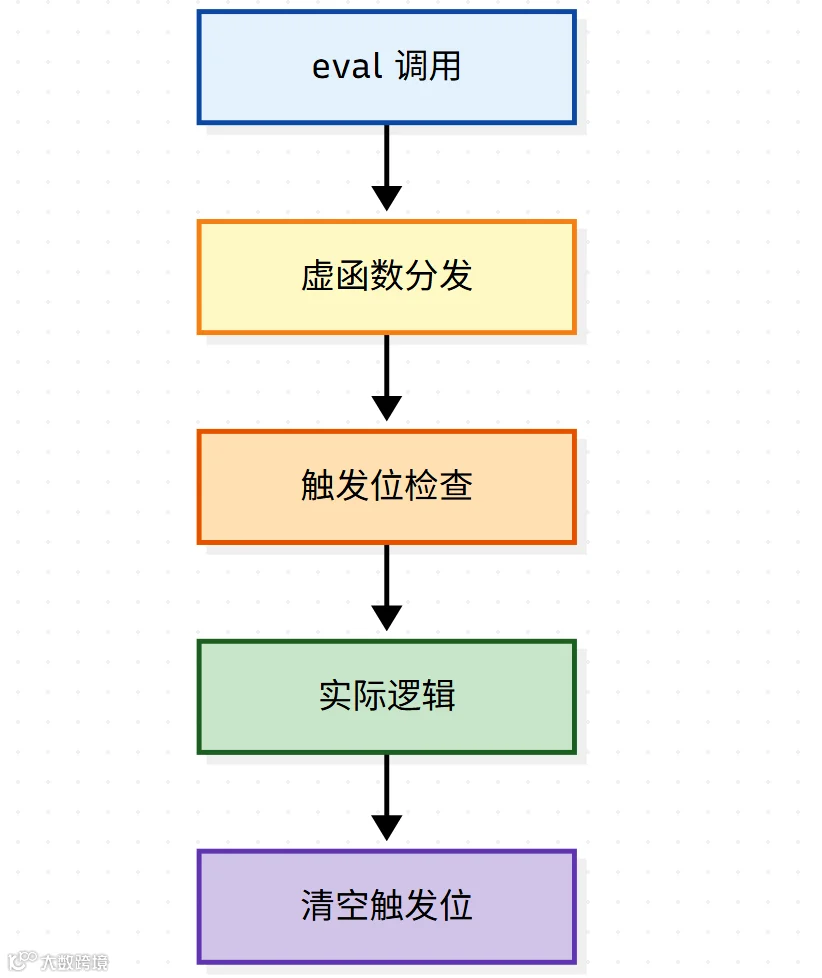
纯 RTL 设计的实际路径
对于没有断言、没有 #delay 的纯 RTL,每次 eval() 实际只走三个区域:
-
• evalIco:输入组合逻辑 -
• evalAct:边沿检测 -
• evalNba:时序更新
其余区域是空函数——调用它们只花虚函数分发的开销。
多区域切换的代价
当设计里混用 always @(*) 和 always @(posedge clk) 时,evalIco 和 evalNba 会分别被触发:

多一次外层迭代——因为 NBA 更新可能触发新的 Active 逻辑。
十二、总结 🎯
Verilator 的 eval 实现是一套精密的调度系统,核心要点:
-
• 分层事件队列:7 个区域对应 IEEE 1800 标准,五层嵌套循环保证收敛 -
• 调度框架复用: VlEvalLoop是一份通用代码,各模块通过虚函数实现具体区域 -
• 边沿检测在 eval_act: clk & ~clk_prev检测上升沿,__VactTriggered累积到__VnbaTriggered -
• 时序逻辑在 eval_nba: nba_sequent真正更新寄存器,用__Vdly__模拟非阻塞赋值 -
• 组合逻辑在 eval_ico: always @(*)的边沿检测和逻辑体都在这里 -
• 两套调度模型:4.x 每模块生成完整调度,5.x 用 VlEvalLoop统一

理解这套机制,能帮助阅读 Verilator 生成的代码、分析仿真性能瓶颈,以及判断哪些区域被实际使用——对纯 RTL 设计,绝大多数区域是空壳,真正跑的是 eval_ico、eval_act、eval_nba 三个。