过去半个月,有三件事放在一起看很有意思。
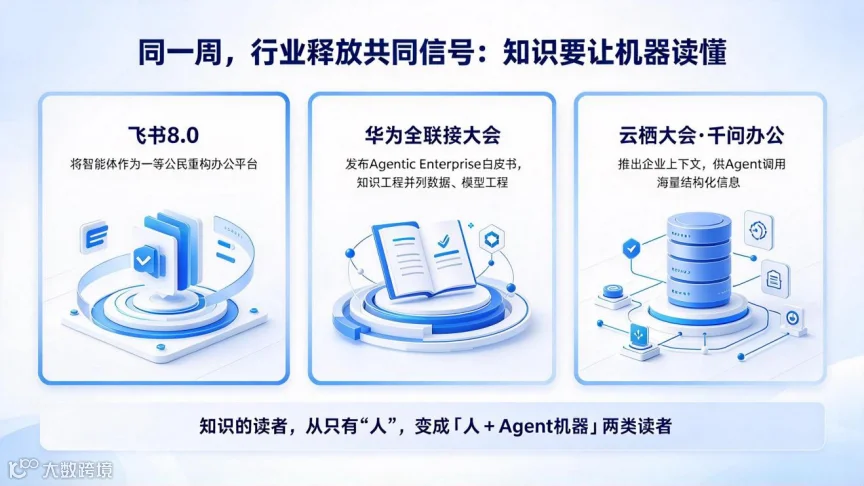
9月15日,飞书发布8.0。据官方介绍,这次改版是“为适配Agent进行的系统性重构”。飞书CEO谢欣的表述更直接:据其说法,飞书是第一个把智能体当作“一等公民”重新设计的办公平台。
9月18日,华为在全联接大会上发布《Agentic Enterprise:企业智能化白皮书》。它提出的五大工程里,有一个叫“知识工程”,和数据工程、模型工程并列。
9月22日,云栖大会,千问办公发布“企业上下文”。给出的理由很直接:业界长期缺少一种基础设施,能把海量信息结构化,供Agent调用。
三家不在同一个赛道上的公司,在同一周里做了同一件事:把知识重新组织一遍,好让机器能读。
这三件事不是新闻,是信号。它们指向一个很少被讨论的变化。
它们的动作各不相同,方向是一致的。这类产品过去主要解决“人怎么找到信息”,现在要先解决另一件事:“机器能不能读懂”。
政策文件里有同样的信号。工业和信息化部等八部门印发的《“人工智能+制造”专项行动实施意见》提出,到2027年推出1000个高水平工业智能体,推广500个典型应用场景。
一个行业要跑出上千个智能体,先得有它们读得懂的知识。这是所有部署计划绕不开的第一环。
知识的读者,从一种变成了两种。
过去二十年,企业知识管理的读者只有人。所以标准全都围绕人设计:分类清楚、标题好懂、检索方便。一份文档写得完整、排版整齐,就算合格。
写文档的人默认读者是谁,这件事决定了文档长什么样。在读者只有人的年代,文档只需要对一种理解力负责。
现在多了一类读者。它不翻目录,不从头读到尾,也不会因为看不懂就举手提问。它把你的知识整段拿去用,直接执行。
而它从来不问一句“这条现在还有效吗”。

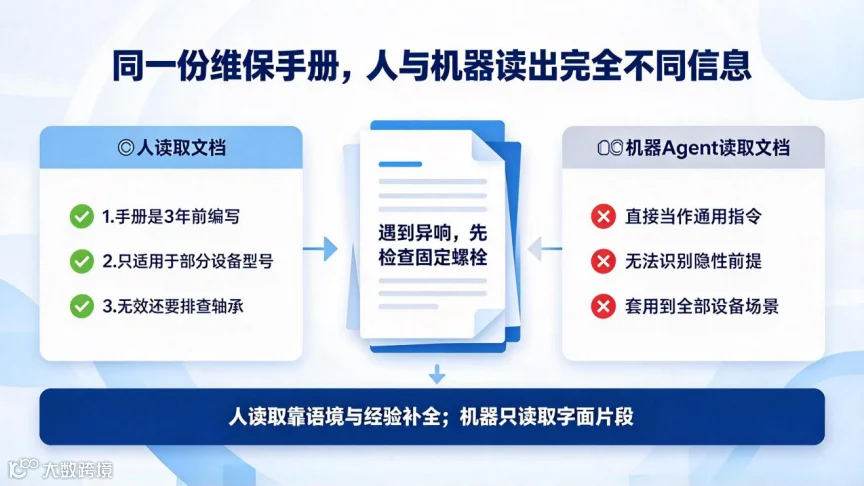
任何一家有设备的企业,维保手册里几乎都能找到这样一条:遇到异响,先检查固定螺栓。
人读到这一条,脑子里会自动补上几件事。这份手册是三年前写的,那批设备后来改过结构;写这条的是个老师傅,他当时说的是其中几个型号;如果紧完还有异响,得再往轴承上找原因。
这些补充一个字都没写在文档里,但读的人会自己补。
机器读到同一条,看到的是一条干净的动作指令:遇到异响,检查螺栓。
它不会去查这份手册写于哪一年,不会怀疑这条规则管多大范围,更不会知道有的型号其实不适用。
它会把这一条,用在所有设备、所有年份、所有场景上。
对人来说,这是参考;对机器来说,这是指令。
中间差着的那部分,就是没人写下来的前提。
还有一层差别藏得更深。
人读文档是带着问题读的:想弄清什么,自己会往哪几章翻;读到一半觉得不对,会往回翻,会去比对另一份文件。
机器不这样工作。它是被检索到的,一次拿到的是切好的一段。它没有“往哪翻”的直觉,也没有“这份好像不对”的怀疑。给它什么,它加工什么。
人是在语境里读,机器是在片段里读。

这件事不能怪文档写得不认真。文档的写法,本来就是照着人的理解力设计的。
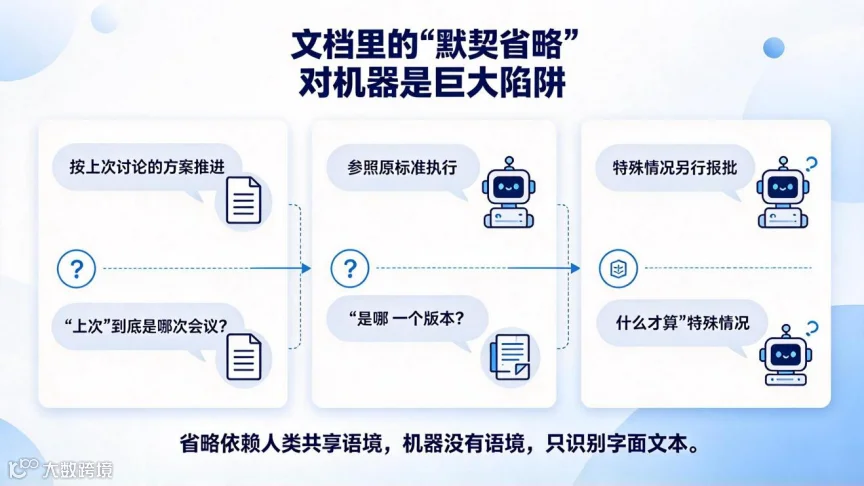
会议纪要写“按上次讨论的方案推进”,因为写的人和读的人都知道,“上次”指哪一场、哪个方案。
工艺文件写“参照原标准执行”,因为车间里的人都知道,“原标准”是哪一版。
制度文件写“特殊情况另行报批”,因为同事之间有默契,知道什么情况算特殊。
这些写法不是偷懒,是当时最经济的选择。
省略的前提是共享语境。 同一批人在同一层楼、跑同一套流程、用同一批系统,谁都不需要把话说全。省下来的字,在过去等于效率。
这三句话,人读下来都没有歧义。机器读,每一句都是坑。
“上次”是哪次、“原标准”是哪一版、“特殊”的边界在哪里,它都不知道。它也不会停下来问,而是按最字面的意思往下做。
文档里的省略,过去叫简洁,现在可能是歧义。
新读者的麻烦在于,它不在那个语境里。它读到的是脱了水的文本,而且不会意识到自己缺了什么。
这里的省略,和写得潦草是两回事。省略是刻意的,是当时的最优解,问题只出在读者换了。
这个差别到今年才被看见,是因为过去只有一个读者,而它有一项默认能力:补全。

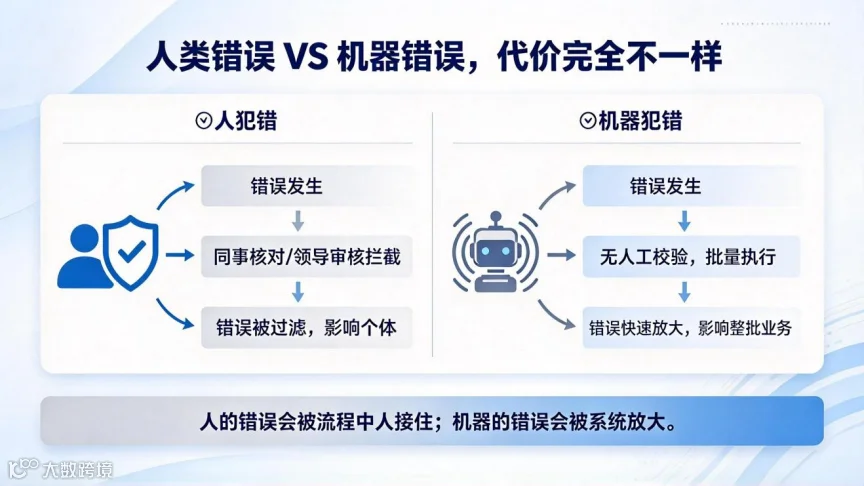
人和机器都会用错知识,但错的代价不在同一个量级上。
一个人看错了标准,做错一件事,这件事大概率会被拦住。同事会多问一句,领导会退回来,客户会提出异议。错误在传导的过程里就被人接住了。
拦住它的不是流程,是人。
过去这套机制够用,是因为流程的每一环末端都站着人。
人做判断之前会看一眼实际情况,会跟旁边的人确认一句,会觉得“这个数不太对”。这些动作几乎不花时间,却构成了一道质检。流程再粗,也因为这道质检而没有出大乱子。
这道质检之所以没出现在流程图上,是因为它免费。它藏在每个岗位的经验里,从来没被单独标过价。
一台机器拿错了规则,会把这条规则用在一个批次、一个区域、所有符合条件的对象上。它不累,不怀疑,也不会在群里说一句“这个好像不对”。
人的错误在流程里被过滤,机器的错误在流程里被放大。
还有速度上的差别。人在一天里能用错一条规则几次,系统在同一分钟里能把同一批规则跑完所有对象。
错误从发生到被发现之间的那段空档,决定了损失的量级。
过去知识错了,代价是一个人;现在知识错了,代价可能是一次批量。
过去衡量知识管理做得好不好,标准一直很稳定:有多少份文档、覆盖了多少部门、检索准确率多少、月活多少人。
这四件事各测一个侧面:文档量测投入,覆盖率测范围,检索准确率测工具,月活测习惯。
它们合起来描述的,是一套以人为读者的知识管理该有的样子。
而它们共同服务的,是同一件事:能不能找到。
新读者提出的要求是另一个问题:能不能直接用。
这两件事之间的距离,比看上去远。
一个检索准确率很高的知识库,可能没有一条知识被直接执行过。因为它命中的是文档,不是答案——查到一份四十页的手册,剩下的三十九页还得人来读、来挑、来判断。
命中的粒度是文档,需要的粒度是那一条结论。
找得到,只说明东西没丢;用得上,才说明它重新产生了价值。
中间省掉的那一步,正是这次重构的全部内容。
新的标准还没有统一的说法,但方向是清楚的:不用人接手的比例有多高。
一个问题问出来,答案能直接拿去用,不必再找人确认,不必再补一层判断,这才是新读者关心的数字。
拿知识库自己举例。月活可以很高,搜索次数可以很热闹,但真正值得看的是搜索之后发生了什么:有多少次是拿到答案就用了,有多少次是拿到一份文档,还得转给别人再确认一遍。

要改的地方有四处,都不在数量上。企业的知识不是太少,是太散、太粗、太像给人看的。
把每条知识写成能直接用的句子。
“住宿标准600元”是给人看的,读的人自己会去核对适用范围。给机器用,得写成:什么级别的员工、去哪一类城市、上限多少、超出部分走谁的审批。
主体、条件、边界、动作,一句话里都要有。少一样,这句话就只能在人嘴里成立。
这不是要求把话说得更啰嗦。恰恰相反,是把过去分散在三个人脑子里的信息,一次收进一条句子里。
把适用边界写进条目,而不是留在写的人脑子里。
几乎所有规则都有例外。过去处理例外的办法是“遇到特殊情况找某人确认”,人知道找谁,机器不知道找谁,也不知道什么算特殊。边界不写清楚,机器会把例外当成常规,一次不落。
写边界有个笨办法很好用:把“什么情况下不能用”单独列出来。正常情况谁都会写,例外情况才是过去只存在于口头的那部分。
颗粒度降下来。
一份四十页的材料,人能从中挑出有用的三页,机器会被剩下三十七页干扰。同一件事最好只留一条,条与条之间不重叠,也不互相矛盾。
知识库里的矛盾,比知识库里的空白危险得多。空白会被发现,矛盾不会——它会安静地挑一条来用。
拆到什么程度算够,有个判断标准:这条知识能不能独立成立。读完它还要翻另一段才知道在说什么,就说明拆得不够。
给它一个说“不知道”的出口。
机器最危险的地方不是答错,是它不知道自己在什么情况下该答“不知道”。库里明明没有的问题,它可能找一条最相近的凑上去,还答得很流畅。
明确告诉它:没有就是没有。这句话看似降低了体验,实际上是把剩下答案的可信度提上去了。
这条最容易被跳过,因为它看着像是在削弱产品的能力。但一个敢说“没有查到”的系统,比一个什么都敢答的系统,可信度高得多。
这四件事有一个共同点:它们都不增加知识的数量,只改变知识的写法。
而“写法”过去不算是问题——因为过去的读者,有能力自己把写法上的窟窿补上。


天枢智在做的,是把这件事往前推一步。
知识被整合起来之后,还要让系统认得企业的规范——哪些是必须遵守的硬约束,哪些只是建议,什么情况下该走例外流程。
这样Agent在执行任务时拿到的,不只是一条查到的内容,还带着“什么情况下不能这么做”。
这件事不分行业。合同条款、工艺参数、财务制度,越是被反复引用的规矩,越需要提前把边界说清楚。
知识能被调用只是开始;能被放心地调用,才是它真正开始工作的那一刻。

回到开头那三件事。
它们说到底是同一件事:为新的读者,把知识重新组织一遍。
这件事,大平台有条件自己动手。而企业的知识散在更碎的地方——OA里、网盘里、车间里、销售的手上。这件事很难由别人代劳。
它也不需要一个专门的改造周期。知识本来就是跟着业务长出来的,改写的动作也可以跟着业务走:哪条规则这个月又被用到了,就把它先改好。
读者变了,知识的写法就得跟着变。
这件事真正的难处不在技术,在于它要求每个岗位回头审视自己习惯的那些简化说法,那些靠默契才成立的话。
如果眼下只能做一件事,那就挑一条你们公司最常用的规则,试着把它改写成机器能照着做的样子。
写的过程中,你会被逼着补出几个前提。
那些前提,就是过去一直躺在人脑里、从来没有被写下来的那部分知识。
—END—
内容看完有收获
点个“推荐”吧