
10月2日,AI 制药公司 Xaira Therapeutics 公布了一组数字:182 个 AI 从零设计的抗体序列,3 周湿实验,直接筛出一个"能成药"的分子。数字看着不大,但速度反常:从 DNA 合成到临床前先导分子,全程 7 周。
抗体发现的旧流程里,这件事的计量单位是"年"。先免疫动物或筛文库拿命中分子,再做人源化、亲和力成熟、可开发性优化,每一步都以月计。能结合靶点的分子好找,能一路走到临床的分子难寻。但 Xaira 这次声称:模型一次设计,直接到位。
10 亿美元押注的公司,交卷了
Xaira 2024 年 4 月才浮出水面,带着超过 10 亿美元的承诺资本出场,是 ARCH Venture Partners 历史上最大的一笔初始投资。CEO 是基因泰克前首席科学官、斯坦福前校长 Marc Tessier-Lavigne,联合创始人是蛋白质设计泰斗 David Baker。但比钱更关键的是人:RFdiffusion 和 RFantibody 的作者们,如今都在这家公司。
这条技术线的上一座里程碑,是 2025 年 11 月发表的 RFantibody(Nature 649, 183-193):首次证明 AI 能针对指定表位从零设计抗体。但那篇论文里,初始设计亲和力只有几十到几百 nM,要靠 OrthoRep 亲和力成熟才推到个位数 nM。能结合只是入场券,X-Design Vega 这次要回答的问题更狠:能不能直接设计出可以往临床推的分子?
"能成药"是一道五合一的门槛
Xaira 在今年 6 月的前一篇博客里立过一个标准,叫"可推进结合子"(progressable binder):候选分子要按顺序回答三个问题——是真结合吗?像药吗?能撑起一个治疗项目吗?打个比方:海选晋级只说明唱得好,但能不能出道,还要看体检、合约和市场。
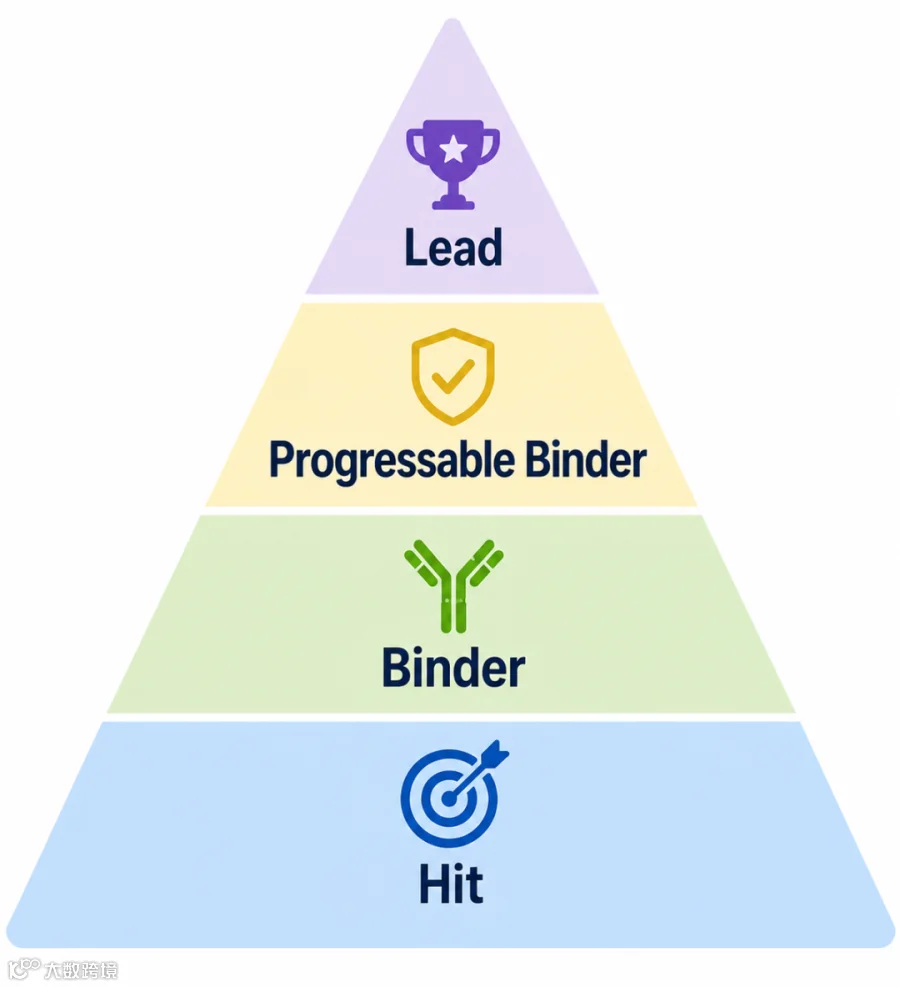
从命中到先导的四级漏斗:Xaira 的"可推进结合子"标准(图源:Xaira 官方博客)
但难的是这些属性互相打架。就拿"像人"和"稳定"来说:Xaira 自己的数据显示,人源评分高的天然 VHH,热稳定通过率从 41% 掉到 20%——越像人,越容易散架。Vega 的解法是把人源性、效力、选择性、交叉反应、可开发性放进同一个优化目标,再用专有数据对齐。结果是同时满足全部可开发性标准的人源样 VHH 比例,从 22% 拉到 66%,是基线模型的 3 倍。

六项可开发性检测中,Vega(青)对人源样 VHH 的通过率全面超过基线模型(深蓝),六项全过的比例从 22% 升至 66%(图源:Xaira 官方博客)
3 周,182 个序列,一个可推进分子
第一个案例 XA-1 是 Xaira 肿瘤管线的头号项目,要求苛刻:结合一个精度受限的表位、避开同家族其他成员、与模式动物同源蛋白交叉反应,亲和力还得落在指定窗口。Vega 零样本(zero-shot)设计了 182 个 VHH 序列——没用过这个靶点的任何历史数据,但直接迎战全部要求。
湿实验结果:初筛 25 个命中,但完整质控后只剩 18 个确认结合(结合率 10%),其中 9 个拿到高质量动力学曲线。最佳分子对人源靶点 KD 17 nM,对食蟹猴同源蛋白 83 nM,可开发性检测全部通过——表达量 78 µg/mL,热变性温度 76.9°C。
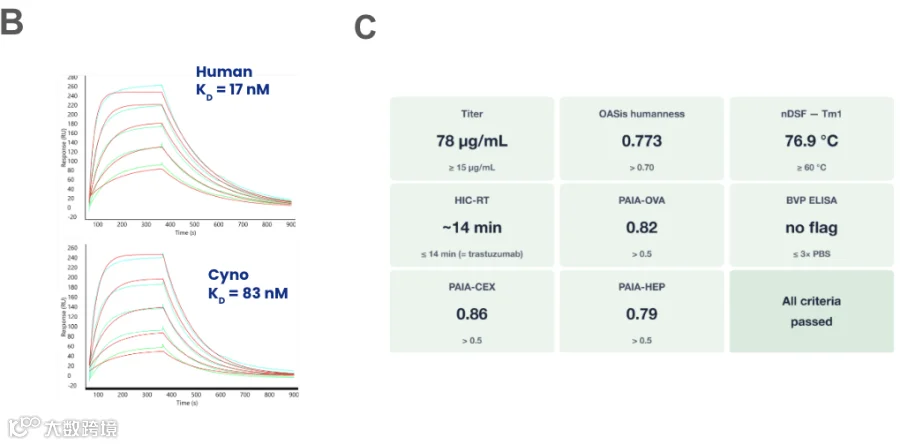
XA-1 最佳分子的 SPR 动力学(人源 KD 17 nM、食蟹猴 83 nM)与可开发性面板,全部指标通过(图源:Xaira 官方博客)
速度是另一个看点。设计提交后第 2 周确认结合,第 3 周拿到可推进分子,第 7 周完成一轮优化得到临床前先导。传统流程里,光 hit-to-lead 加人源化就要数月。但要泼一盆冷水:这场闪电战有前提——抗原试剂提前备好,表位提前锁定。
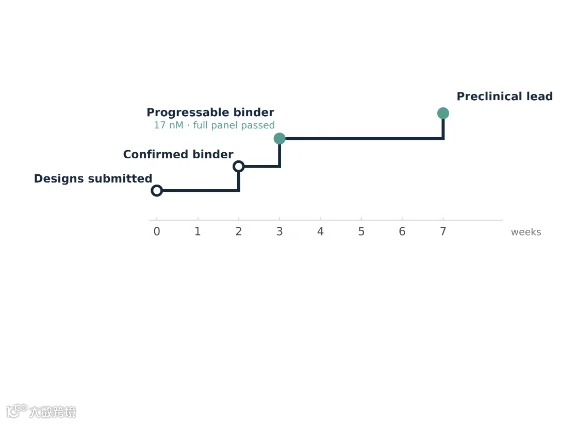
XA-1 从设计提交到临床前先导分子的 7 周时间线(图源:Xaira 官方博客)
传统方法先输了一阵
第二个案例 XA-4 才是真正的硬仗。这是一个 GPCR:翻译后修饰多、胞外区小且柔软、表位与功能的关系不清,但最要命的是,还没有现成的广谱拮抗抗体。Xaira 先用传统方法硬攻过:两轮天然 VHH 文库筛选、四轮淘选,富集到的"命中"克隆表达后全部不结合;羊驼免疫,同样颗粒无收。
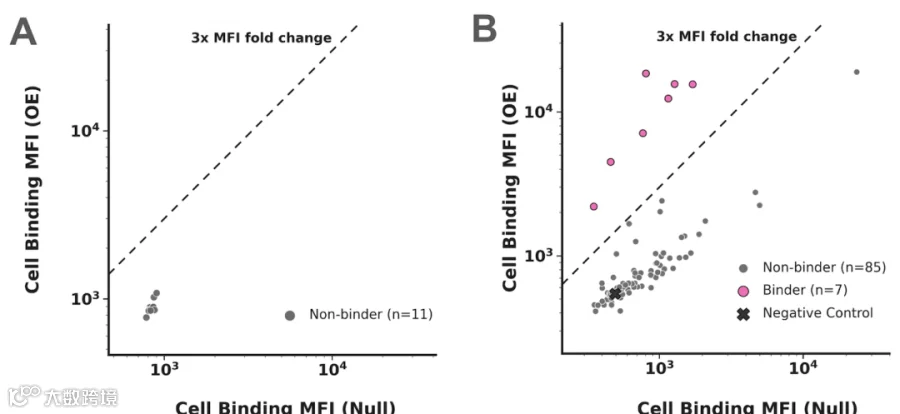
传统文库筛选的 11 个克隆全部不结合(左),X-Design 的 92 个分子中 7 个确认结合(右)(图源:Xaira 官方博客)
表位不清楚,但 Vega 的打法是"不猜":同时建模多个候选表位和构象,一次性设计 6 万个 VHH 组成文库——像开锁匠不知道锁芯结构,就造一大串钥匙一起试。纳米盘淘选后挑出 92 个富集分子,流式验证 7 个结合,功能实验确认 6 个抑制剂。
但最好的分子一路通关:最大抑制率超过 96%,IC50 183 nM;细胞结合 EC50 32 nM;人、食蟹猴、小鼠三个物种交叉反应;可开发性全部达标。在传统方法全军覆没的靶点上,一次设计拿到 6 个确认抑制剂。这个分子已进入先导优化阶段。
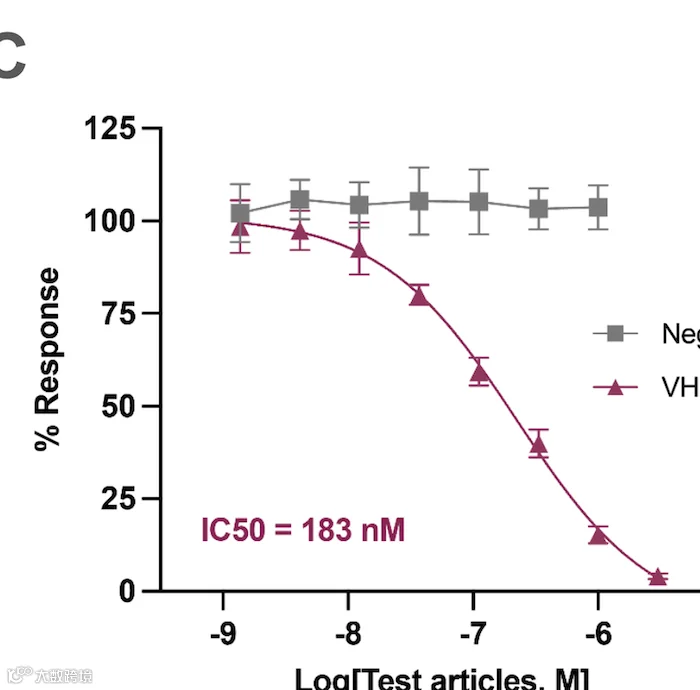
最佳分子在 β-arrestin 实验中完全拮抗 XA-4,IC50 为 183 nM(图源:Xaira 官方博客)
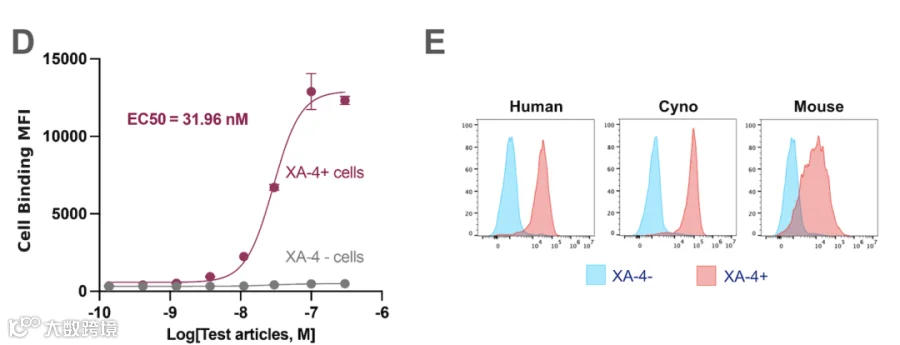
细胞结合 EC50 31.96 nM(左),对人、食蟹猴、小鼠同源蛋白均交叉反应(右)(图源:Xaira 官方博客)
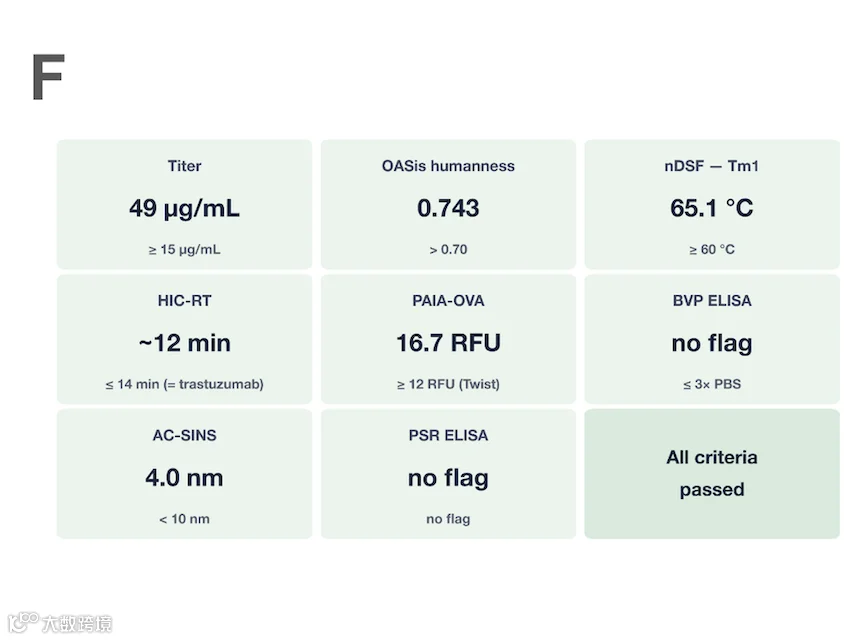
XA-4 先导分子的可开发性面板:表达、人源评分、热稳定、低多反应性全部通过(图源:Xaira 官方博客)
命中率还是问题吗?
在结构已知的"简单" GPCR 上,数字更夸张:CXCR4 和 APJ 各设计 91 个,命中率分别 35% 和 29%;最佳分子 EC50 为 12.8 nM 和 8.4 nM,与阳性对照的 8.6 nM 和 8.8 nM 基本打平。但这两个靶点本来就有清晰表位,只能算热身——真正的考题是 XA-4。

CXCR4 与 APJ 两个 GPCR 各 91 个设计的流式筛选结果,命中率 35% 与 29%(图源:Xaira 官方博客)
离"药"还有多远
需要交代的局限不少,但最要紧的是两条。所有数据来自 Xaira 自报,未经同行评审;XA-1 和 XA-4 都是匿名代号,外界无法独立复核。"可推进"只是富集过滤器,离临床保证还很远——Xaira 自己也承认,拿到可推进抗体"并不保证最终成功"。
更大的悬念在后面:X-Design 的系统性评估还没发布,这次只是两个案例。但如果管线可以按靶点的治疗价值来选、不用再管靶点好不好做,制药公司选项目的逻辑将被改写。David Baker 的话可以作为注脚:"几十年来,一些驱动疾病的蛋白质一直是抗体药物的禁区。X-Design 表明,AI 开始能从零设计出瞄准这些靶点的抗体。"
David Baker 对本次发布的评价(图源:Xaira 官方博客)