

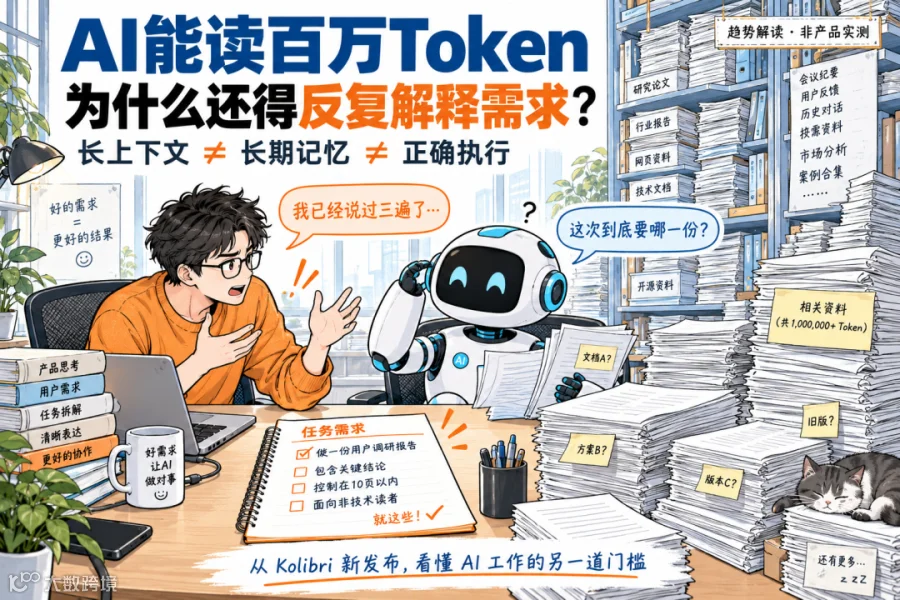
资料发了一大堆,要求写得很认真,AI也答得头头是道。可你一看成品,还是忍不住说:“不是这个意思,我刚才不是说过了吗?”
更气人的是,换个对话,又得从头解释。
我们总盼着模型再聪明一点。今天这条新消息,倒让我更想问:资料都能塞进去以后,工作为什么还是没做好?
01 / 百万Token来了,先别急着欢呼
10月3日,Aleph Alpha发布开放权重模型Kolibri。官方模型卡称,它最高支持1,048,576 Token上下文,同时建议复杂任务和注重效率的部署,控制在262,144 Token以内。它主要面向德语和英语,并不是为中文办公量身打造的模型。
Token可以粗略理解为模型处理文本的单位,不能直接换算成同样数量的中文字。
这条消息有意思的地方,不是“又多一个模型”,而是它把一个常被忽略的问题摆到了台面上:
能读更多,不等于每份资料都该读。
就像请同事帮你写方案。你往他桌上堆二十份旧文件,却没说哪份作废、谁是读者、最后要交什么。桌子再大,也解决不了这个问题。
02 / 别把“读得多”,当成“记得住”

这三件事,最好分开看。
长上下文,是这一次能参考多少资料。
长期记忆,是下次还能不能找回你的偏好、项目进展和已经定下来的规则。它需要保存、检索、更新机制,不是换个大窗口就自动有了。
正确执行,则是有没有按要求交付,引用是否靠谱,该停下来问你的时候有没有问。
所以,别再用一句“你应该懂我”当工作说明。
AI不是少看了你一句话。有时候,是你给它的材料里,同时藏着三个互相打架的版本。
03 / 今天就试:把选题资料变成一个任务包
拿公众号选题来说。下面是一个可以照做的演示流程,不是Kolibri实测,也不需要你部署这个模型。
先选5份你有权使用的公开资料,别一上来扔整个收藏夹。建一个文件夹,放三样东西:
一张任务单:写给谁看、这次要解决什么问题、输出什么。比如:“面向普通办公用户,挑出3个能做实操文章的选题,每个附上原始来源。”
一份资料索引:每条写清标题、发布日期、链接和一句摘要。过期的、只有转述没原文的,先标出来。
一张验收清单:事实能回到原文吗?厂商说法有没有标注?读者看完能做什么?
然后在支持读取这些文件的AI工具里,发这段话:
先读任务单,再看资料索引。不要立即写文章。请列出3个候选选题,分别说明读者痛点、证据出处和可操作步骤。只使用提供的资料;找不到依据就标“待核实”。如果资料冲突,列出冲突和日期,先问我。等我确认一个选题,再写正文。
关键不是提示词多漂亮,而是把筛选和写作拆开,把确认留给自己。

第一次做完,把你实际改过的要求存下来。比如“别把版本更新写成新品发布”“每篇只讲一个实操场景”。下次让工具读取最新版规则,不要再靠聊天记录碰运气。
04 / 真正值得积累的,是你做判断的方法
我的判断是:当模型能力越来越容易获得,差异会更多落在谁有可靠资料、谁懂任务、谁能检查结果上。
只会生成内容的服务,可能越来越难卖出差价。能帮客户维护资料、识别过期版本、留下交付记录的服务,反而有机会持续被需要。这是趋势判断,不是收益的保证。
当然,客户隐私和公司内部文件别随手上传;读取更多资料也可能增加费用和等待时间。重要决定仍要自己核验。Kolibri的官方部署要求也是服务器级硬件,别把它当成普通电脑上的轻量插件。
今天不用急着再买一个AI工具。
先打开那个乱七八糟的资料文件夹,挑5份有用的,写清一个任务。
模型可以升级。你让它工作的方式,也值得升级一次。