


题目:TRACE: Turn-level Reward Assignment via Credit Estimation for Long-Horizon Agents
论文地址:https://arxiv.org/abs/2607.13988
代码地址:
创新点
•首次用对比学习把 "人类视频的视觉隐空间" 与 "机器人轨迹的动作隐空间" 显式对齐,使视频帧间变化能映射到物理可执行的动作码本上。
•冻结参考模型,用 KL 散度把策略更新锚定在预训练模型的可信区域内,在适应新本体 / 新环境的同时防止灾难性遗忘与误差累积 —— 这是它从真实世界预训练迁移到 LIBERO 仿真仍能保持 91% 平均成绩的关键 。
方法
本文提出 CLAP,采用 "跨模态对齐预训练、双范式策略训练、正则化微调" 的三段式方法:先用 Act-VAE 把机器人运动轨迹经 VQ-VAE 量化为物理可执行的动作码本,再用 VD-VAE 从人类视频帧间变化推断隐动作,将动作相关隐变量用冻结码本锚定到机器人控制空间、动作无关隐变量用独立码本加 L1 稀疏正则吸收背景等干扰,并通过 SigLIP 对比损失(无标注视频用自监督对比)显式对齐视觉隐空间与动作隐空间,建立起共享可执行隐动作空间;随后在此空间上训练双范式 VLA——CLAP-NTP 以自回归下一 token 预测保留 VLM 的推理与指令跟随能力、仅靠人类视频即可泛化新物体,CLAP-RF 以 Rectified Flow 扩散专家经 stop-gradient 交叉注意力蒸馏 VLM 语义,实现高频高精度控制;最后用 Knowledge Matching 冻结参考模型并以 KL 散度约束微调,防止灾难性遗忘,并在 Astribot S1 真机与 LIBERO 基准上通过消融实验验证了各组件贡献 。
对齐隐动作空间可视化:三类动作基元在 Astribot S1、AgiBot 与 Ego4D 上的语义一致性对比
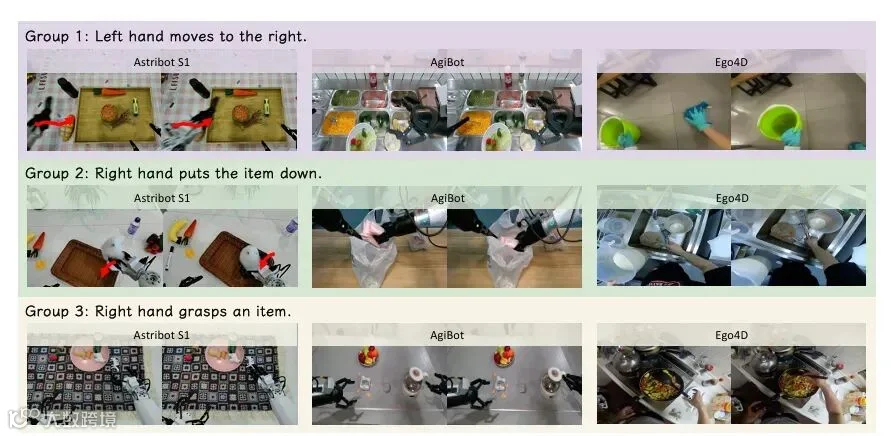
本图以三行三列的矩阵形式展示了 CLAP 学习到的对齐隐动作空间:三行分别对应三个语义明确的动作基元 —— 左手向右移动、右手将物品放下、右手抓取物品,三列则对应三个完全不同的数据来源域 —— 星尘智能 Astribot S1 机器人、AgiBot 机器人和 Ego4D 人类第一人称视频,每个格子都是从对应域中聚类出的动作 token 的代表性样本画面;同一行内,机器人域(Astribot、AgiBot)与人类域(Ego4D)虽然形态、视角和背景完全不同,却呈现出高度一致的操纵语义,直观说明对比对齐后的离散动作码本成功地把 "向右移动"" 放下 ""抓取" 这类动作基元在异构数据域之间归入了同一语义簇,证明了 CLAP 所学的隐表示是跨本体、跨人机一致的;论文图注还说明,图中 Astribot S1 帧上叠加的红色箭头代表由隐动作解码出的预测三维轨迹投影到图像平面的结果,用以验证这套对齐表示不只是语义层面的近似,而且是物理上可执行的 。
CLAP 框架总览:借助人类演示与可执行隐动作实现对象泛化
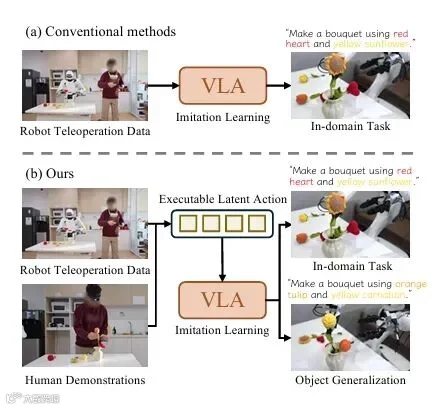
本图通过上下两个对照流程说明 CLAP 与常规方法的本质区别:上半部分 (a) 展示常规方法,只依赖有限的机器人遥操作数据(Robot Teleoperation Data),经模仿学习(Imitation Learning)训练 VLA 模型,虽然能完成训练分布内的任务(如 "用红色爱心花和黄向日葵制作花束"),但无法突破数据范围;下半部分 (b) 展示本文方法,在遥操作数据之外引入大规模人类演示(Human Demonstrations),两者共同提炼出一个可执行隐动作空间(Executable Latent Action),再结合模仿学习驱动 VLA 模型,使其在完成同样域内任务的同时,还能把从人类视频中学到的语义知识迁移到新物体上,实现对象泛化(Object Generalization,如 "用橙色郁金香和黄康乃馨制作花束" 这一训练中未出现的组合);图中还配以机器人操作、人类演示的实景画面与两类任务的插花效果图,直观呈现了 "人类视频先形成可执行的动作语义,再泛化到未见物体" 这一核心设计 。
CLAP 流水线总览:对比式隐动作预训练与双范式 VLA 框架
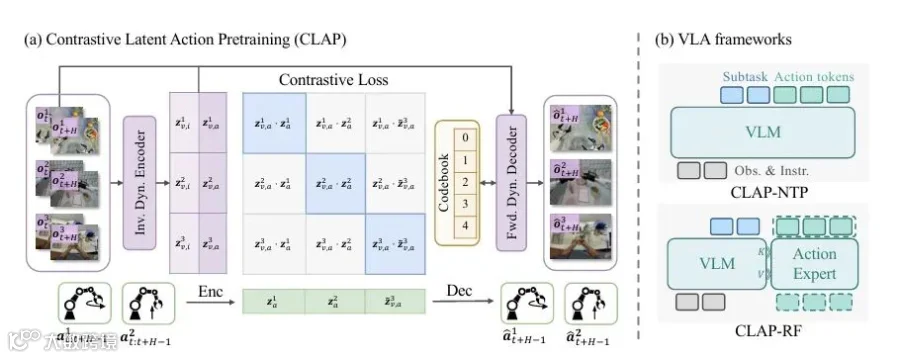
本图分左右两部分展示 CLAP 的整体技术架构:左侧 (a) 是核心的对比式隐动作预训练(Contrastive Latent Action Pretraining)流程,输入多帧观测(oₜ、oₜ₊ₕ)与动作序列(aₜ)后,先由逆动力学编码器(Inv. Dyn. Encoder)提炼出动作相关的隐动作表征 zᵃ,再通过一个对比损失矩阵(Contrastive Loss)对视觉隐变量与动作隐变量做逐对相似度比对,把视频帧间变化对齐到量化码本(Codebook)中的物理可执行动作,最后经前向动力学解码器(Fwd. Dyn. Decoder)重建或预测未来帧(âₜ₊ₕ),形成 "编码→量化→对比对齐→前向解码" 的闭环,图下方还用 Enc 与 Dec 的简化示意(aₜ:t+H−1 → zₐ → âₜ:t+H−1)概括了这一编解码关系;右侧 (b) 对比两类 VLA 框架:CLAP-NTP 仅由 VLM 接收观测与指令(Obs. & Instr.)并输出子任务与动作 token(Subtask Action tokens),负责离散自回归规划;CLAP-RF 则在 VLM 之上附加一个连续动作专家(Action Expert),通过读取 VLM 内部的键值表征(R/V)来蒸馏语义,负责高频精确控制,直观体现了 "一个隐空间、两套输出范式" 的分层设计 。
实验

该表格报告了模型在真实世界部署中面对三类环境扰动时的鲁棒性表现,即换上有花纹的桌布以大幅改变视觉纹理的背景变化、显著改变光照强度与色温的光照变化、以及把目标物体替换为训练中未见实例并引入干扰物的新物体场景,评测任务为拾取放置(P&P)和关盒盖(Close)两项,每项按四种设置记录成功率并给出均值;结果显示 CLAP-RF 的总体均值最高(66.7%),明显超过强通用基线 π0.5(56.7%)、π0(46.7%)和同样基于隐动作的 UniVLA(16.7%),其中在背景改变下 CLAP-RF 仍保持 80% 的拾取放置与 70% 的关盖成功率、在新物体下分别达到 80% 与 70%,说明其对比式目标有效把动作相关信息与视觉噪声解耦;相比之下 UniVLA 因基于重建的目标编码了过多无关视觉细节而对分布偏移非常脆弱,π0.5 凭借大规模预训练在光照变化上尚具竞争力,但在精度要求高的关盖任务上仍不及 CLAP-RF(60% 对 50%),从而验证了显式动力学对齐即使在感知偏移下也能保持精细控制能力 。