搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
央视《超级工程》揭秘:算力越大,越考验网络!
>
央视《超级工程》揭秘:算力越大,越考验网络!
数智幸福产业
2026-10-06
11
导读:当网络不再受制于规模,算力的上限才真正被打开
近期,一部央视纪录片引起了整个行业的关注,包括我在内的许多业内人每晚都守在电视机前,等着
CCTV9
的节目播出。这就是讲述首个全国产十万卡
AI
超集群,从规划、研发、建设到落地应用全过程的四集大型纪录片
——
《超级工程
——
曙光
8000
》。
我原本以为,这种系统级介绍算力集群的片子,主角应该是各种芯片
——
多少算力、多少核心、多快
速度
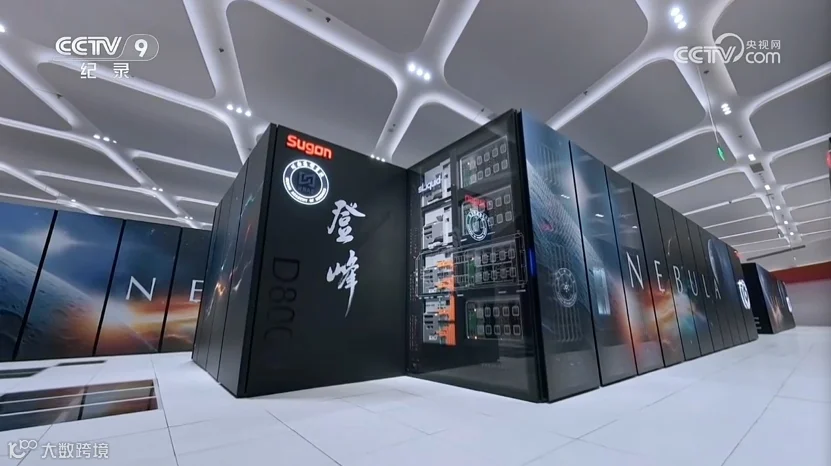
。结果看完发现,曙光
8000
可谓是众多顶尖技术的
“
集大成者
”
,也不仅是算力领先这么简单。其中最让我印象深刻的,是一根网线。
纪录片中,曙光
8000 AI
超集群高速互连网络总架构师万伟站在机房旁对工程师说:
“
你们去把那个线拔一下。
”
工程师走过去,手动断开了一条网络通路。监控屏幕上,系统只轻微抖动了一下,就恢复了稳定运行。这完全颠覆了不少人对于
“
拔网线
”
的认知,也说明决定算力能不能真正释放的,往往不是芯片本身,而是芯片之间那根
“
看不见的线
”
。
网络为什么成了十万卡集群的关键环节
01
一直以来,超大规模算力集群往往要承担最顶尖也是最繁重的科研任务,纪录片中对此也进行了详细的介绍
——
清华大学孙健团队要构建米级网格的
“
数字黄河
”
,追踪黄河泥沙的迁移轨迹;复旦大学冯建峰团队要在计算机里一比一复刻人脑,让
860
亿个虚拟神经元在数万张计算卡上并行运转;中国气象局依托曙光
8000
,将全球
5
公里分辨率、未来
10
天的预报计算压缩到
1
小时
……
这些任务有一个共同特征:它们都不是
“
一张卡能算完
”
的问题。复杂任务被拆解到上万个计算单元上,每个单元算完自己那一小块,必须立刻把结果传给下一个单元,再接收新的数据。芯片之间能不能顺畅通信,直接决定了任务能不能跑起来、跑多快。要知道
在大规模分布式训练中,网络通信耗时占比已达到
30%
到
50%
。
芯片算得再快,如果数据传不过去,算力就得停下来等。
等待固然让人烦躁,但更可怕的是,错误一定会出现。万伟在纪录片中解释了这个看似反常识的现象:原本信号在高速网络中传输,出错是一个概率性事件。单条链路的故障概率很低,但十万卡集群的规模把这个小概率放大了。他给出的测算很直观:单条链路每小时故障概率
0.00258%
,乘以系统
104500
条高速链路,得到链路传输错误期望
——
每小时约
2.7
次。
问题不在于错误本身,而在于传统方案处理错误的代价。一般来说,链路故障发生后,系统需要通知控制中心,重新计算全网路由,再下发指令。系统规模达到一万卡时,查找和纠错的
时间
超过
30
秒;到了十万卡,这个时间长达
5
分钟。
5
分钟的通信中断,意味着所有计算任务归零重来。万卡集群里,
1%
的网络性能损耗,就意味着算力白白浪费。
这不是某一款产品的问题,而是传统中心调度架构的固有天花板。集群规模越大,故障恢复越慢
——
这是一条不断放大的负反馈曲线。要打破它,需要的不是优化,而是换一条路。
让交换芯片
“
自己修路
”
:从分钟级到毫秒级的跨越
02
面对
“
规模越大、恢复越慢
”
的难题,万伟和团队没有继续在中心调度上做优化,而是从人流穿梭的十字路口找到了灵感。在
北京
最繁华的路口,没有人逐一告诉每个人该往哪里走,每个人只做一次简单判断
——
向左一步,向右一步,快一点或慢一点。无数个微小的选择,最终让拥挤的人流有序穿过路口。
万伟在采访中说:
“
这就是我们网络自主决策想要达到的目标。
”
他意识到,真正需要变革的不是网络的调度方式,而是赋予网络设备自主应变的能力。为此,团队在交换芯片中植入
“
智能开关
”
,并为每一个地址预设备用路线。一旦检测到路径故障,开关以毫秒级速度自行将信号切换至备选路径,无需等待调度中心的指令。
为了更好地理解这一点,纪录片中还播放了智能工厂送货小车的画面,其核心就在于四个字
——“
去中心化
”
。当然这种调整需要调动全局力量进行配合,需要不同部门的有效协同:
“
芯片团队需要给交换机增加切换的能力,这是一切自主的基础。同时软件团队需要确保他下发的局部路由策略,从全局
角度
来讲也是最优的。最后高速信号团队也需要进一步降低最终的故障概率。
”
以往的传统方案是
“
链路故障
→
通知控制中心
→
重算全网路由
→
下发指令
”
,规模越大恢复越慢。曙光
8000
的方案是
“
故障发生
→
本地智能开关自主判断
→
切换预设备用路线
→
恢复
”
,这条路径短得多,也快得多。更关键的是,恢复时间不再随网络规模增长而延长。
至此,也就有了文章开头我们提到的
“
拔网线
”
那一幕。当工程师手动断开一条网络通路,网络系统监控程序只轻微抖动,便恢复稳定运行,交换芯片将网络信号切换至备用线路,完成了对备用路径的自主切换。一切都是那么自然、那么丝滑,似乎故障完全不曾发生。
全栈设计:从自研高速
IP
到网络软件的系统工程
03
为了适配这套设计思路,曙光
8000
的网络子系统也实现了突破性的创新。
今年
3
月,中科曙光正式发布
scaleFabric
,这是国内首款全栈自研的
400G
原生无损
RDMA
高速网络,你可以把它理解成是一款国产
IB
网络。
全栈自研覆盖网络软件、组网方案、网络设备、网络芯片、信号收发五个层面,基于原生
RDMA
架构,面向大规模智算集群的高速互连需求。
最底层也最关键的是信号收发,即
自研
112G
高速
SerDes IP
。它被称为
IP
行业的
“
皇冠
”
,直接决定高速互连
质量
的上限。向上则由网卡、网络芯片和交换机构成高速互连底座。
scaleFabric
可提供
400G
高速接入,交换容量达到
64Tbps
,交换时延低至
260ns
,网卡通信时延达到
0.93
微秒级。
在软件与组网方案的协同方面,
scaleFabric
采用基于信用的无损流控机制,先确认接收端有空闲缓冲再发送数据,从根源上规避拥塞丢包风险,链路故障恢复时间小于
1
毫秒。同时兼容现有
IB
应用生态,并行计算、大模型训推等应用无需修改代码即可迁移,实现应用无感适配。
至此,
scaleFabric
的价值已经不只是“快”:它既要支撑十万卡级规模扩展和
400/800G
高速互连,也要在链路故障时实现毫秒级自主切换,并兼容主流
AI
和高性能计算应用生态。它给计算供带宽、给存储通道路、给监控传数据、给调度提信息、给容错当哨兵、给软件做底座,把各子系统焊成了一台完整的超级系统。
今年
9
月,中科曙光进一步发布
scaleFabric Token
加速技术体系,以原生无损
RDMA
高速网络为核心,通过计算、存储与网络协同,减少数据传输和读取过程中的等待,提升大模型运行效率。其中,支持计算卡直接发起网络通信的
IBGDA
技术已在十万卡级集群中完成验证,实现国内首次规模化落地。
在实际应用中,
中科曙光联合龙讯旷腾,依托曙光
8000
与
MatPL
机器学习力场软件,在全球范围内首次实现具有量子力学精度的
“
万亿原子
”
分子动力学模拟。整体弱扩展效率高达
86.9%
,通信开销仅
4.26%
,
体现了大规模并行条件下计算与通信协同的效率。
让十万张芯片之间的每一次数据交换,都快到不成为瓶颈,稳到不中断任务,曙光
8000
的网络子系统在背后承担着一个朴素但关键的角色,而
scaleFabric
所验证的也不仅是高速网络的技术能力,更是一条从底层
IP
到上层应用全栈自主设计的路径
——
当网络不再受制于规模,算力的上限才真正被打开。
正如万伟在采访中说的那样,
scaleFabric
未来可以支持
20
万乃至百万卡,是支撑更大规模算力发展的重要基石。
【声明】内容源于网络
0
0
数智幸福产业
使命:让城市更美好,让生活更幸福!愿景:致力于服务中小微企业主及创新创业者,打造全新幸福产业生态平台——以产业为引导、地产为载体、人才为核心,数智科技/智慧城市/双创基地/资产管理/幸福学院!政校企/产学研,大脑更新,城市更新,创变者赢未来
内容
262
粉丝
0
关注
在线咨询
数智幸福产业
使命:让城市更美好,让生活更幸福!愿景:致力于服务中小微企业主及创新创业者,打造全新幸福产业生态平台——以产业为引导、地产为载体、人才为核心,数智科技/智慧城市/双创基地/资产管理/幸福学院!政校企/产学研,大脑更新,城市更新,创变者赢未来
总阅读
8.4k
粉丝
0
内容
262






 数智幸福产业