

Baseten 工程师 Shawn Rushefsky 分享了一次实验:给 Claude Code 一张 GPU,让它为指定模型写一套推理引擎,再持续优化到跑赢 vLLM。
Claude Code 使用的是 Fable 5,任务模型是 Qwen-3.6-35B-A3B。最终生成的引擎叫 VibeQwen,在 NVFP4 精度、单张 NVIDIA B200 上,单流解码速度比调优后的 vLLM 0.25.1 高约 90%,并发 32 时,单副本的输出吞吐也高了 71%。
实验在 7 月下旬进行。Claude 主要自主工作了大约一周,消耗约 200 个 B200 小时,工程师偶尔调整方向,并确认涉及准确性的改动。

Baseten 分享的智能体推理优化实验
给 Claude 一张 B200 和一个目标
这件事的起点是一篇论文。Rushefsky 在公司的论文讨论频道里看到了 MetaInfer:把推理系统的知识整理成 Skills,交给编码 Agent,按指定部署条件生成专用引擎。他起初有些怀疑,于是拿一个模型试了起来。
vLLM、SGLang 这类引擎要接住许多模型、硬件和请求形态;VibeQwen 的题目窄得多:模型选好了,权重精度选好了,GPU 也选好了。Agent 可以围绕这组条件安排执行路径,把时间花在对应的瓶颈上。MetaInfer 正是把这种按需定制当作出发点。
Rushefsky 给 Claude Code 准备了论文、项目仓库、通过 SSH 使用 B200 工作站的权限,以及两份模型权重:NVFP4 量化版用于目标部署,原始全精度版用于检查结果。Baseten 内部的 Skills 和 MCP 工具,则让 Agent 能部署候选引擎,并对实际服务端点运行 AIPerf 压测。
目标也很具体:在准确性不低于 NVFP4 基线的前提下,各项性能指标都超过 vLLM 20%。有了这些条件,Claude 才能判断一次修改究竟让引擎前进了多少。
这里还有一个很实际的取舍。MetaInfer 论文研究了不直接读取现成推理框架源码的生成方式,Baseten 的实验允许 Claude 参考 vLLM 和 TensorRT-LLM,复用已有的高性能算子,需要时再自己写。因此,这套引擎也包含对既有工程成果的利用。
MetaInfer 提供的知识并不只是“怎样写 CUDA”。它把组件的接口、张量形状、数据类型、设备位置和状态变化写成契约;Agent 依据契约实现代码,再接受规格检查和固定测试。测试失败,执行结果回到实现环节;发现有效修复,则把可复用的经验写回知识库。
这样,一轮工作有明确的去向:写出候选代码,检查它是否满足约束,实际运行,拿到正确性和性能反馈,再决定下一步。Baseten 又把测量范围扩到了服务栈,用部署、负载均衡和实际端点的压测检验优化,而不只看一个孤立算子跑得多快。
工程师仍要照看这个过程。Rushefsky 会偶尔调整方向,避免 Claude 过度盯住某一种流量形态;遇到影响数值结果的改动,Claude 也会停下来请求确认。最后他允许输出与参考 NVFP4 实现存在细微数值差异,但要求相对于 BF16 基线的整体准确性至少一样好。具体准确性评测的任务集和逐项结果,文章没有展开。
一周以后,快在哪里
VibeQwen 在头几天就达到了与 vLLM 相近的水平,Rushefsky 随后让它继续优化。较小模型早期的表现不理想,他还要求所有子 Agent 使用 Fable 5;上下文在长时间运行中经历了多次自动压缩。
整个项目用了约 17 亿 token,其中绝大部分是缓存输入。作者给出的 VibeQwen 项目成本是数千美元量级;大量缓存输入会影响计费,因此只看 token 总数,很难还原这笔开销。
最终对照的是实验时使用的 vLLM 0.25.1,双方均在单张 B200 上运行。公开文章给出了三组结果。
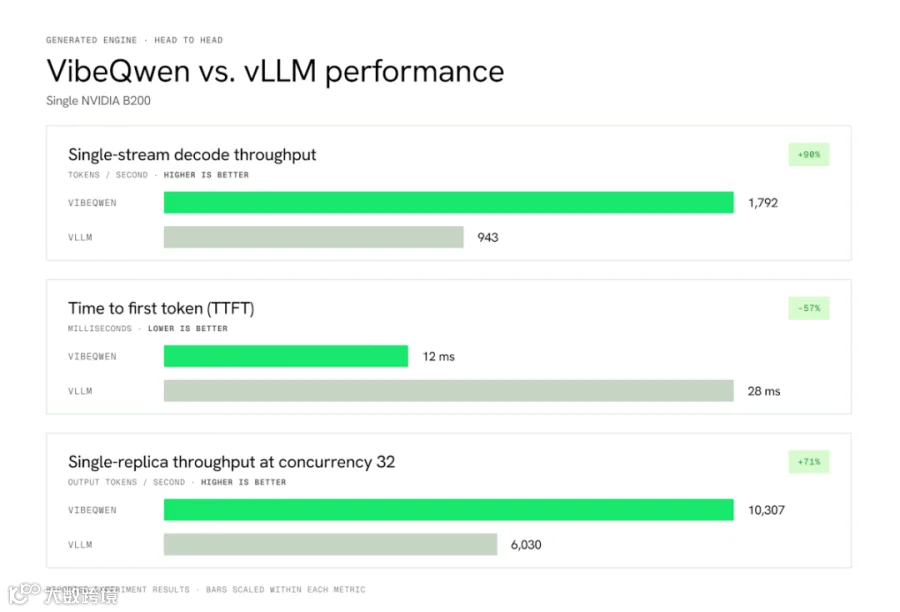
VibeQwen 与 vLLM 的单流解码 首 token 时间及并发吞吐对照
单流解码从 vLLM 的 943 token/s 提高到 1792 token/s,约为原来的 1.90 倍,也就是速度高了 90%。原文特意说明,这是适合推测解码的重复、结构化文本。
推测解码先提出一段候选 token,再由目标模型验证;候选被接受得越多,越有机会一次推进多个 token。文本是否容易预测,会影响这类加速的收益。vLLM 本身也支持推测解码,但 Baseten 没有公布双方完整配置和各项优化的消融结果,因此还无法拆出这 90% 分别来自哪些改动。
首 token 时间从 28ms 降到 12ms,等待时间减少约 57%。这衡量的是请求发出后多久开始返回内容,前面的解码速度衡量的是开始输出后生成得多快。
当单副本并发达到 32,总输出吞吐从 6030 提高到 10307 token/s,约为 vLLM 的 1.71 倍。收益也出现在多个请求同时运行时。作者称 VibeQwen 在所有已测流量形态上都超过了对照,完整的负载矩阵尚未在文章中列出。
写完引擎,还留下了什么
第一轮结束后,Rushefsky 把更新过的知识库用到了另一种模型上:图像分割模型 SAM 3.1。这次生成的推理服务叫 Sammie,输入图片和文字提示,输出对应物体的分割掩码。
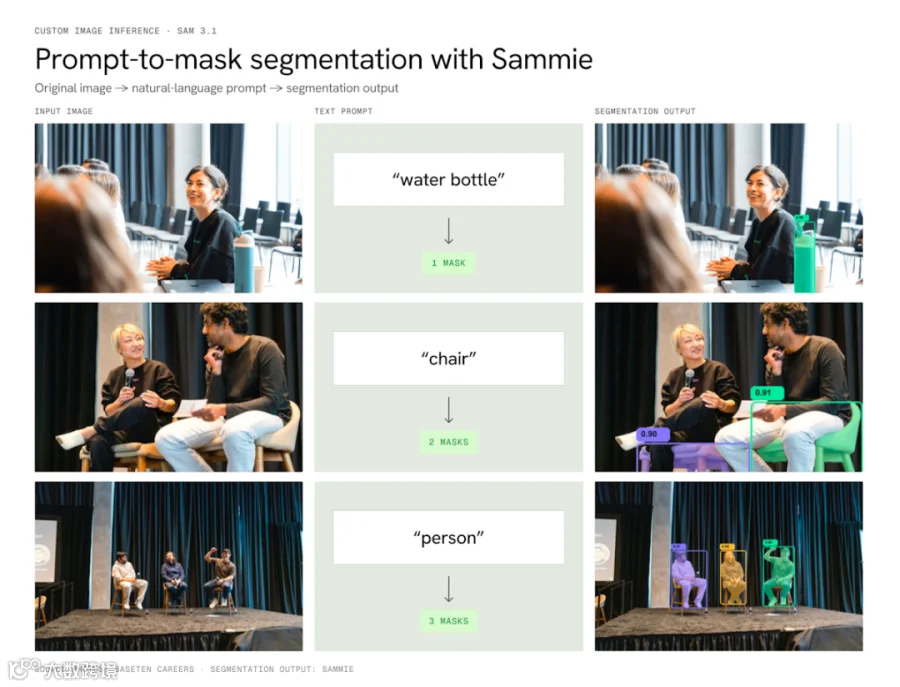
Sammie 根据 water bottle chair 和 person 提示返回对应物体的掩码
在单张 H100 上,Sammie 达到每秒 91 张图,比 Meta 的参考服务器吞吐高 50%。这一轮只花了几天、约 2 亿 token,作者描述的成本为数百美元量级。
第二次更快完成,给知识复用留下了一点想象空间。不过模型架构、GPU 和任务都变了,也没有不复用知识库的对照实验,暂时还不能把节省的时间全部归功于上一轮经验。
VibeQwen 和 Sammie 都仍是实验项目,没有承接生产流量。它们展示的是一条已经跑出结果的工程路径:固定部署条件,为 Agent 配好真实测试,让它把大量候选实现试过去,再把有效经验留给下一次。
对长期运行同一模型的服务而言,这种投入值得算一笔账。一次性的开发和 GPU 实验开销,能否换来此后持续的吞吐收益,取决于服务规模和真实负载。Baseten 的实验至少让“给这个模型单独写一套引擎”变成了更具体的选择。
参考链接
-
Baseten 工程实验原文:https://www.baseten.co/blog/agentic-inference-optimization-faster-than-sota/ -
MetaInfer 论文方法:https://arxiv.org/html/2607.12875v1 -
MetaInfer 项目仓库:https://github.com/HuangPuStar/MetaInfer