

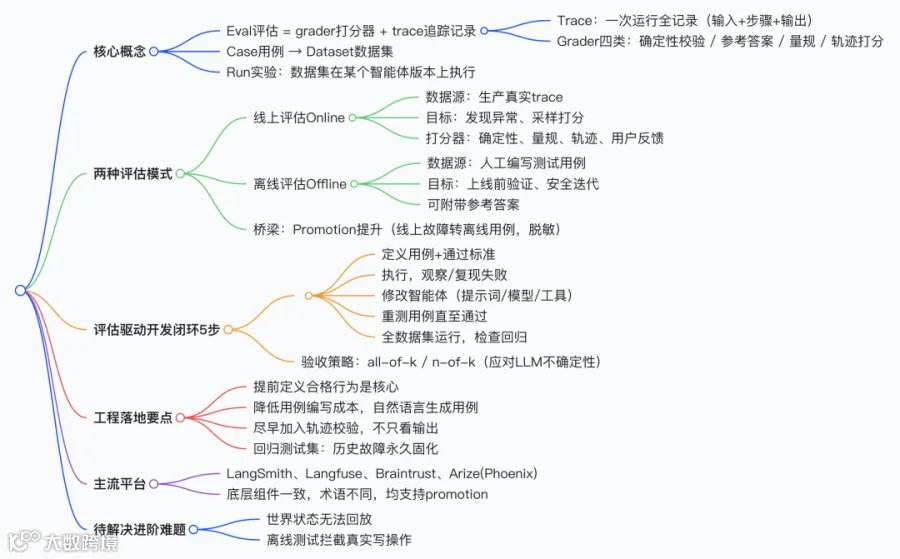
编者摘要:本文提出面向 AI 智能体的评估驱动开发,指出仅靠人工测试提示词不足以保障智能体上线稳定,必须建立系统化评估体系。评估的基础单元是 trace(智能体完整执行追踪记录)+ grader 打分器。打分器分为四类:确定性代码校验、参考答案比对、量规打分、执行轨迹打分;其中轨迹打分关注工具调用步骤,弥补仅校验最终回答的缺陷。
评估分为线上评估与离线评估:线上采样生产 trace 自动打分,发现真实用户场景下的异常;离线在 CI 环境执行测试数据集,验证预期行为、迭代修复。两者通过提升(promotion)打通:将线上发现的故障 trace 脱敏后转为离线回归用例。
评估驱动开发遵循五步闭环:定义用例与验收标准 → 执行并复现失败 → 修改智能体逻辑 → 重测单条用例 → 跑全数据集防止回归。由于大模型存在随机性,需要设置多次重复运行的判定规则(all-of-k /n-of-k)。
文中对比 LangSmith、Langfuse、Braintrust、Arize 四大评估平台,它们底层模型一致,只是术语命名不同。作者强调:评估的真正难点不是选工具,而是定义合格行为;同时要简化用例创建流程,从早期就加入轨迹校验。文章预告后续将解决两大难题:业务状态无法回放、离线测试拦截真实写操作。
Q&A(10 个关键问题)
-
Q:为什么手动测试少量提示词不足以验证 AI 智能体? A:人工只能覆盖少数场景,无法捕捉长尾用户输入;评估体系可以批量、自动化持续验证,捕获回归缺陷。 -
Q:trace 追踪记录在评估体系里起到什么作用? A:trace 保存智能体完整执行过程;没有 trace,无法做轨迹打分,也无法把线上故障复现为离线用例,评估很难落地。 -
Q:四类打分器分别适合什么场景? A:确定性校验优先用于可代码判断的规则;参考答案打分器适合有标准答案的离线用例;量规打分适合无标准答案、评估风格合规性;轨迹打分用来校验工具调用步骤与决策路径。 -
Q:大模型裁判(LLM-as-judge)本身可靠吗? A:不可靠。需要用人工标注做一致性校验,一致性不足时修改评判量规;修改裁判规则后,要重新校验裁判本身。 -
Q:线上评估为什么一般不使用参考答案打分器? A:生产环境真实用户请求没有预设参考答案,因此线上评估依赖规则、量规、轨迹打分和用户反馈信号。 -
Q:什么是 promotion 提升?价值是什么? A:把线上异常 trace 脱敏,转为离线回归测试用例。打通线上问题发现和线下修复验证,持续扩充测试数据集。 -
Q:评估驱动开发和普通 TDD 有什么异同? A:思路同源,都是先定义预期结果再开发。区别在于面向大模型智能体,要处理 LLM 随机性、工具调用轨迹,验收标准需要支持多轮重复判定。 -
Q:为什么修复 bug 之后,必须跑完整数据集而不只跑修复的那条用例? A:修改提示词 / 工具逻辑,有可能破坏其他场景,全数据集运行用于捕获回归问题。 -
Q:all-of-k 和 n-of-k 怎么选择? A:高风险业务(资金、订单)用 all-of-k,零容忍单次失败;允许一定波动的场景,用 n-of-k(如 3 中 2)。 -
Q:选型评估平台最核心的能力要看什么? A:看是否支持 trace 追踪、支持线上 trace 直接提升为数据集用例,这是整套 eval 体系的核心,其余都是配套功能。
作者:JAKE KLARISTENFELD・2026 年 10 月 2 日
你可以靠 “凭感觉写代码” 做出一个具备基础能力的应用,但不能靠 “凭感觉测试” 就直接交付。微调提示词、手动尝试少量输入的作用有限;评估(eval)才是让智能体具备上线能力、并且上线后稳定运行的关键。
团队经常会问该选用哪款评估工具,市面上有不少好用的选择:Langfuse、Braintrust、LangSmith,这里只列举几个。但没有任何工具能替你定义智能体应该做到什么行为;这部分必须由你自己完成。
这就是评估驱动开发(eval-driven development):定义合格行为标准,对照标准测试智能体,迭代优化直至达标。每一个重大故障都要转化为回归测试用例 —— 每次代码变更后都重新执行该用例,一旦故障再次出现就能立刻发现。
下文会先介绍所有评估工具通用的四大基础组件,再将其融入一套五步流程,适用于开发新能力或是修复线上发现的故障。
如果你刚接触评估,或者并不亲自构建智能体,可以先阅读我们的实战手册:https://www.tenex.co/playbooks/due-diligence-your-first-agent-eval
什么是评估(eval)?
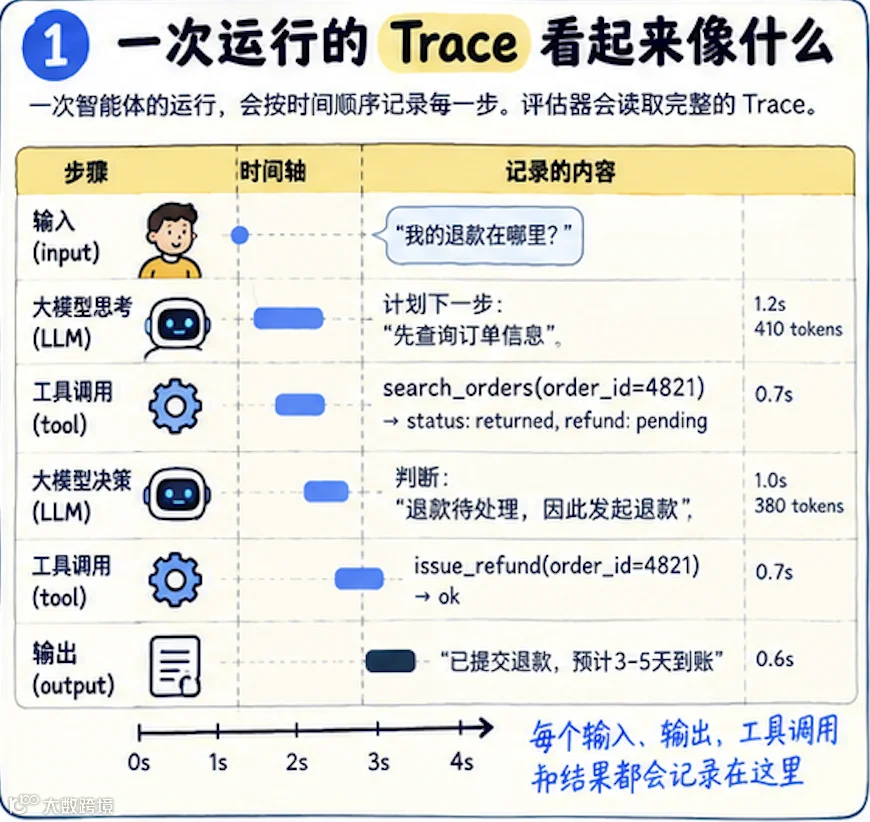
评估 = 对一条追踪记录(trace)执行打分器(grader)。

- 打分器(grader,也叫 evaluator 评估器 /scorer 评分器)
用于评判智能体表现好坏的组件,简单的可以是代码校验逻辑,复杂的可以是充当裁判的大模型。 - 追踪记录(trace)
单次智能体运行的完整记录:用户输入、智能体执行的每一步、最终输出。
举个例子:客户提问 “我的退款什么时候到?”,智能体先调用search_orders查询订单,再调用issue_refund发起退款,最后回复 “退款已发起,3–5 个工作日到账”。这条完整执行记录就是一条 trace。
没有追踪能力,评估很难落地。如果你还没有搭建可观测体系,优先做这件事。
其余所有能力都属于配套工程:把 trace 送入打分器,并且对分数做后续处理。
- 用例(Case,也叫数据集条目、示例、测试用例)
包含待测试输入,以及这个输入对应的 “合格标准”。大量用例构成数据集(dataset)。部分用例附带参考答案;另一些仅指定执行完成后需要调用哪些打分器。 示例:客户订单 #4821 存在待处理退款,用户提问 “我的退款什么时候到?”,预期回复:“您订单 #4821 的退款已发起,预计 3–5 个工作日到账。”
- 运行任务(Run,也叫实验 experiment)
使用某一特定版本提示词 / 智能体,执行数据集内全部用例。每条用例生成一条 trace,每条 trace 都会被打分。一次 Run 是一个快照:“版本 X 在数据集 Z 上得分 Y”。对比多次 Run 的结果,可以判断本次智能体改动是否真的带来提升。 示例:退款数据集一共 40 条用例,在当前智能体上执行。v3 版本通过 36 条;修改提示词后的 v4 版本通过 39 条。说明本次改动有效,并且可以定位到仍然失败的那条用例。
四类智能体打分器
打分器分为四大类,实际工程中通常会在同一条 trace 上同时运行多个打分器。我们继续用上面退款案例举例说明:
- 确定性校验(Deterministic checks)
纯代码实现,不依赖大模型。
校验逻辑:智能体是否恰好调用一次 issue_refund,并且传入的订单 ID 和查询到的订单一致?重复退款、给错误订单退款会直接判定失败。 优点:低成本、速度快、判定结果无歧义,能使用的场景优先使用。
- 参考答案打分器(Reference-answer graders)
将输出结果与用例预先存储的参考答案对比,可以精确字符串匹配,也可以由大模型裁判判断语义是否一致。
用例保存标准答案:“您订单 #4821 的退款已发起,预计 3–5 个工作日到账”;裁判判断 “退款已发起,3–5 天到账” 语义等价。 局限:需要提前写好参考答案,线上真实流量没有标准答案,因此多用于人工编写的测试用例。
- 量规打分器(Rubric graders,用于风格、语气、诊断)
大模型裁判依据多项标准打分,不需要参考答案。
校验维度:回复是否简洁?是否确认处理结果?是否告知用户退款未到账时该如何操作? 前面的退款示例就会被这条规则标记 —— 这正是量规打分器的价值:可以捕捉参考答案打分器漏掉的问题。 无需参考答案,因此可以用于任意 trace,包括线上生产环境的记录。
- 执行轨迹打分器(Trajectory graders)
评判智能体的执行步骤,而不仅仅看最终回答。
校验逻辑:发起退款前,是否先查询订单? 如果智能体没有查询订单就直接退款,或是重复调用 12 次订单查询接口 —— 哪怕最终回复文字完全正确,依然判定失败。 缺点:运行更慢、成本更高,打分器自身也更容易出错。
大模型裁判本身也需要校验。裁判本质上也是一段提示词,同样会出错。在信任上面这个量规裁判之前,可以让团队人工标注几十条退款回复的通过 / 失败结果,统计裁判和人工标注的一致性。如果一致性偏低,要先修改裁判评判标准,再依据分数做决策;每次修改裁判规则后,都需要重新校验。
ultrathink 全球顶级 AI 应用通讯周刊 每周二,4 万多名企业管理者和技术建设者,会收到一份实战拆解,附本周优质工具、文章与思路。 邮箱 免费订阅 ultrathink 订阅即表示同意接收 Tenex 的营销邮件,并接受我们的服务条款与隐私政策。随时可以取消订阅。
线上评估 vs 离线评估,区别在哪?

核心差异:被打分的 trace 来自哪里
- 线上评估(Online evals)
trace 来自生产环境真实用户 / 系统,记录已经存在,我们只需要对它打分。 - 离线评估(Offline evals)
场景还没有被执行,需要测试用例触发运行、生成 trace,再执行打分。
两种场景下 trace 的数据结构完全一致。其余差异(可用打分器类型、可控程度)都由数据来源决定。
线上评估用于监控生产。打分器自动对真实 trace 打分(通常采样执行,控制大模型裁判成本),目标是发现异常行为。生产数据一般没有参考答案,因此线上评估依赖确定性校验、量规、轨迹打分器,以及用户反馈(点赞 / 踩、重试操作)这类信号。
离线评估在测试环境运行:按需触发,或是在 CI 流水线自动执行,上线前完成。目标是验证预期行为,安全迭代修复方案。数据集由领域专家编写,因此可以附带参考答案。
两种评估缺一不可:只做线上评估,能看到问题,但没有安全手段验证修复方案;只做离线评估,你测试的只是你预想的场景,而非用户真实会遇到的场景。
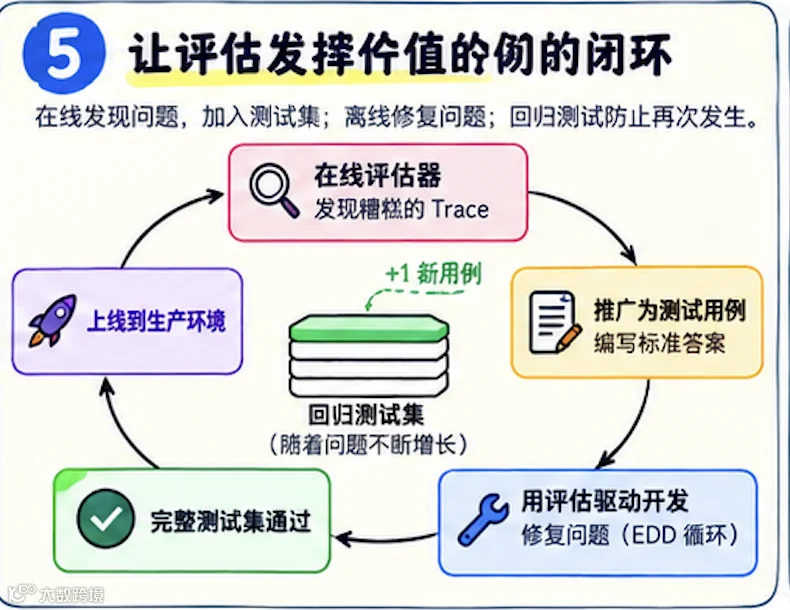
连接两者的核心操作叫做提升(promotion):把线上发现的异常 trace,转化成离线测试用例。
什么是评估驱动开发?
评估驱动开发 = 面向智能体行为的测试驱动开发(TDD)。 在修改提示词、指令、工具能力定义之前,先定义 “正确行为”;然后运行智能体,迭代直到满足标准。

测试用例与合格标准有两个来源:
- 主动构建(Proactive)
开发功能前就定义行为。适合还没有线上流量的起步阶段:为想要实现的能力、以及你认为已经稳定的能力编写用例。
示例:客户询问待处理退款时,智能体需要查询订单、发起退款,并告知用户预计到账时间。
- 被动修复(Reactive)
线上打分器或用户标记了一条异常 trace,将其提升为测试用例。
示例:真实客户询问退款,智能体回复无法处理。把这条 trace 提升为用例,输入保持不变,定义合格行为:查询订单、发起退款,并告知用户预计到账时间。
无论哪种来源,都需要定义清楚合格行为。后续遵循同一套闭环:
- 定义用例与通过标准
编写输入,绑定打分器。参考答案打分器需要预设答案;量规打分器只需要评判标准。 - 执行用例,观察失败
如果还未修改代码就直接通过,说明能力本来就满足,或是这个用例没有测到目标逻辑。对于从线上提升的 trace,这一步同时验证故障可以离线复现。 - 修改智能体
调整提示词、基础模型、系统指令、工具描述、技能逻辑。 - 再次运行
重复 3、4 步,直到用例通过。 - 执行完整数据集(不止当前这条用例),捕获回归问题。
提前定义判定标准。大模型具有不确定性,同一个输入这次通过、下次失败很正常,单次通过不代表可靠。每条用例多次运行(k 次),明确设置验收门槛:
- 全部通过(all-of-k)
高风险场景,一次失败都不能接受,例如给他人订单退款。k 次全部通过不能保证永远不出错;但只要出现一次失败,就证明风险存在。 - 部分通过(n-of-k)
:允许一定波动,例如 3 次中至少 2 次通过。
将线上故障转化为测试用例
提升(promotion)是连接线上、离线评估的桥梁。取出被标记的 trace(没有追踪与线上评估,很难捕获这类故障!),把用户输入复制为新用例,再定义合格行为。故障对应的错误输出不能当作参考答案,需要人工给出正确结果。
提升后的 trace 属于真实用户数据,加入团队共享数据集前,必须脱敏所有敏感信息。
简化用例编写
不同评估平台创建数据集的方式各不相同:JSON、CSV、页面表单等。建议搭建一套自然语言创建用例的能力,降低团队成本。你可以直接向 Claude/Codex 下达指令,自动生成平台所需数据集格式:
“创建用例:客户申请 90 天以上旧订单退款。智能体需要解释退款时效,并且禁止调用 issue_refund。”(主动用例) “基于线上 trace 创建用例:{标记的 trace_id}。智能体回复无法处理;合格行为是查询订单、发起退款,并告知用户预计到账时间。”(被动用例)
构建回归测试集
评估驱动开发闭环的第 5 步要求执行完整数据集:修复 A 问题的提示词改动,可能悄悄破坏其他功能。如果你只重新运行正在修复的这条用例,这类回归问题会被遗漏。
每次重要代码变更,都执行全数据集(最好集成到 CI 流水线),并和上一轮结果对比。久而久之,每一个线上事故都会被固化为永久测试用例。你的数据集就会记录智能体曾经踩过的所有坑,一旦同类故障复发,就会被拦截。
整体链路:线上评估发现问题 → 提升转化为用例 → 离线闭环修复 → 持续增长的数据集保障问题不再复发。
新手团队必看要点
- 定义 “合格行为” 才是核心工作
开发前就写下预期行为,包括那些你自以为已经稳定的逻辑。写的时候你经常会发现,很多能力其实并不达标。 - 尽量简化用例创建流程
如果把线上故障转成用例,需要多页面跳转、手写 JSON,大家会嫌麻烦而放弃,数据集就无法持续积累。给团队提供一键提升 trace、单行输入预期行为的能力,搭配前面说的用例自动生成工具。 - 尽早评估执行轨迹
有的智能体绕 30 轮工具调用,才完成本可以一步搞定的任务,最终回答看起来完美;只校验输出内容的打分器完全发现不了。从项目初期就至少增加一条轨迹校验规则。
四大主流平台简要对比
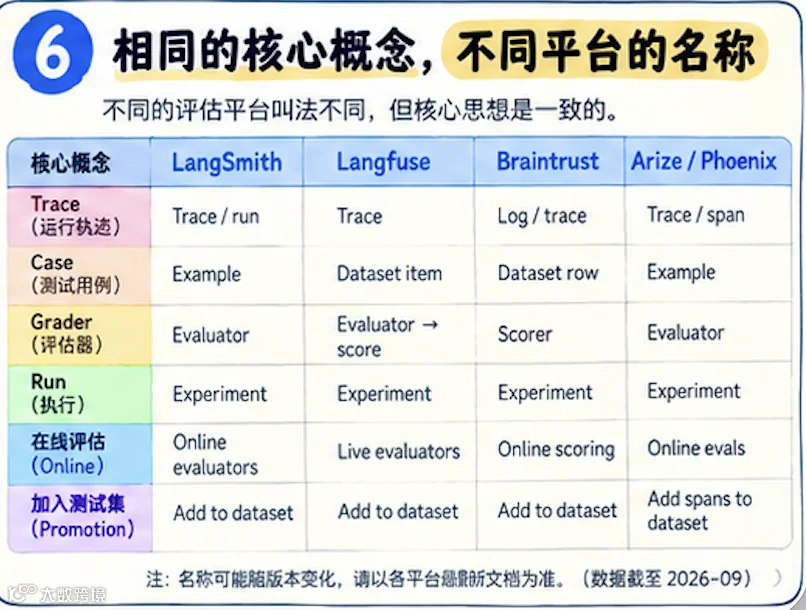
理解这套模型后,你会发现各大平台底层组件高度一致,只是命名不同:
-
LangSmith:用例 = examples 示例,打分器 = evaluators 评估器,运行 = experiments 实验。线上评估器基于规则打分生产 trace,失败 trace 可以直接加入数据集。 -
Langfuse:用例 = dataset items 数据集条目,打分结果 = scores 分数,运行 = experiments 实验(旧称 dataset runs 数据集运行)。大模型裁判可以对线上 trace 打分,生产记录可以直接加入数据集。 -
Braintrust:用例 = records 记录,打分器 = scorers 评分器,运行 = experiments 实验,生产 trace=logs 日志。支持采样 + 过滤规则对日志打分,日志记录可以直接提升到数据集。 -
Arize AX / 开源 Phoenix:用例 = examples 示例,打分器 = evaluators 评估器,运行 = experiments 实验。生产链路 span 可以直接加入数据集。
所有平台都支持 “提升” 这个流程,因为从线上数据回流到数据集,是整套评估体系的核心。 这个领域术语迭代很快,选型前务必查阅各工具最新文档。
后续预告:当 trace 无法复现的时候
整套模型的前提:你可以在离线环境复现 trace。简单提示词场景很容易做到:复制输入运行即可。但如果智能体读写真实业务系统,复现就会变得困难。这也是真实场景智能体评估的难点,本系列接下来两篇会专门讲解:
-
第二篇:回放世界状态。智能体行为依赖工具当时返回的数据。例如那条退款 trace 执行时, search_orders返回订单 #4821 待退款。一周后重新跑同样输入,这笔退款已经处理完成,智能体走向完全不同逻辑,提升后的 trace 无法复现。 -
第三篇:离线运行时拦截写操作。 issue_refund会产生真实资金变动。离线评估退款场景时,我们需要打分,但不希望 CI 流水线每次运行都触发真实退款。
常见问题(企业管理者最关心的问题)
什么是 AI 智能体评估?
评估 = 对一条追踪记录(trace)执行打分器。Trace 是单次智能体完整运行记录:输入、每一步动作、最终输出。打分器(评估器 / 评分器)评判智能体表现好坏,可以是简单代码校验,或是充当裁判的大模型。
线上评估和离线评估有什么区别?
区别在于 trace 来源。线上评估打分真实用户在生产环境产生的 trace,用来发现异常行为;离线评估使用人工编写的测试用例生成新 trace,可以按需执行或接入 CI,上线前验证预期行为,安全迭代修复。两者都需要。
什么是评估驱动开发?
面向智能体行为的测试驱动开发。修改提示词、指令、技能前,先用带打分器的用例定义合格标准;运行用例,观察失败;迭代智能体直到通过;最后执行完整数据集,捕获回归缺陷。
AI 智能体打分器主要有哪几类?
确定性校验(纯代码,无模型)、参考答案打分器(输出对比预设答案)、量规打分器(大模型裁判按标准打分,无需参考答案)、轨迹打分器(评估执行步骤,不只看最终回答)。实际项目一般在同一条 trace 上同时运行多种打分器。
如何把线上故障转化为评估用例?
提升(promote):复制被标记 trace 的输入,新建用例;然后定义合格行为(故障输出不能当作参考答案)。共享数据集入库前,脱敏用户敏感数据。提升后的用例,会和回归测试集一起,每次变更自动运行。