


这两年做独立站的外贸人,隔一阵就会被一个新名词追着跑。最近轮到了 llms.txt。群里有人转文章说"再不部署就错过 AI 入口了",也有人说"这就是个没人用的摆设"。两种说法都太急。对多数外贸站来说,这件事真正值得花的时间,可能只有半小时;但判断要不要花这半小时,得先把几个概念掰开。
它是什么,以及它明确不是什么
按 llmstxt.org 官方规范的说法,llms.txt 是一项"提议中的标准",目的是帮助大语言模型理解和使用网站内容。注意"提议中"三个字,这是它和 robots.txt、sitemap.xml 最根本的差别。
后两者是已经跑了很多年、被主流搜索引擎实际执行的机制:robots.txt 告诉爬虫哪些能抓哪些别抓,sitemap.xml 给爬虫一份页面清单。它们的对象是搜索引擎爬虫,规则清楚,违反有后果。llms.txt 的对象是大语言模型,形态是在网站根目录放一个 Markdown 文件,用标题和链接把站内重要内容整理成一份目录,方便模型快速看懂"这个站是干什么的、哪些页面值得看"。
所以它不是 robots.txt 的替代品,也不是 sitemap 的升级版。它更像一份给未来的自我介绍,格式友好、成本不高,但目前还不存在"谁必须读它"的约束。
采用量在涨,平台态度没跟上
有人会拿增长数据说服你。据 NerdyData 的统计,2025 年 7 月全球有 951 个域名发布了 llms.txt,到 2026 年 9 月是 16,670 个,约 14 个月增长约 17.5 倍。数字看着挺猛。
但换个角度看:数亿活跃网站里,这一万多个域名占比仍然极小。而且增长快往往说明"尝鲜的人多",不等于"受益的人多"。
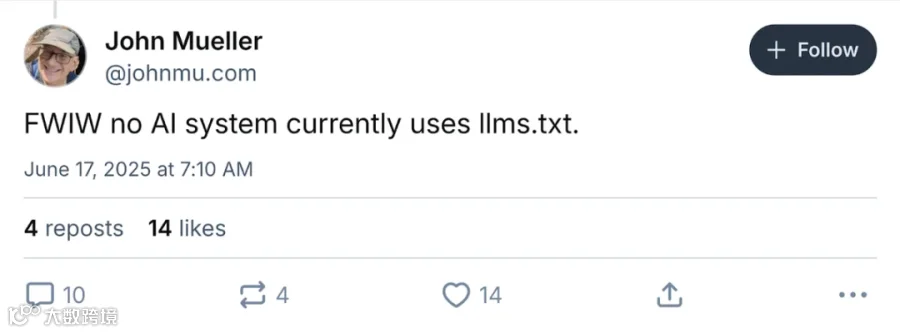
更关键的是平台侧。据报道,Google 的 John Mueller 曾在 2025 年 6 月于 Bluesky 上表示,AI 系统不使用 llms.txt。就目前披露的信息看,尚无主要 AI 平台确认会读取或依赖这个文件。
这就形成了一个落差:发布方在增加,消费方没表态。做外贸的人对这种局面不陌生——发布方在增加,消费方没表态,这种落差本身就说明:要不要提前准备,取决于准备的成本和你对趋势的判断,而不是取决于有多少同行已经做了。你要不要提前备着,取决于备的成本和你对这个市场的判断,而不是取决于有多少同行备了。
Semrush 做过一次更直接的测试。它在 Search Engine Land 部署了 llms.txt,分析 2025 年 8 月中旬到 10 月下旬的服务器日志,结论是部署该文件与 AI 结果中的表现提升之间没有相关性。那段时间里,Google-Extended、GPTBot、PerplexityBot、ClaudeBot 对该页面的访问次数为零,Googlebot 和 Bingbot 也只访问了几次。
这是单站点实验,样本有限,不能当成普遍结论。但它至少说明:文件放在那儿,不等于就会有人来读。
三个容易被读错的信号
现在网上流传着几种"证据",说 llms.txt 要起来了。逐个看,它们说明的东西比表面少。
第一,Google 在 Lighthouse 中新增了实验性的 Agentic Browsing 类别,其中一项检查会查找 llms.txt。很多人把这当成官方背书。但 Lighthouse 审计和实时抓取是两套独立系统,这项检查也不是正式评分项。它更像是 Lighthouse 团队在观察一个新趋势,把检查项先放进去看看,和"Google 搜索会读这个文件"是两回事。
第二,Anthropic 自己网站上放了 llms.txt。一家 AI 公司给自己的站点做这件事,容易被解读为"内部已经在用"。但企业官网放什么文件,通常由内容或工程团队决定,未必代表其模型训练或检索流程会去读别人的同名文件。这属于相关性很弱的信号。
第三,Google 提出的 OKF。这个概念目前版本是 v0.1,规范仍在演进。它反映的是行业在探索"怎么让机器更好理解站点结构"这个方向,但方向存在不等于 llms.txt 是那个答案。
把这三件事放在一起,能得出的判断只有一个:这个方向有人在试,但还没有形成事实标准。对预算和人力都有限的外贸团队来说,为一个尚未定型的标准投入大量精力,性价比不高。
外贸站怎么定:看内容成熟度,不看焦虑程度
回到最初的问题。我的判断是:llms.txt 目前更像一份写给未来的低成本占位动作,真正决定 AI 能不能用上你内容的,是页面本身是否被抓得到、读得懂,而不是多不多这一个文件。
具体分两种情况。
内容结构已经相对稳定、有清晰的产品页和服务页、站内目录自己能理清楚的站,可以顺手做一份。投入通常不高,把核心页面的标题和链接整理成 Markdown 放进根目录即可。做完之后,可以随着站内内容结构变化再决定是否更新。这种情况下它是低成本占位,做与不做都不影响基本盘。
内容本身还很薄、产品页还在频繁改版、公司连一个稳定的产品目录都拿不出来的站,先别碰。这时候写出来的 llms.txt 大概率是错的、过时的,写完两周就得重写。更实在的做法是把产品页先写清楚。
还有一点要说在前面:这个文件不保证提升 AI 回答中的曝光,也不保证带来引荐流量。任何把它说成"AI 搜索入场券"的说法,都超出了目前能验证的范围。
比这个文件更值得先做的事
如果只能做一件事,我建议先确认你的页面在基础 HTML 层面是不是可读的。据 Semrush 介绍,多数 AI 爬虫只能读取页面的基础 HTML,读不到 JavaScript 加载的内容。
这一条对外贸独立站的杀伤力比 llms.txt 大得多。很多建站方案为了视觉效果,把产品参数、规格表、应用场景全用 JS 动态渲染。人用浏览器看着正常,爬虫抓到的却是一个空壳。你花力气写的产品描述,在 AI 眼里可能根本不存在。
检查方法不复杂:打开一个重点产品页,在浏览器里禁用 JavaScript 刷新,或者直接查看网页源代码,看正文内容在不在里面。如果源代码里只有一堆脚本标签、看不到产品文字,那问题就清楚了,优先修这个。
第二件事是把产品页写成买家问题的直接回答。海外买家在 AI 里问的往往是"这个规格能不能用在某种工况""最小起订量多少""和另一种材料比差在哪"。你的产品页如果只堆参数表,没有把这些问答写成人能读的段落,AI 就很难从中提取出可引用的答案。这跟 llms.txt 无关,跟内容写法有关。
这两件事做完,再回头看 llms.txt,你会更清楚自己站上到底有没有值得整理进那份目录的内容。有,就顺手做;没有,那份目录本身也撑不起来。