


同一个大模型,仅因改变“看世界”和“记东西”的方式,测试成绩即可提升60分。
近日,MIT电气工程与计算机科学系副教授、Google DeepMind杰出科学家何恺明团队发表论文《VISTA:面向交互世界推理的视觉框架》。研究未训练新基础模型,而是在现有多模态模型外增加了一套视觉交互与记忆框架。
结果显示,接入VISTA后,模型在ARC-AGI-3的25个公开游戏中表现显著提升:Claude Opus 5得分从40.68分提升至100分,GPT-5.6 Sol从13.33分提升至99分,两者均顺利完成全部公开关卡。
(来源:Arxiv)
VISTA核心机制:重塑视觉交互与记忆
作为面向多模态Agent的视觉交互框架,VISTA主要解决两大关键问题:模型如何直接观察视觉环境,以及在长周期连续交互中如何保存并重新调用历史信息。
ARC-AGI-3是由ARC Prize基金会主导的AGI基准测试,旨在考察模型面对陌生任务时的适应和推理能力。与此前静态图形题不同,该测试将场景置于动态交互环境中,参与者需在无说明情况下,通过试错和观察环境变化来理解规则并完成任务。这不仅考验通关能力,还衡量完成操作次数,侧重于测试接近“流体智能”的能力。
赋予模型直接“视觉感知”能力
VISTA的首要改进是让模型直接“看”画面。ARC-AGI-3游戏本质是64×64的彩色网格。传统方法将其转换为4096个数字文本,虽信息无损但破坏了空间结构。VISTA则直接将PNG图像输入多模态模型,使其在视觉空间中判断物体位置与关系。
消融实验显示,仅将输入从数字文本改为图像,GPT-5.6 Sol得分即从13.33分升至47.32分。此外,图像输入更节省上下文:同等画面,文本需约4000 Token,而图像仅需约300 Token,有效释放了模型的推理预算。
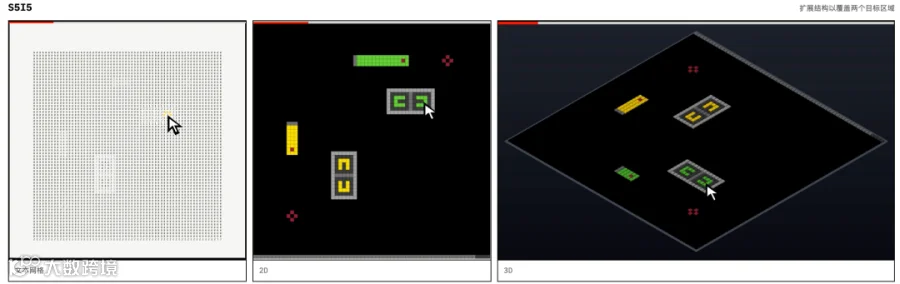
图|同一个ARC-AGI-3游戏可用数字文本、二维图像或三维场景呈现。底层规则相同,但信息结构不同。(来源:VISTA项目主页)
构建无损视觉记忆与主动回看机制
针对长周期交互中的遗忘问题,VISTA引入了无损视觉记忆(Lossless visual memory)。系统按时间顺序完整保存每一帧画面及中间动画帧。模型无需将所有历史数据塞入上下文,而是通过“inspect”工具主动调取历史画面,支持多图对比、局部放大,甚至通过“read_pixels”读取具体像素信息。
这种“显式注意力”机制允许模型明确决定回看时机、帧数及区域。例如,当操作导致画面变化但规律不明时,模型可调出前后帧并排比较,依据视觉证据修正判断。配合GUIDE.md(记录确定规则)和WORKING.md(记录假设与计划)两份笔记,模型可在上下文耗尽时保存关键进展,实现持续推理。

图|VISTA的Agent工作循环。(来源:VISTA项目主页)
实验表明,“主动回看”是性能跃升的关键。加入直接视觉输入和笔记后,GPT-5.6 Sol得分为70分左右;引入无损视觉记忆和主动回看后,得分升至94分以上;最终结合精确像素读取达到99分。
从静态视觉到动态交互的演进
VISTA是何恺明团队第三次从视觉角度重构ARC解题思路。
2025年11月,团队发表《ARC Is a Vision Problem!》,提出VARC模型,将ARC视为纯“图像到图像”转换问题,使用小型Vision Transformer从零训练,在ARC-1基准上取得60.4%准确率,追平大型语言模型方案。

图|何恺明团队此前提出的VARC模型。(来源:VARC论文)
随后,团队在《Natural Image Pretraining Improves Abstract Reasoning》中发现,自然图像预训练形成的视觉先验(如物体、边缘、空间结构)能显著提升抽象推理能力。Nat-ARC单模型在ARC-1得分升至63.4%,组合模型达70.2%。
VISTA进一步将问题延伸至动态交互世界。在此过程中,视觉不仅是输入格式,更成为闭环推理的核心部分。该框架在三维渲染场景、GameWorld、AI GameStore及BabyVision等基准测试中,表现均优于默认接口版本。在BabyVision测试中,仅赋予模型主动放大细节能力,准确率便从41.0%提升至63.2%。
满分背后的启示:系统能力重于模型参数
尽管VISTA在ARC-AGI-3公开集取得满分,但仍需注意其局限性。首先,满分仅针对25个公开游戏,泛化能力需待私有测试集验证;其次,无法完全排除相关题目进入训练数据的可能。
此前已有基于程序合成和世界模型的方案在公开集取得高分,但VISTA的不同之处在于,它未为每个游戏编写模拟器,而是让通用多模态模型直接观察和理解环境。
VISTA的价值不仅在于成绩单,更揭示了Agent时代的关键趋势:测试反映的不仅是模型本身的能力,更是整套系统的能力。感知接口、记忆机制、工具调用和上下文管理共同决定了最终表现。
在真实世界应用中,环境不会主动整理信息。智能体必须具备持续观察、记住关键状态并在需要时调取历史信息的能力。VISTA提供了一条不同于单纯扩大模型规模的路径:在基础模型能力增强的背景下,优化模型“看见、记住并理解”外部世界的方式,将成为下一阶段Agent能力提升的重要方向。
参考链接:
1. https://arxiv.org/abs/2610.02200
2. https://vista-research.github.io/
3. https://arcprize.org/blog/arc-agi-3-launch
4. https://arcprize.org/arc-agi/3
5. https://arcprize.org/competitions/2026/arc-agi-3
6. https://arcprize.org/leaderboard/community
7. https://arcprize.org/leaderboard
8. https://arxiv.org/abs/2511.14761