上一章我们讲到,GDDR 是专门为 GPU 高带宽需求发展出来的显存。GPU 周围可以放置多颗 GDDR,通过提高每个引脚的数据速率,再把多颗显存并行连接起来,形成 256-bit、384-bit 甚至更宽的显存接口。
如果 GPU 的计算能力继续提高,想获得更高的显存带宽,就需要继续提高 GDDR 的数据速率,或者增加显存颗粒数量和总接口宽度。前者会带来高速信号、功耗等问题,后者则意味着更多 PCB 空间、更复杂的高速走线以及更高的系统设计难度。
于是,Memory 开始换一个方向思考:如果横向放更多颗 DRAM 越来越困难,能不能把 DRAM 纵向堆起来?
HBM到底是什么?
HBM 的全称是High Bandwidth Memory,中文通常称为高带宽存储器。从最简单的角度理解,HBM 仍然是 DRAM。它并没有改变 DRAM 保存数据的基本原理,真正改变的是DRAM 的组织方式、连接方式和封装方式。
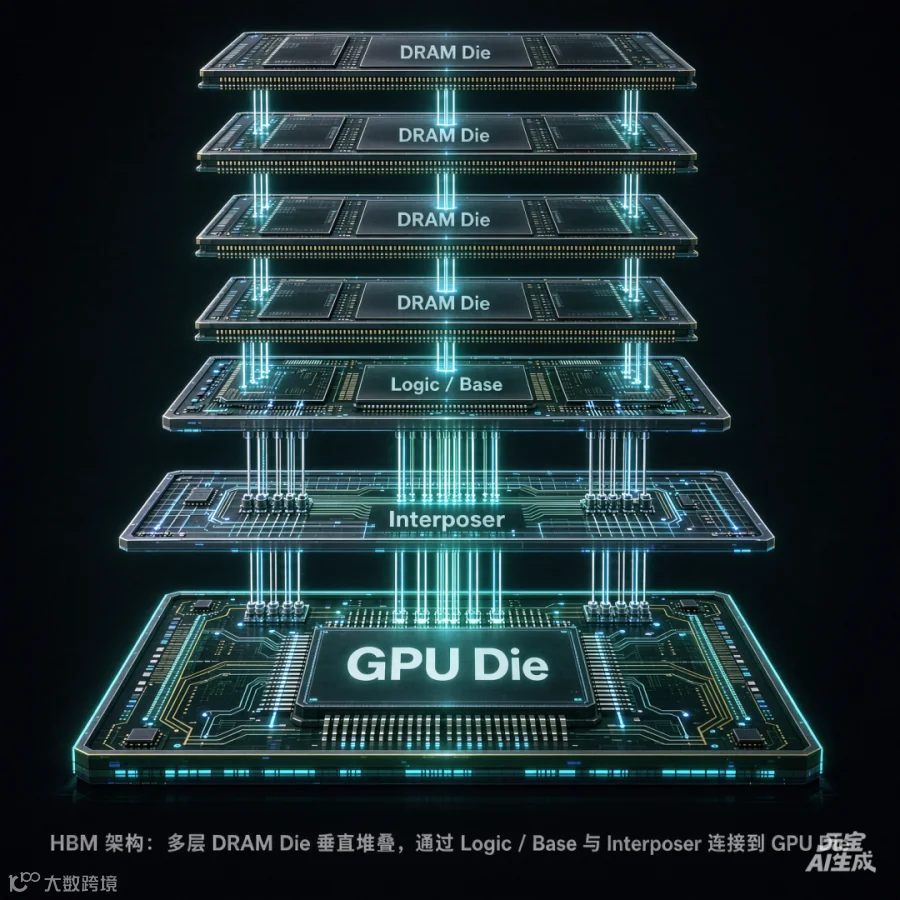
普通 GDDR 更像是把很多颗 DRAM 平铺在 GPU 周围: 而 HBM 则是把多层 DRAM Die 垂直堆叠起来,再让 GPU 与 HBM 通过非常宽的接口进行连接:
这里最重要的不是“堆”这个动作本身,而是:堆叠以后,可以在非常短的距离内提供非常宽的数据接口。这正是 HBM 和 GDDR 最核心的区别之一。
为什么把DRAM堆起来,带宽就会提高?
内存带宽 ≈ 数据传输速率 × 总数据位宽 ÷ 8
提高带宽有两个基本方向:一个是提高每个引脚的数据传输速度;另一个是增加总数据位宽,让更多数据同时传输。GDDR 主要是沿着这两个方向不断发展。它把多颗显存放在 GPU 周围,通过高速 I/O 和较宽的总接口获得很高的带宽。
HBM 则更加依赖第二种方式。它不一定要把每一个 I/O 都做到极高的传输速度,而是通过非常宽的接口同时传输大量数据。
例如,一组 HBM Stack 的接口宽度通常可以达到数千 bit 级别。这里的“宽”与我们前面看到的 GPU 256-bit、384-bit 显存接口是同一个概念,只不过 HBM 的并行数据通道宽得多。
HBM = 比 GDDR 更快的 DRAM。
HBM通过大量并行数据通道和非常短的互连,把总带宽做得非常高。
这也是为什么 HBM 的每个 I/O 不一定需要像高速 GDDR 那样追求极高的单引脚速率。
DRAM是怎么一层层连接起来的?
既然 HBM 是把 DRAM 一层层堆起来,那么问题来了:上面的 DRAM 和下面的 DRAM 是怎么连接的?
这就要认识一个非常重要的技术:TSV。TSV 的全称是Through-Silicon Via,通常翻译为硅通孔。
普通芯片主要通过芯片边缘的 I/O 与外部连接,而 TSV 可以简单理解成在硅 Die 内部形成垂直方向的导电通路,让信号能够从一层 Die 穿过硅片,连接到下面的一层。因此,多层 DRAM 就可以形成类似这样的结构:
这里需要注意,TSV 并不是“把整个 DRAM 的数据全部从一层直接传到下一层。更准确地说,TSV 为堆叠 Die 之间以及内部相关连接提供了大量垂直互连通道,使这些 DRAM Die 可以形成一个高度集成的 Memory Stack。
因此,HBM 真正改变的并不是 DRAM 的存储单元,而是:原来横向排列的多个 DRAM,现在可以在垂直方向进行高密度连接。
HBM和GPU又是怎么连接的?
这一点尤其重要。如果只是把几层 DRAM 堆起来,还不能自动变成 HBM。HBM 真正的优势还来自它与 GPU 之间的连接方式。
GDDR 的典型方式是:GDDR ─────── GPU ─────── GDDR PCB高速走线 GPU 周围放很多 GDDR 颗粒,每颗显存通过 PCB 走线连接到 GPU。
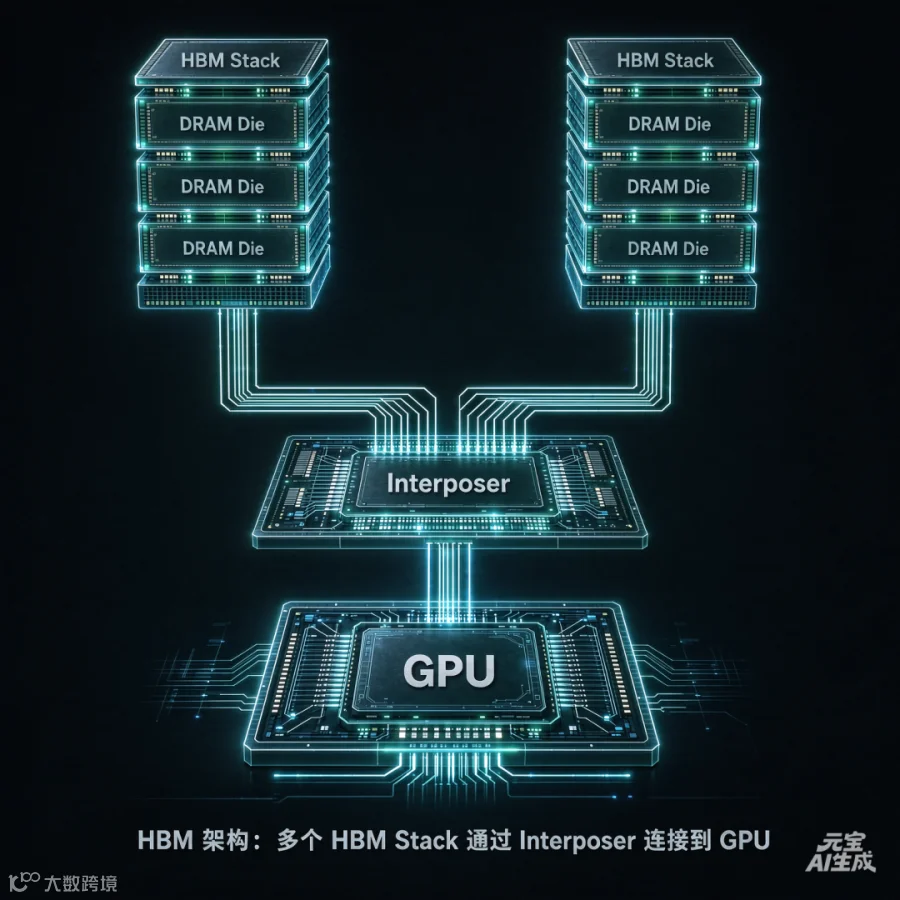
HBM 则不同。GPU 和 HBM 通常被放在同一个先进封装体系中,通过 Interposer(中介层)等高密度互连结构连接,而不是让超宽的数据接口全部走传统显卡 PCB。可以简单理解成:
Interposer 可以提供非常密集的横向连接,让 GPU 与 HBM 之间形成大量并行的高速连接。因此,HBM的“高带宽”实际上来自几个因素共同作用:DRAM堆叠 + TSV垂直互连 + 超宽接口 + GPU近距离连接 + 先进封装。少了其中任何一个环节,都不能简单等同于完整意义上的 HBM。
HBM到底是怎么工作的?
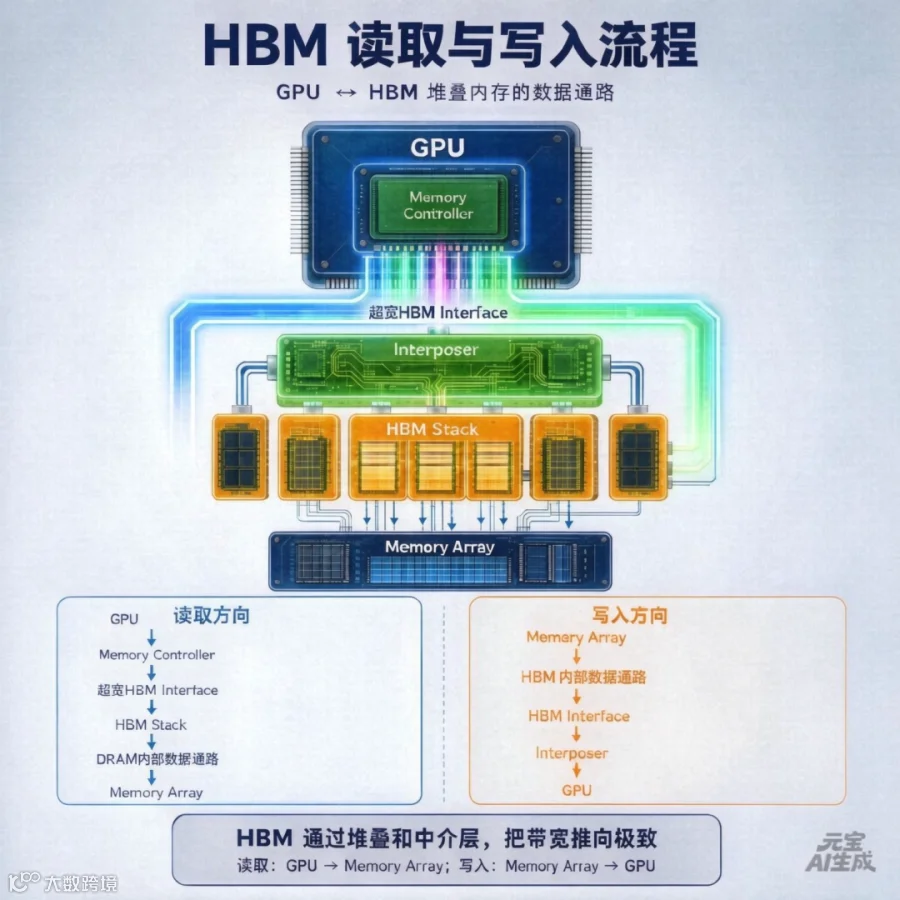
理解了连接方式,再回到最基本的数据流,就比较容易了。当 GPU 需要读取数据时,首先还是由 GPU 内部的 Memory Controller 发出访问请求。这个过程与普通 DRAM 并没有发生根本变化。不同的是,HBM 的 Memory Controller 面对的是一个非常宽的 Memory Interface。
数据经过 GPU 与 HBM 之间的高密度连接进入 HBM Stack,然后由 HBM 内部的接口和数据通路把数据分配到对应的 DRAM Die、Bank 和存储位置。
所以 HBM 并不是“GPU 直接读取某一层 DRAM”。它依然有完整的 Memory Controller、命令、地址、数据通路和 DRAM 内部结构,只是这些部分被组织成了一个更加高密度的 Memory Stack。
为什么AI特别需要HBM?
如果只是普通图形处理,GDDR 已经可以提供很高的带宽,但 AI 加速器又把这个问题进一步放大了。训练大型 AI 模型时,需要处理大量参数、激活值和中间计算结果。GPU 或 AI Accelerator 内部有大量计算单元,它们可以同时进行非常多的矩阵和向量计算。
问题再次出现:计算单元越多,需要同时提供的数据就越多。
如果计算核心非常强,但 Memory 不能持续提供足够的数据,部分计算资源就可能处于等待状态。这也是为什么 AI GPU 的规格中,经常同时强调计算能力和 HBM 容量、HBM 带宽。
这里需要特别区分两个概念:容量 ≠ 带宽。例如一颗 Memory 有很大的容量,只说明它可以保存更多数据;并不意味着它能够在单位时间内快速把这些数据送给 GPU。反过来,HBM 的重要优势之一是非常高的带宽,但它也不是为了单纯替代所有系统内存。
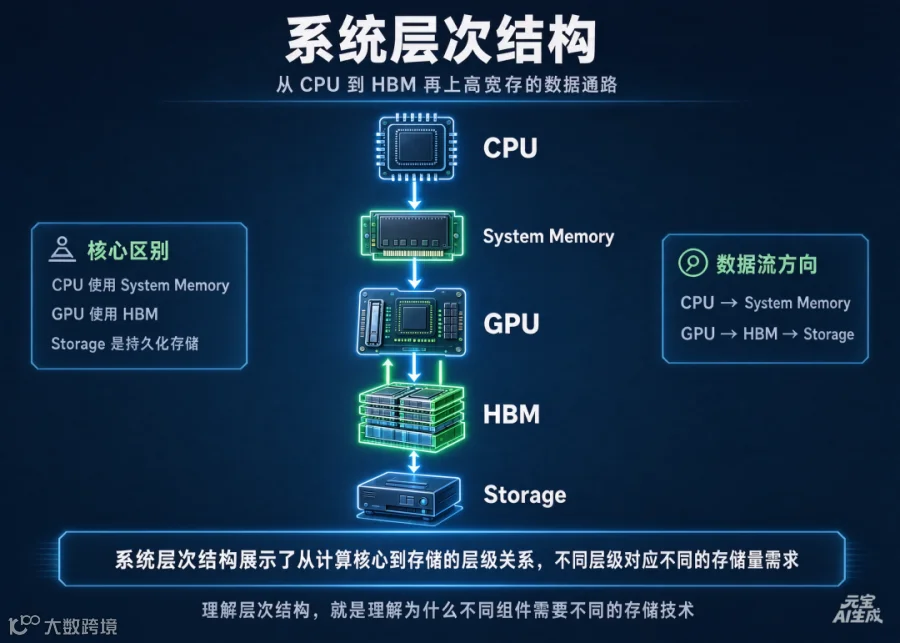
不同层次承担不同任务。HBM 更接近 GPU 的高速本地 Memory,用来为 GPU 的大量并行计算提供高速数据;系统内存承担更大的通用内存空间;SSD 等存储设备则负责长期保存数据。
因此,HBM并不是“容量最大的内存”,它解决的是另外一个非常重要的问题:如何让大量计算单元持续获得足够快的数据供应。
HBM为什么没有完全取代GDDR?
如果 HBM 的带宽这么高,为什么所有 GPU 都不用 HBM?原因在于 HBM 的代价也更高。
GDDR 可以通过传统 PCB 把多颗显存放在 GPU 周围,虽然高速设计很复杂,但整个系统仍然比较成熟。
HBM 则需要 DRAM Die 堆叠、TSV、先进封装以及 GPU 与 HBM 的高密度互连。这会增加封装复杂度、制造成本和设计难度,同时还涉及良率、散热和容量配置等问题。
所以,GDDR 和 HBM 并不是简单的“旧技术”和“新技术”。它们更像是两条不同的技术路线:
GDDR:提高单颗 I/O 速度,再通过多颗显存并行获得高带宽。
HBM:通过 DRAM 堆叠、超宽接口和先进封装,在更短的连接距离内获得极高的总带宽。
对于需要极高内存带宽的 GPU 和 AI 加速器,HBM 的这种架构非常有价值;而在其他对成本、容量、封装方式和系统设计有不同要求的场景中,GDDR 仍然有自己的应用空间。
从DDR到HBM,Memory到底发生了什么?
把前面几篇放在一起看,会发现 DDR、LPDDR、GDDR 和 HBM 并不是简单的一条“速度越来越快”的升级路线。
DDR 解决的是通用计算系统的内存问题;LPDDR 针对移动设备,在功耗、尺寸和带宽之间进行优化;GDDR 针对 GPU 的高带宽需求,通过高速 I/O 和多颗并行显存提供大量数据;HBM 则进一步改变了 DRAM 的空间组织和封装方式,把原本平铺在 PCB 上的 Memory,变成了垂直堆叠、超宽连接的 Memory Stack。
因此,Memory 的发展并不只是不断提高一个数字,而是在不断回答同一个问题:
当计算能力越来越强,需要的数据越来越多,我们应该怎样把数据更快、更近、更高效地送到计算单元?
从 DDR 到 GDDR,再到 HBM,改变的其实就是这个问题的答案。
18|DRAM到底是怎么制造出来的?——从晶圆到一颗内存芯片



 检芯外贸手札