


导读很多开发者以为只要把 Temperature 设为 0 或者固定随机种子,大模型就能输出完全确定的结果。然而在真实并发场景下,连续批处理(Continuous Batching)会导致同一请求的生成结果发生偏移。这并非上下文污染,而是因为浮点加法不满足结合律,底层硬件级并行优化在不同批次下改变了累加拓扑。本文系统拆解 GEMM、RMSNorm、Attention 和 AllReduce 四大核心算子的非确定性来源,并给出 vLLM 等现代推理引擎的系统级解决路径。
本文 3255 字,阅读约 8 分钟|一个反直觉的现象 → 数学根因 → GEMM 算子 → RMSNorm 算子 → Attention 与通信 → 工程权衡
一个反直觉的现象:锁死种子,并发依然“飘忽”
在日常开发与算法实验中,只要提到“让大模型输出完全确定的结果”,大多数工程师的第一反应通常非常直接:
1.
如果不需要模型发散,把 temperature 直接设为 0,关掉随机采样走贪心解码(Greedy Decoding);
2. 如果业务逻辑需要保留采样多样性,那就把随机数种子(Seed)严格固定。
按常理推断,在完全相同的硬件环境和模型权重下,只要输入相同的提示词,模型给出的 Token 序列理应完全一致。
但这只在单请求独占测试(Run-to-run 确定性)时成立。当你把模型部署到生产环境或评测集群,在开启连续批处理(Continuous Batching / 动态组批)的多并发场景下,一个令人困惑的现象就会出现:同一个 Prompt、完全相同的生成参数,在没有其他请求并发时输出完全固定;但在有其他并发请求混入同一个 Batch 时,输出结果却变了。
很多人的第一直觉是:难道不同请求之间发生了注意力上下文污染?
在主流推理引擎(如 vLLM、SGLang、TensorRT-LLM)中,各个请求的注意力掩码(Attention Mask)与 KV Cache 是严格物理隔离的,数学上根本不存在跨请求的信息泄露。
这种“单请求确定、动态批次下不确定”的系统现象,在 AI Infra 领域被称为 批次不变性(Batch Invariance)的破坏。
对于普通的多轮对话场景,个别用词的微小变化或许无伤大雅;但在大模型强化学习(RL / PPO / GRPO / RLVR)的 Rollout 阶段、自动化基准评测、科学复现以及合规审计中,不可复现的生成轨迹会让策略梯度产生异常噪声,甚至让实验结论彻底失真。
导致这一现象的真正根因,不在于算法逻辑,而在于底层推理系统为了掩盖 GPU 访存延迟所触发的非确定性硬件级并行优化。
数学根因:浮点加法不满足结合律
要理解批次不变性为何会被破坏,首先要回到计算机底层的数值表示。
在数学代数中,实数加法天然满足结合律:(a + b) + c = a + (b + c)。但在遵循 IEEE 754 标准的现代计算机浮点运算中,浮点加法并不满足结合律。
浮点数的本质是动态科学计数法。为了在有限的 16 位(FP16/BF16)或 32 位(FP32)中兼顾数值动态范围与绝对精度,浮点数的绝对精度(即最小可分辨步长 ULP)随着数值的增大而逐步下降:
ULP(x) = 2^(E − M)
其中 E 是浮点数的真实指数,M 是尾数位数。
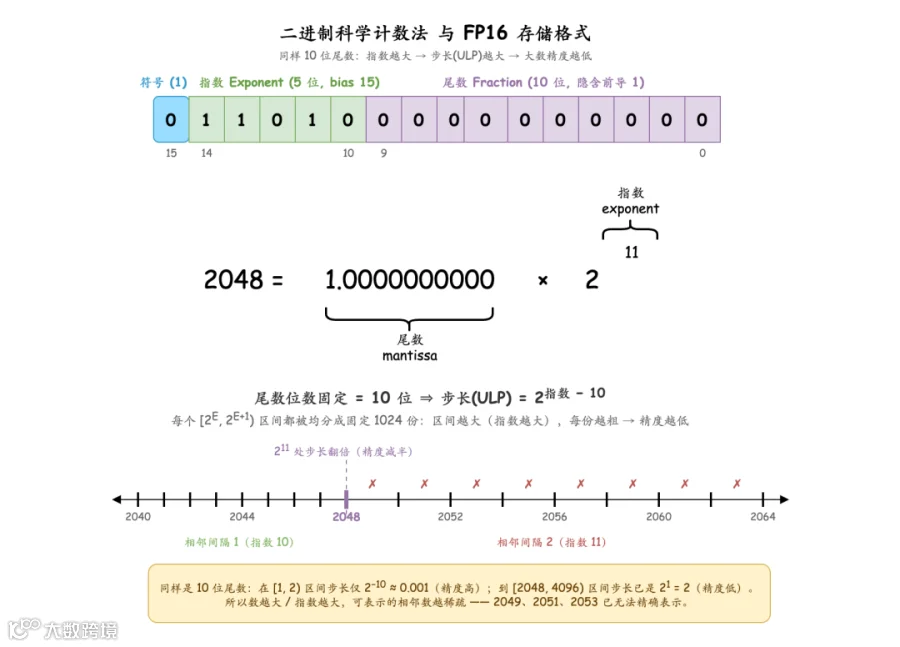 图片说明:IEEE 754 浮点数表示与 ULP 步长随指数增大的精度退化原理 图片来源:腾讯技术工程
以 FP16 为例(1 位符号位、5 位指数位、10 位尾数位):
• 当数值达到 2048(2¹¹)时,ULP 增大到了 2。这意味着 FP16 在 2048 之后的下一个可表示数值直接跳到了 2050,在物理尾数上根本无法精确存储 2049。
• 如果底层硬件执行 2048 + 1,运算器内部借助扩展位得出 2049,但写回 10 位尾数时触发了“向偶数舍入”(Round to Nearest, ties to Even)规则,最终结果被强行舍入回 2048。
• 如果执行 (2048 + 1) + 1,两次加法每次都加 1,每次都被舍入回 2048,最终结果依然是 2048;
• 但如果改变计算顺序执行 2048 + (1 + 1),括号内先算出 2,随后 2048 + 2 = 2050!
在大模型推理中,矩阵乘法通常采用 FP16/BF16 输入、FP32 累加。虽然 FP32 的精度显著高于 FP16,但数学本质完全一致:只要参与累加的成千上万个浮点数的归约顺序(Reduction Topology)发生改变,累加结果在低位有效数字上就会产生微小的数值扰动。
在大模型的自回归(Autoregressive)解码过程中,这种微小扰动会在特定时刻引发剧烈的“蝴蝶效应”:
当模型对下一个 Token 的预测概率非常接近时(例如候选 Token A 的 Logit 为 12.500001,候选 Token B 为 12.500000),极微小的累加顺序差异就会导致 Argmax 选中的 Token 发生翻转。由于自回归机制会将该 Token 拼入后续上下文,单步的翻转会迅速放大,导致后续整段生成轨迹彻底分叉。
那么,到底是什么在运行时动态改变了浮点数的累加顺序?答案隐藏在推理引擎调度的四大核心算子中。
GEMM 算子:Split-K 与动态调度如何打乱累加树
GEMM(通用矩阵乘法)占到了大模型推理计算量的绝大部分。在 Decode 阶段,输入矩阵的维度通常是 [Batch_Size, Hidden_Size] × [Hidden_Size, Intermediate_Size]。
在单请求或者小 Batch 场景下,M 维度(即当前调度的 Token 数量)非常小(例如 M=1)。如果直接按照常规的分块(Tiling)策略映射到 GPU 的流式多处理器(SM)上,GPU 庞大的并行计算单元根本无法被填满,算力利用率极低。
为了榨干硬件算力并掩盖显存访问延迟,现代 GEMM 算子(无论是 CUTLASS 还是 Triton 实现)普遍引入了 Split-K 优化:
1. Split-K 的工作机制:既然 M 维度太小无法切分,算子就把 K 维度(即 Hidden Size 方向)切分成多个分块(Splits),分配给不同的 Thread Block / CTA 并行计算;
2.
非确定性累加:各个 Block 计算出局部的矩阵乘积后,必须将结果累加回全局显存(Global Memory)。为了追求极致吞吐,通常采用 GPU 硬件级的 atomicAdd(原子加法)直接写入同一块显存。
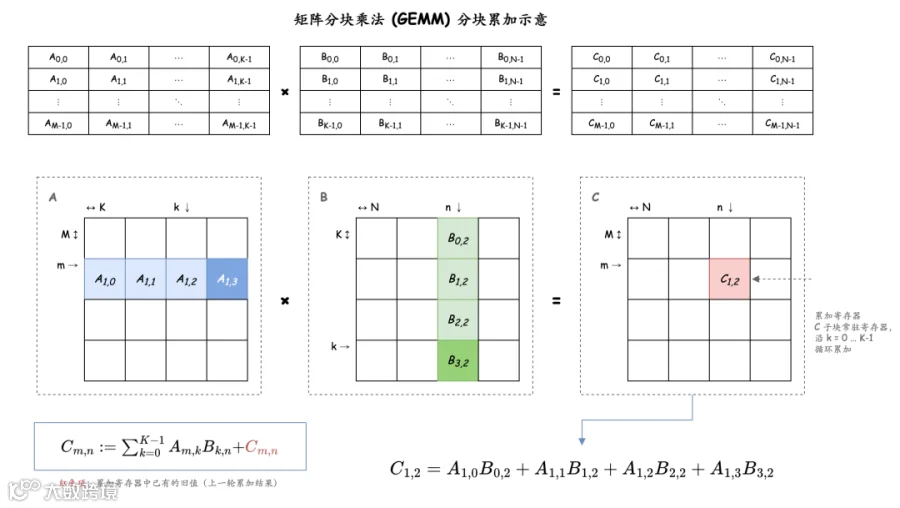 图片说明:GEMM Split-K 切分与多线程块 atomicAdd 并行原子累加机制 图片来源:腾讯技术工程
由于各 Thread Block 在 GPU 硬件上的调度时机、缓存命中率和内存总线争用存在细微的物理波动,atomicAdd 发生的时间先后完全是不确定的。
更关键的是:Split-K 的切分因子动态取决于当前的 Batch Size。当只有单个请求(M=1)时,系统可能将 K 维切成 8 份进行并行原子累加;而当并发请求增加(M=16 或 32)时,系统判断 M 维度已足够填满 SM,就会自动将 Split-K 因子降为 1(甚至完全关闭 Split-K),改走常规分块。
同一个请求在单独运行与组批运行时,其底层的 GEMM 累加树拓扑发生了根本改变,浮点累加结果自然不再相同。
针对这一问题,vLLM 等框架通过 VLLM_BATCH_INVARIANT 环境变量提供了专门的调度路径:在开启批次不变性模式时,锁定分块参数与分发逻辑(如调用固定的 linear_batch_invariant 算子),强制绕过动态的 Split-K 启发式调度。
RMSNorm 算子:编译优化中的隐藏切分因子
除了 GEMM,层归一化算子 RMSNorm(Root Mean Square Normalization)也是破坏批次不变性的高发地。
RMSNorm 的核心计算是对 Hidden 维度求均方根:
y = x / √(mean(x²) + ε) ⊙ W
在 PyTorch Eager 模式下,RMSNorm 通常由单个 Thread Block 内部完成整行的归约(Reduction),加法顺序相对固定。但在启用 torch.compile(TorchInductor 编译器后端)或使用 Triton 自定义算子时,编译器为了性能优化会动态选择 reduction_split_factor。
深入 PyTorch Inductor 的调度源码(torch/_inductor/choices.py),可以看到如下启发式切分逻辑:
这意味着:当并发批次较小(num_tokens 较少)时,单个 Token 的 Hidden 归约会被拆分到多个 SM 上并行求和后再做汇总;而当并发批次变大时,每个 SM 独立处理一个完整 Token,不再进行跨 SM 拆分。
这种根据当前 Batch 中 Token 总数动态调整归约策略的行为,再次导致了均方根分母在不同批次下的微小漂移。
社区在修复此类问题时(如 vLLM PR #48391),核心思路就是固化 Block Size 与归约策略,确保无论当前的动态 Batch 大小如何变化,归约的线程分工与加法树层级始终保持恒定。
Attention 与通信:FlashDecoding 与 Custom AllReduce 的确定性陷阱
除了基础算子,注意力机制与多卡分布式通信同样存在批次不变性陷阱。
1. FlashDecoding 的 Split-KV 归约
在长上下文与生成解码阶段,为了加速 Attention 计算,FlashDecoding 技术将 KV Cache 序列切分成多个 Split(即 split-kv),各个线程块分别计算局部的 Softmax 与注意力加权和,最后再通过一层 Reduction 将各个 Split 的结果合并。
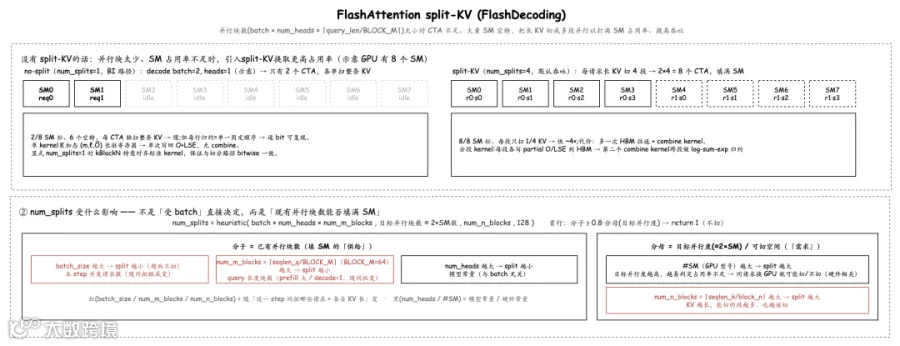 图片说明:FlashDecoding 沿 KV 序列维度切分与多 Split 归约合并流程 图片来源:腾讯技术工程
在默认情况下,FlashDecoding 的 max_num_splits 会随着当前 Batch 的大小与序列长度动态调整。多 Split 之间的 Log-Sum-Exp 合并与加权求和顺序一旦随 Batch 改变,就会引入浮点误差。
在 vLLM 的实现中,开启批次不变性模式时,Attention 后端会强制锁定分块数(如将 FlashAttention 的 max_num_splits 统一设为 1,或使用确定性的静态归约树),消除序列切分带来的动态性。
2. 多卡通信中的 Custom AllReduce
在大模型采用张量并行(Tensor Parallelism, TP)多卡部署时,每个 Linear 层与 Attention 层输出后都需要执行一次 AllReduce 跨卡累加。
为了降低小 Batch 下的通信延迟,vLLM 等引擎实现了 Custom AllReduce 算子。不同实现可能采用不同的跨卡归约算法与顺序。
如果归约算法或分块顺序随当前 Token 数量变化,同一请求的浮点累加顺序也可能改变。因此,批次不变性需要约束通信路径,而不只是固定单卡算子。
按 vLLM 当前的批次不变性文档,开启 VLLM_BATCH_INVARIANT=1 后,张量并行场景仍可保留 Custom AllReduce,但会固定归约顺序:使用固定的一阶段内核,大输入按固定大小分块;部分其他 AllReduce 路径会被禁用。官方也注明,张量并行下仍有张量字节数必须满足特定对齐要求的限制。
工程权衡:确定性不是免费的午餐
既然已经厘清了四大算子的非确定性根因,是不是所有大模型服务都应该默认开启批次不变性呢?
答案是:确定性在工程上是有性能代价的。
场景选型建议
在实际生产与研究工程中,应当根据业务目标合理做出权衡:
• 强化学习(RL / PPO / GRPO / RLVR)训练:必须开启。Rollout 数据的非确定性会导致策略梯度方差增大,严重影响训练收敛。
• 基准评测与打榜(Benchmark):必须开启。确保不同并发与组批条件下分数具备严格的可比性与可复现性。
• 模型回归测试与 Debug:必须开启。排查线上 Bad Case 时,必须保证在相同的输入下百分之百复现输出。
• 大规模高并发线上对话服务:建议保持默认。用户对单字微小浮动不敏感,首 Token 延迟与吞吐量是首要指标。
• 批量离线特征提取与数据生成:建议保持默认。无需精确复现单 Token 轨迹,追求每美元算力产出最大化。
大模型输出的不确定性,表面上看是概率采样的“玄学”,底层折射出的却是高并发计算与硬件微架构之间的精密博弈。从浮点结合律失效到 GPU 算子调度拓扑,理解了批次不变性的机制,我们才能在工程落地上真正实现“算力性能”与“科学严谨”的自如掌控。
参考资料
• AI Infra 进阶:如何让大模型输出确定的结果(腾讯技术工程): https://mp.weixin.qq.com/s/YRwGxVsO93M0-2bupN-bqQ
• IEEE Standard for Floating-Point Arithmetic (IEEE 754-2019): https://standards.ieee.org/ieee/754/6260/
• vLLM 官方仓库 Batch Invariance Issue 讨论: https://github.com/vllm-project/vllm/issues/40628
• vLLM Batch Invariance 官方文档: https://docs.vllm.ai/en/latest/features/batch_invariance/
• vLLM PR #48391 (Fix batch invariance in RMSNorm kernels by pinning block size): https://github.com/vllm-project/vllm/pull/48391
• vLLM PR #40413 (Perf Optimize batch invariant with fused rms norm): https://github.com/vllm-project/vllm/pull/40413
• PyTorch Inductor 编译调度 choices 源码: https://github.com/pytorch/pytorch/blob/main/torch/_inductor/choices.py
• FlashDecoding (Tri Dao et al.) 论文与实现: https://crfm.stanford.edu/2023/10/12/flashdecoding.html
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!