
大数跨境

复盘会上最难熬的一刻,是没人说得清当初为什么选B

复盘会上最难熬的一刻,是没人说得清当初为什么选B AI驱动数字化转型
2026-10-05
5
导读:一个决定被记住了,才会被改进。一个决定只是被通过了,它就只是一次表态。
季度复盘会上最难熬的一刻,常常不是某个方案失败。
是半年前那个决定,今天已经没人说得清当初凭什么做出来的。
老板在会上问了一句“当时为什么选B”,会议室安静了几秒。看的是哪张表,谁提过反对意见,为什么不是A,会议纪要里只留下一行“经讨论确定B方案”。在场的人换过两个,数据口径改过一轮,那行字就成了孤证。
企业里多数决定的命运都是这样。做的时候热热闹闹,做完就散,散在邮件、聊天记录和某位老同事的脑子里。
这件事有两种常见的解释。一种说信息不够,所以要上系统、上报表、上大模型。另一种说人不行,所以要请顾问、做培训、立规矩。
两种解释都绕开了真正的那道坎。决定做错的时候,多数企业并不缺信息,也不缺聪明人,缺的是这个决定做完之后还剩什么。

Gartner给决策智能下的定义里,专门留了一条“对决策进行记录以实施后续分析”。他们还预测,到2026年,全球500强里有75%的企业会采用决策智能实践,到2027年,50%的业务决策会由AI智能体增强或自动完成。

一家咨询机构把记录写进定义的第一层,这件事本身值得琢磨。他们用的词不是预测,不是建议,不是推荐。一份决定要能被记录,前提是它有可写的形状。
多数企业里的决定没有形状。它由四样东西撑着,而这四样通常散在四个地方。

PART 01
决定的四个组成部分


判据
判据是凭什么。做决定的人得说出自己看的是哪张表、哪条规则、谁的判断,是量出来的还是问出来的。

选项
选项这一样,说的是当时比过哪些。销售提上来两个方案,一个让价一个加量,最后批了让价,加量那份连同加量的理由一起丢了。复盘会上的争论大多发生在这一处,因为被记住的永远只有通过的那个。

约束
约束是卡在哪。做决定的人要交代清楚,预算够不够,合规过不过,产能跟不跟得上,时效允不允许,还有那些写在制度之外、只有老员工才知道的门槛。

回执
回执是结果回到谁手上。决定执行之后实际发生了什么,得有人把它拿回来对一遍。
这四样凑齐,一个决定才算有了可以被追问的形状。
缺哪一样,复盘就只能靠回忆。
拿给客户折扣这件事来说。销售把申请递上去,理由写得很短,“重要客户、竞争激烈”。审批人手上没有可比的东西,他只能凭印象点头。
如果这单决定被记录下来,它就有形状。判据是这家客户过去三年的毛利和退货率,选项是八折加账期和九折加预付款,约束是这条产品线的底价,回执是三个月后这笔订单的实际毛利。三个月后回头看,这笔让利值不值就变成一道可以算的题,而不是一次表态。
制造现场的例子更扎眼。设备报警,老师傅走过去听一下、摸一下,就能判断要不要停机检修,他凭的是手里攒了二十年的手感。这套手感从来没有被写下来过。他退休那天,它跟着走了。
新人接班只能照规程走,规程里恰好没有那一条。同一台设备第一次报警他不敢停,第二次报警他停了,两次判断都对不上老师傅的做法。
账没人算,教训就留不下来。
判据也不是天然可信的。市场部的人算出一版流失率,客服的人算出另一版,两个人把各自的表拍在桌上,谁都觉得自己那版才是准的,旁边的负责人摆摆手,说这个口径我们不认。口径分歧留在系统外面,决策系统只会把两版合成一个看起来很统一的答案。
危险恰恰在这里。
PART 02
不同环节的落地方案


找回判据:知识库工具
把判据找回来,是知识库这一类工具负责的一段。新来的同事要一份旧报价表,从前得在群里问一圈,现在他在搜索框里敲一句话,答案后面跟着出处。Glean走的就是这条路,把企业已有的文档、代码、聊天、工单抓出来做成索引。
代价也真实。竞品的评测文章点出过索引延迟、定价不透明、基础设施成本高这三条。这些说法来自利益相关方,不能全信,但它们指向同一件事,这类工具的难点不在问得多聪明,而在数据能不能及时、完整、合规地进来。

计算数值:ChatBI
把数算出来是另一段,工具叫ChatBI。过去业务的人想要一个数,得催着分析师排期,分析师手里排着十几张报表,回一句下周。现在他自己在框里敲一句话。
基准测试给出的画面没有厂商材料那么乐观。在BIRD这个偏真实场景的榜单上,GPT-4o的整体准确率是52.54%,简单问题56%,复杂问题掉到35%。Spider 2.0更接近企业现场的复杂查询,公开成绩的峰值是59.05%。至于厂商常写的“准确率从70%提升到95%以上”,那是厂商自己的口径,第三方没有复现过。
这一段其实有更老的办法。2015年OMG发布了决策模型和标注,简称DMN,它把决策逻辑从业务流程里剥出来单独建模,用决策需求图和决策表把“什么条件下取什么值”写成可以执行的表格。今天讲决策智能的人里,知道这个标准的不多,重新发明它的倒不少。

真正的难点:约束和回执
真正的分水岭在约束和回执。多数企业用审批流来兜,问题恰恰出在这里。

InfoQ有篇文章的标题切得很准,当human in the loop变成“闭着眼睛点确认”。

审批人一天要过几十条,他看到的是系统给的结论加一行风险提示,他点的是习惯,不是判断。签字成了免责动作,责任还留在系统外面。
比较务实的做法是按风险分档。定规则的人先把动作分成几档,系统能自己做的走自动,需要人核一眼的先出草稿,动钱和碰合规的进人工确认,不可逆的做强制确认,明确越界的直接禁止。高风险那一档自动停住,把推理过程和依据摆出来,让人看到为什么是这个结论再落笔。
把决定交给模型这件事,学术上的账单也在陆续到。有一篇叫DeLLMa的论文试过直接让大模型做不确定性下的决策,结论是效果不好,问题越复杂越差。ICML 2026上一篇position paper提得更靠前,要让智能体做出一致的决策,得在系统层面引入贝叶斯原理,不是把模型参数调好就行。医学领域的评测更直接,当前的大模型还不适合做自主临床决策。
这些结论不是要否定工具。它们在说清一件事,模型在决策链上的位置是算得快、记得全、不喊累,不是替人承担风险。
约束难,还有组织上的原因。拍板的人不承担后果,承担后果的人不拍板。业务要速度,IT要稳定,安全握着否决权,采购管着合同,集团和子公司各有各的优先序。没有人牵头跨线,任何单一团队都推不动一个跨部门的决定。
选型会上常见的情形也是这个道理。CIO带着两个部门看了三家演示,供应商讲得都漂亮,散会时大家一致认为第二家最合手。回去落地才发现,要用的数据一半在集团、一半在子公司,权限不在他手上,项目在等批复这一环停了三个月,当初最积极的那位业务负责人已经调岗。
回执难在另一头。活动做完了,市场部的人拿到报表,财务的人每季度把毛利表发出来,客服的人看着货,三份数据三个口径,没人拿它回去对当初那笔让利,谁也不觉得自己该去把账合上。
PART 03
落地顺序和判断标准

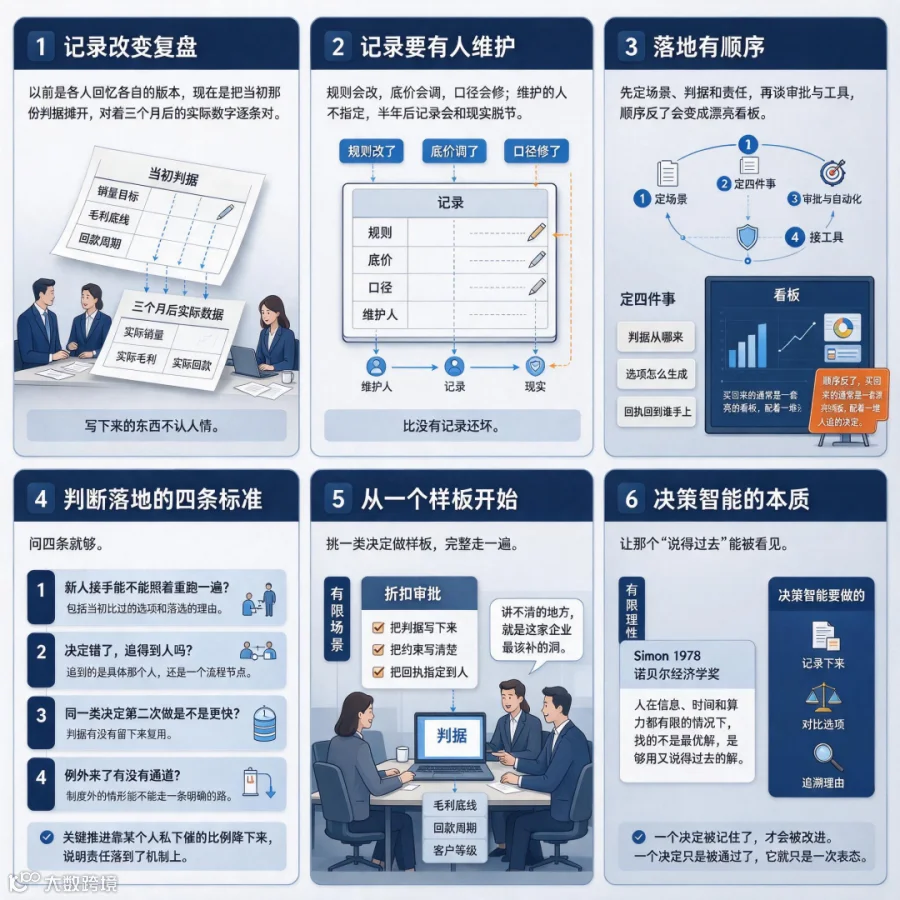
有了记录,复盘会的样子会变。以前是各人回忆各自的版本,现在是把当初那份判据摊开,对着三个月后的实际数字逐条对。
谁都不用替自己辩解。
写下来的东西不认人情。
还有一层容易被忽略,记录要有人维护。规则会改,底价会调,口径会修,维护的人不指定,半年后那份记录就和现实脱了节,比没有还坏。
所以落地这件事有顺序:
  • 先把做决定的人和被决定影响的人叫到一间屋里,把场景列清楚,哪些决定值得被记录,一年做几次,错了的代价有多大。值得记的就那么几个,不必全上,一天定几十次的常规事照旧走流程就好。
  • 为每一个场景找齐那四样东西,判据从哪来,选项怎么生成,约束由谁定,回执回到谁手上。判据这一样最费事,几个部门的人得先坐到一起,把口径谈成一件事。
  • 定完这些,再谈谁来批准、依据是什么、什么情况下系统可以自己往下走。选工具的人排在这之后,把知识库、问数、流程引擎、模型接到各自对应的环节上。
顺序反了,买回来的通常是一套漂亮的看板,配着一堆没人追的决定。
判断一套决策系统是不是真落地,问四条就够:
  • 新人接手的时候,能不能照着重跑一遍,包括当初比过的选项和落选的理由。
  • 决定错了呢,追得到人吗,追到的是具体那个人,还是一个流程节点。
  • 同一类决定第二次做是不是更快,判据有没有留下来复用。
  • 例外来了有没有通道,制度外的情形能不能走一条明确的路,而不是绕开系统私下解决。
这几条之外还有一条反向的指标更灵,关键推进有多少还在靠某个人私下催。这个比例降下来,说明责任真的落到了机制上,而不是落在某个人的人情上。
真要起步,挑一类决定做样板就够。比如折扣审批,或者设备检修,把判据写下来,把约束写清楚,把回执指定到人,完整走一遍。做的时候把当初做决定的人请回来,让他把判据讲一遍,讲不清的地方,就是这家企业最该补的洞。
Simon在1978年拿诺贝尔经济学奖,靠的就是对组织决策的研究。他提出的有限理性说的是一件朴素的事,人在信息、时间和算力都有限的情况下,找的不是最优解,是够用又说得过去的解。
决策智能要做的,是让那个“说得过去”能被看见。它不承诺企业每次都选对,它要求下一次有人问“当初为什么这么定”的时候,答案还在。
一个决定被记住了,才会被改进。
一个决定只是被通过了,它就只是一次表态。

【声明】内容源于网络
0
0
AI驱动数字化转型
专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
内容 1099
粉丝 1
AI驱动数字化转型 专注AI,促进智造行业数据衍生,服务智能制造企业的数字化、智能化,聚焦大模型私域部署、大模型微调、数据清洗、AI模型训练、私域知识库及agent技术延展等。行业智能,落地为先。
总阅读12.4k
粉丝1
内容1.1k