


摘要:本文以 Verilator 编译流水线为线索,说明模块端口连接如何被展开为显式线网赋值,并最终以何种形式出现在生成的 C++
eval()函数中。内容覆盖单向连线、互为输入输出的两种形态、不同逻辑类型下子模块eval()顺序的调度机制,以及 Verilator 自动处理的边界条件。
目录
-
1. 流水线总览 -
2. 单向连线的处理 -
3. 互为输入输出的两种形态 -
4. 子模块 eval 顺序的调度机制 -
5. Verilator 的自动处理边界 -
6. 小结
1. 流水线总览
Verilator 在编译期完成连线处理。连线逻辑被静态内联到 eval() 函数中,不单独成文件。

整个流水线中,连线相关信息的形态变化可以用下面的时序图表示。
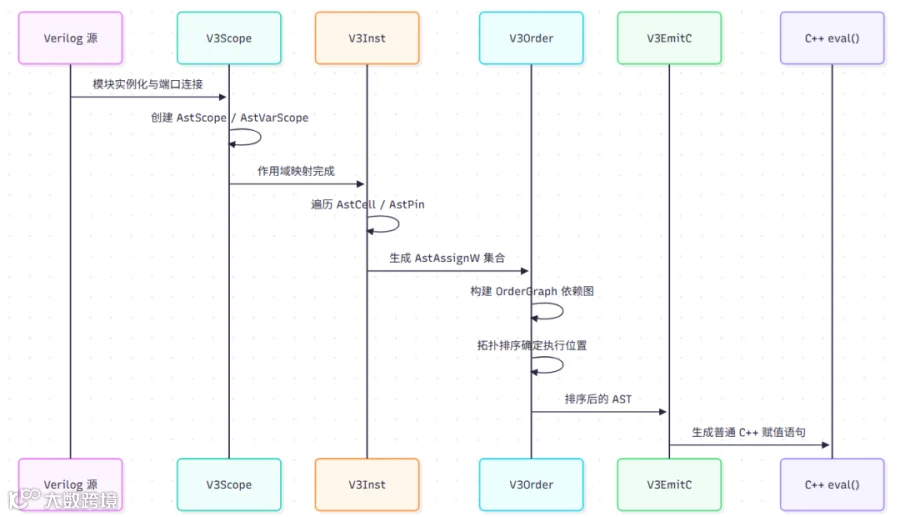
V3Inst 遍历 AstCell(模块实例化节点),对其中每个 AstPin(端口连接),根据端口方向生成对应的 AstAssignW。方向决定赋值方向:
生成的 AstAssignW 经 V3Order 排序后,由 V3EmitC 转换为 C++ 赋值语句。变量命名规则为层次路径中的 . 替换为 __DOT__,顶层信号无前缀。例如:
   // Vtop.cpp 中 eval() 的连线部分
u_prod__DOT__data_out = u_prod__DOT__seed + 8'd1;  // producer 内部逻辑
mid_data  = u_prod__DOT__data_out;                 // 来自 V3Inst 的连线赋值
mid_valid = u_prod__DOT__valid;
final_result = mid_data * 2;                       // consumer 逻辑
-
• 连线赋值是 eval()中的普通赋值语句,没有独立的函数或宏。 -
• V3Descope在V3EmitC之前运行,将AstVarScope引用简化为直接AstVar引用。 -
• 若子模块被 V3Inline内联,连线语句会被优化为变量别名,在生成的代码中消失。 -
• 组合环被 UNOPTFLAT标记后,eval()内部自动迭代至稳定;不收敛时工具报错退出。
2. 单向连线的处理
最基础的场景是单向数据流:一个模块产生输出,另一个模块接收输入。以下例中,producer 输出 data_out、valid,consumer 接收 data_in、valid_in。
2.1 Verilog 侧
producer.v
   module producer (
    input  logic       clk,
    input  logic [7:0] seed,
    output logic [7:0] data_out,
    output logic       valid
);
    always_ff @(posedge clk) begin
        data_out <= seed + 8'd1;
        valid    <= 1'b1;
    end
endmodule
consumer.v
   module consumer (
    input  logic       clk,
    input  logic [7:0] data_in,
    input  logic       valid_in,
    output logic [7:0] result,
    output logic       done
);
    always_ff @(posedge clk) begin
        if (valid_in) begin
            result <= data_in * 2;
            done   <= 1'b1;
        end
    end
endmodule
top.v
   module top (
    input  logic       clk,
    input  logic [7:0] seed,
    output logic [7:0] final_result
);
    logic [7:0] mid_data;
    logic       mid_valid;

    producer u_prod (
        .clk      (clk),
        .seed     (seed),
        .data_out (mid_data),
        .valid    (mid_valid)
    );

    consumer u_cons (
        .clk      (clk),
        .data_in  (mid_data),
        .valid_in (mid_valid),
        .result   (final_result),
        .done     ()
    );
endmodule
-
• 两个模块在 Verilog 层完成连线,Verilator 可见完整连接关系。 -
• producer的输出为寄存输出,稳定保持一个完整时钟周期。 -
• consumer在valid_in有效时对data_in进行运算,符合典型握手接口约定。 -
• mid_data、mid_valid为顶层中间信号,在Vtop__Syms中拥有独立存储。
2.2 生成结果
V3Inst 将 top.v 中的端口连接展开为如下 AstAssignW(语义示意):
   // 输出端口:子模块 → 父模块
top.mid_data     = u_prod.data_out;
top.mid_valid    = u_prod.valid;

// 输入端口:父模块 → 子模块
u_cons.clk       = top.clk;
u_cons.data_in   = top.mid_data;
u_cons.valid_in  = top.mid_valid;
经 V3Order 排序后,V3EmitC 生成的 Vtop.cpp 中 eval() 函数体大致如下:
   void Vtransform: translateY(:eval_step() {
    // ---- producer 时序逻辑 ----
    if (clk && !__prev_clk) {
        u_prod__DOT__data_out = u_prod__DOT__seed + 8'd1;
        u_prod__DOT__valid    = 1'b1;
    }

    // ---- 来自 V3Inst 的连线赋值 ----
    mid_data  = u_prod__DOT__data_out;
    mid_valid = u_prod__DOT__valid;

    // ---- consumer 时序逻辑 ----
    if (clk && !__prev_clk) {
        if (mid_valid) {
            final_result = mid_data * 2;
        }
    }
}
-
• 连线赋值是 eval()中的普通 C++ 赋值语句。 -
• u_prod__DOT__data_out是 producer 内部寄存器的 C++ 变量名。 -
• mid_data是顶层信号,在Vtop__Syms中拥有独立存储。 -
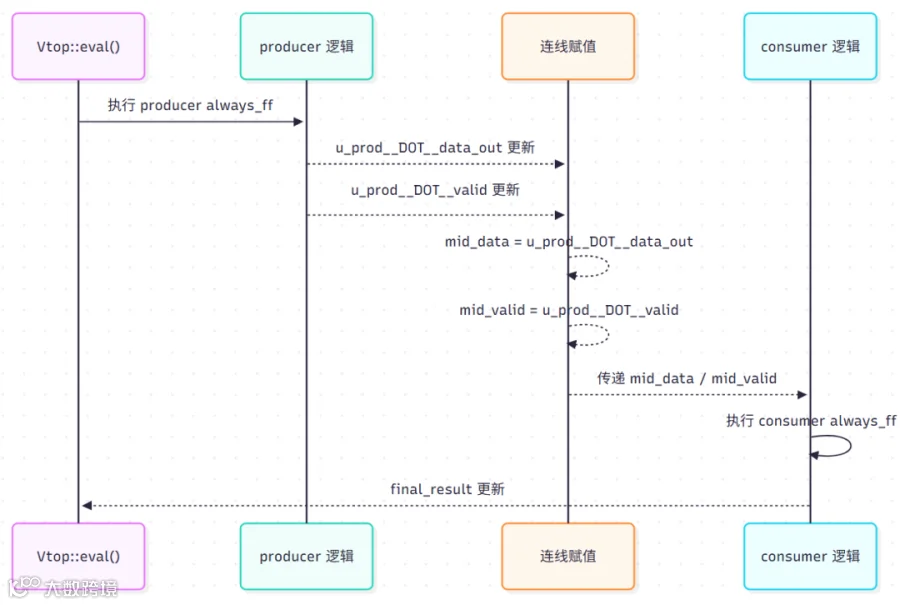
• 排序由 V3Order的依赖图决定,顺序为 producer → 连线 → consumer。
eval() 内部的执行时序可用下面的图表示。
2.3 用户侧调用
   Vtop* top = new Vtop;
top->clk  = 0;
top->seed = 8'd10;

for (int i = 0; i < 5; i++) {
    top->clk = 1;
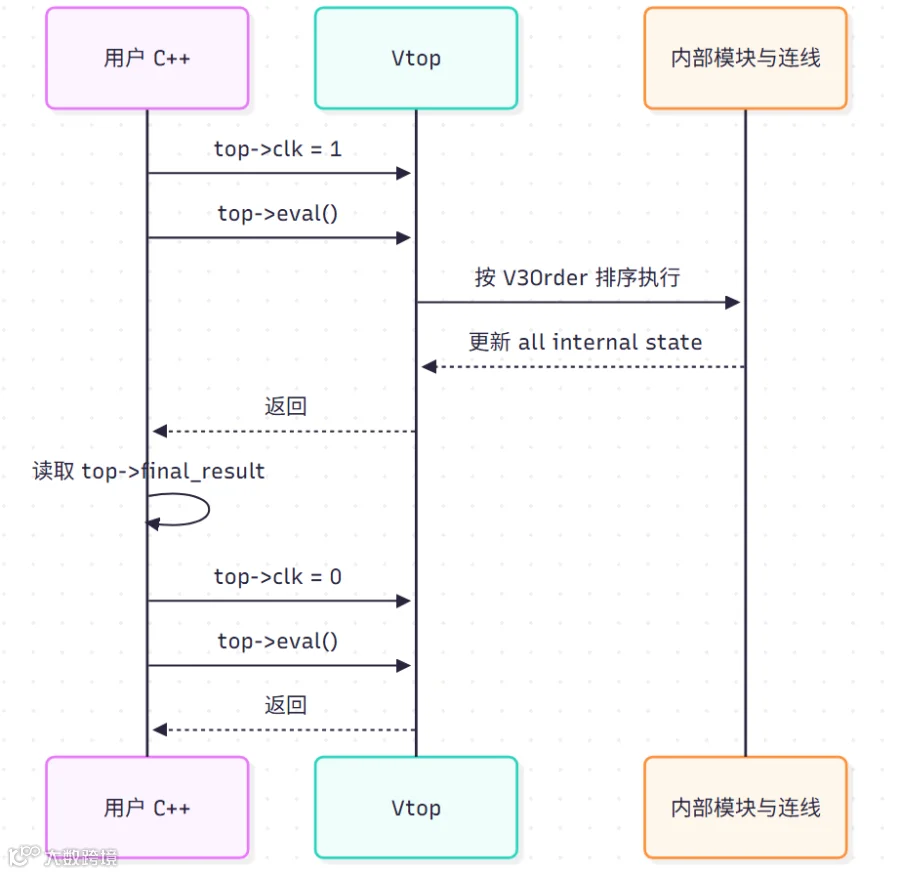
    top->eval();   // 单次 eval 完成所有内部模块求值和连线传递
    top->clk = 0;
    top->eval();
}
从用户视角看,一个时钟周期内的调用时序如下。
-
• C++ 侧只看到顶层模型,内部模块的连线、求值顺序全部被封装。 -
• 所有连线逻辑在编译期已经确定并固化到 eval()中。 -
• 内部连线对使用者不可见,无法在运行期动态改变。
2.4 总线与多信号
若端口为总线或包含多个信号,V3Inst 会为每一条连接分别生成 AstAssignW:
   // 整条总线一次赋值(生成单条 AstAssignW)
cons__DOT__data_in = mid_data;

// 多信号逐条赋值(生成多条 AstAssignW)
cons__DOT__valid_in = mid_valid;
cons__DOT__last_in  = mid_last;
cons__DOT__keep_in  = mid_keep;
-
• 总线类型生成一条赋值语句,Verilator 以对应的整数类型承载。 -
• 多个离散信号生成多条赋值语句,无自动打包机制。 -
• 信号数量较多时, V3Order的依赖图规模随之增长,但排序仍自动完成。
3. 互为输入输出的两种形态
当两个模块互为输入输出时,其行为取决于反馈路径上是否存在寄存器。
3.1 时序反馈环
反馈路径经过寄存器时,两个模块在同一时钟沿同时采样对方的旧值,不构成代数环。
mod_a.v
   module mod_a (
    input  logic       clk,
    input  logic [7:0] from_b,
    output logic [7:0] to_b,
    output logic [7:0] state_a
);
    logic [7:0] reg_a;
    always_ff @(posedge clk) reg_a <= from_b + 8'd1;
    assign to_b    = reg_a;
    assign state_a = reg_a;
endmodule
mod_b.v
   module mod_b (
    input  logic       clk,
    input  logic [7:0] from_a,
    output logic [7:0] to_a,
    output logic [7:0] state_b
);
    logic [7:0] reg_b;
    always_ff @(posedge clk) reg_b <= from_a + 8'd2;
    assign to_a    = reg_b;
    assign state_b = reg_b;
endmodule
top.v
   module top (
    input  logic       clk,
    output logic [7:0] a_state,
    output logic [7:0] b_state
);
    logic [7:0] a_to_b, b_to_a;

    mod_a u_a (
        .clk     (clk),
        .from_b  (b_to_a),
        .to_b    (a_to_b),
        .state_a (a_state)
    );

    mod_b u_b (
        .clk     (clk),
        .from_a  (a_to_b),
        .to_a    (b_to_a),
        .state_b (b_state)
    );
endmodule
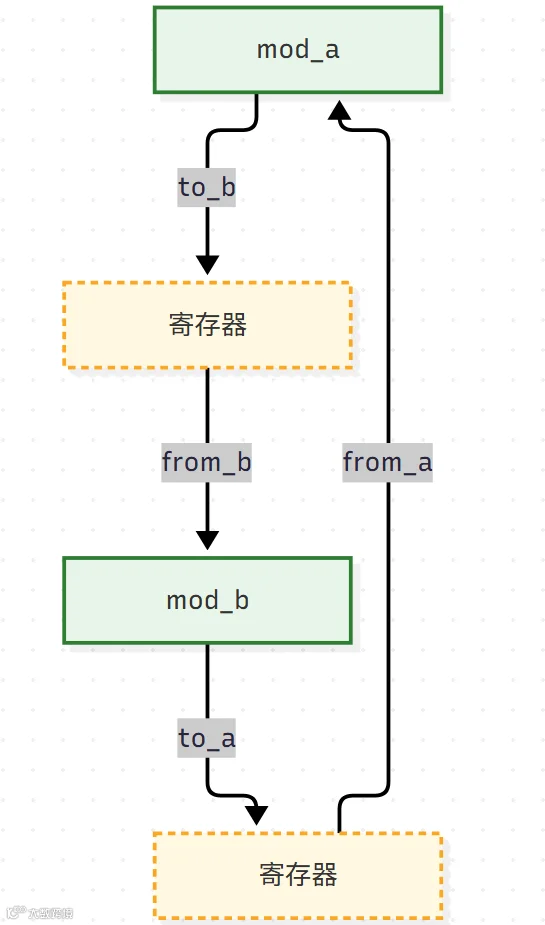
V3Inst 会生成双向的 AstAssignW:
   // 来自 V3Inst 的连线(语义示意)
u_a.from_b = b_to_a;   // B → A
u_b.from_a = a_to_b;   // A → B
由于两个模块的反馈路径均经过寄存器,V3Order 会将它们安排在同一时钟沿采样,eval() 顺序无关。生成的 eval() 中,两条连线赋值被分别安排到各自模块的时序逻辑之前:
   void Vtransform: translateY(:eval_step() {
    // ---- 上升沿前,将上一拍输出接至输入 ----
    u_a__DOT__from_b = b_to_a;
    u_b__DOT__from_a = a_to_b;

    // ---- mod_a 时序逻辑 ----
    if (clk && !__prev_clk) {
        u_a__DOT__reg_a = u_a__DOT__from_b + 8'd1;
    }

    // ---- mod_b 时序逻辑 ----
    if (clk && !__prev_clk) {
        u_b__DOT__reg_b = u_b__DOT__from_a + 8'd2;
    }

    // ---- 输出端口赋值 ----
    a_to_b = u_a__DOT__reg_a;
    b_to_a = u_b__DOT__reg_b;
    a_state = u_a__DOT__reg_a;
    b_state = u_b__DOT__reg_b;
}
时序反馈环在两个连续时钟沿上的执行过程如下。

-
• 存在两个方向的连线赋值, A→B与B→A均被展开。 -
• 两个模块采样的是对方旧值,因此 eval()内部语句顺序不影响结果。 -
• V3Order的依赖图中,两条连线边都被安排到时序逻辑之前。
💡 要点:时序反馈环的核心在于“同时采样对方旧值”,因此求值顺序无关,这是与组合反馈环的关键区别。
3.2 组合反馈环
若反馈路径为纯组合逻辑,则形成代数环。
mod_a.v(组合版)
   module mod_a (
    input  logic [7:0] from_b,
    output logic [7:0] to_b
);
    assign to_b = from_b + 8'd1;
endmodule
mod_b.v(组合版)
   module mod_b (
    input  logic [7:0] from_a,
    output logic [7:0] to_a
);
    assign to_a = from_a - 8'd1;
endmodule
top.v(组合版)
   module top (
    input  logic [7:0] seed,
    output logic [7:0] out
);
    logic [7:0] a_to_b, b_to_a;

    mod_a u_a (.from_b(b_to_a), .to_b(a_to_b));
    mod_b u_b (.from_a(a_to_b), .to_a(b_to_a));

    assign out = a_to_b;
endmodule
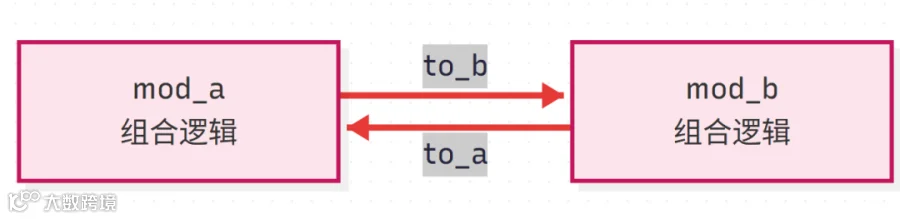
-
• 反馈路径上不存在寄存器,构成代数环。 -
• V3Order检测到组合环后,会将其标记为UNOPTFLAT。 -
• V3EmitC在生成的eval()中为该环插入迭代循环,直到信号稳定。
代数环的可能结果如下表所示。
3.3 组合环的生成代码
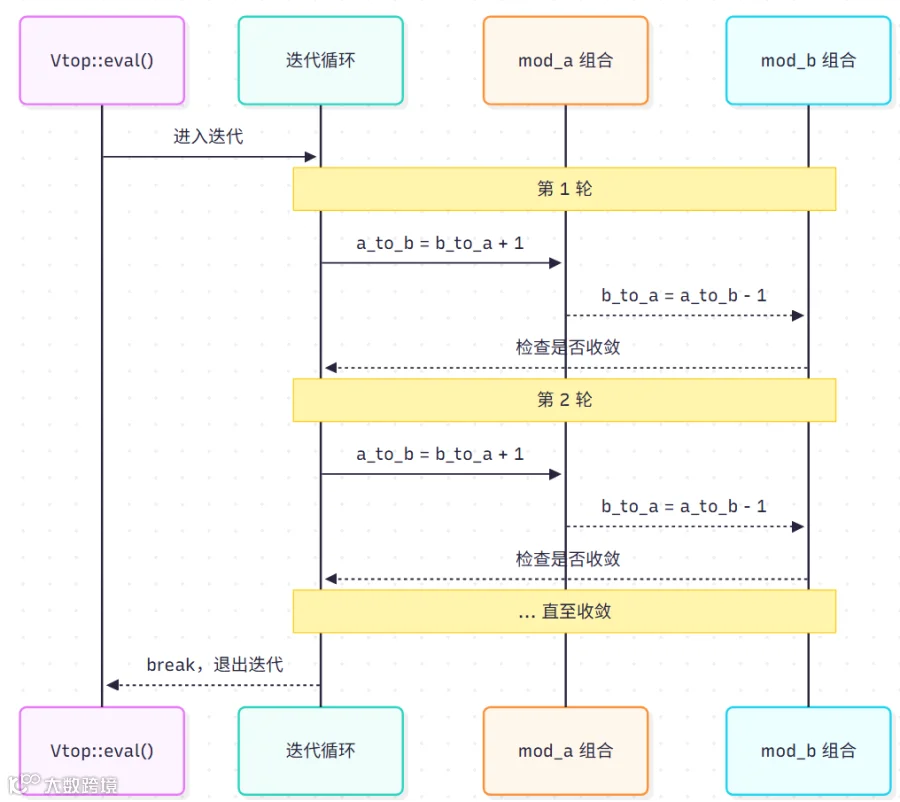
对于 UNOPTFLAT 标记的组合环,V3EmitC 会生成迭代收敛的 eval():
   void Vtransform: translateY(:eval_step() {
    // ---- 组合环迭代 ----
    VL_LOOP;
    for (int __iter = 0; __iter < VL_UNOPT_ITER; __iter++) {
        uint8_t __prev_b_to_a = b_to_a;
        uint8_t __prev_a_to_b = a_to_b;

        a_to_b = b_to_a + 8'd1;   // mod_a 组合逻辑
        b_to_a = a_to_b - 8'd1;   // mod_b 组合逻辑

        if (b_to_a == __prev_b_to_a && a_to_b == __prev_a_to_b) {
            break;                // 收敛,退出迭代
        }
    }

    out = a_to_b;
}
组合环的迭代收敛过程可以用下面的时序图表示。
-
• VL_UNOPT_ITER为 Verilator 内部定义的迭代上限。 -
• 每轮迭代保存旧值,执行环内逻辑,比较是否收敛。 -
• 收敛后退出循环, eval()返回。 -
• 若达到上限仍未收敛,工具会报错退出,避免无限循环。
⚠️ 注意:组合反馈环在同步设计中通常被视为设计缺陷。推荐在 Verilog 层插入寄存器打断反馈环,将其转化为时序反馈环。
   // 推荐:在 Verilog 中打断反馈环
always_ff @(posedge clk) reg_a <= from_b + 1;  // 寄存器隔离

// 不推荐:纯组合反馈
assign to_b = from_b + 1;  // 可能形成代数环
4. 子模块 eval 顺序的调度机制
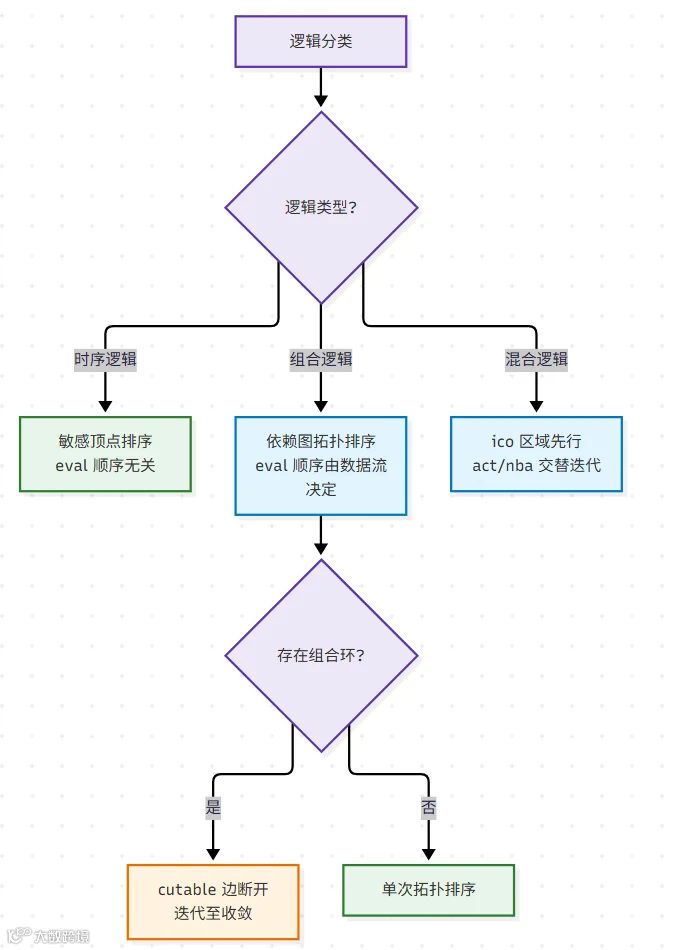
V3Order 构建语句级依赖图后,通过拓扑排序确定 eval() 内部的执行顺序。不同逻辑类型下,子模块 eval() 顺序的调度策略存在本质差异。
4.1 V3Order 的图构建与排序
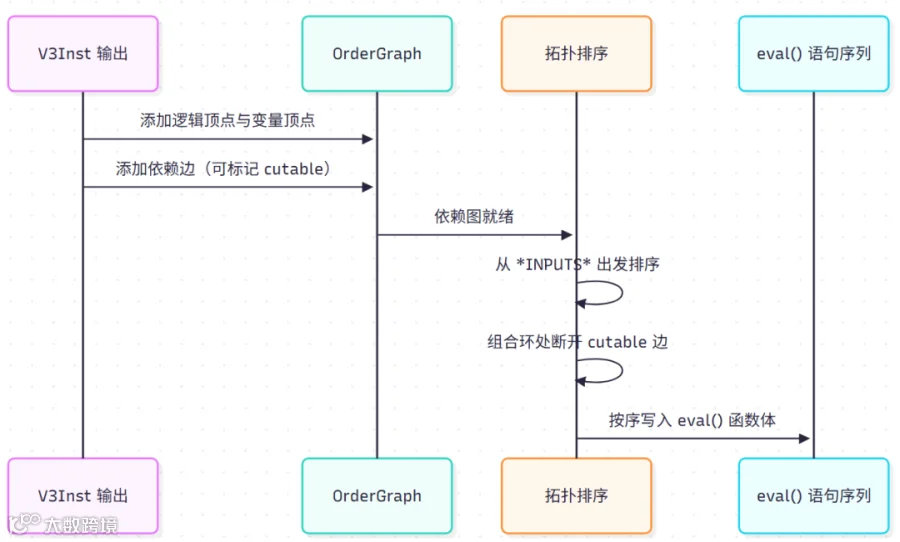
V3Order 的核心数据结构是 OrderGraph,包含三类顶点:
图构建完成后,V3Order 从 *INPUTS* 顶点开始进行拓扑排序,按依赖关系将逻辑顶点依次排序。对于组合逻辑,被标记为 cutable 的依赖边可在组合环处被断开,使拓扑排序能够继续进行。
拓扑排序完成后,执行顺序被写入 eval()。整个排序到生成的过程如下。
4.2 时序逻辑:eval 顺序无关
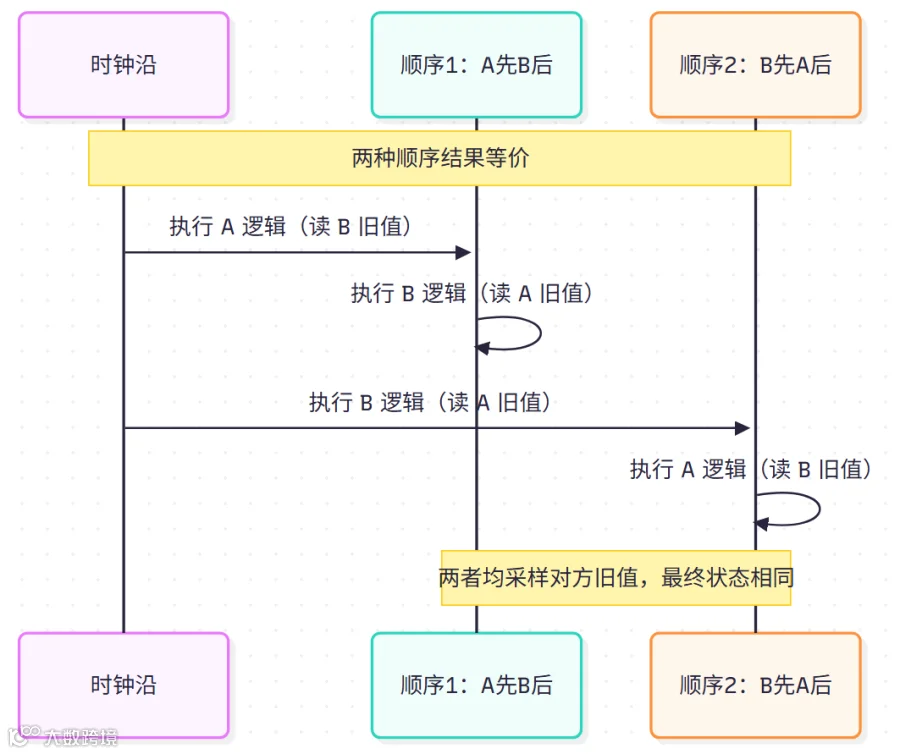
时序逻辑(always_ff)的赋值在时钟边沿发生,采样的是上一拍的值。V3Order 为时序逻辑创建敏感顶点(logic_sensitive_vertex),并将敏感信号指向逻辑顶点的边作为排序依据。
在同一时钟域内,两个时序模块之间不存在组合路径依赖,因此 V3Order 对它们的 eval() 顺序不做约束。无论哪个模块先执行,采样的都是对方旧值,结果一致。
   void Vtransform: translateY(:eval_step() {
    // 以下两条赋值的先后顺序不影响结果
    if (clk && !__prev_clk) {
        u_a__DOT__reg_a = u_a__DOT__from_b + 8'd1;
    }
    if (clk && !__prev_clk) {
        u_b__DOT__reg_b = u_b__DOT__from_a + 8'd2;
    }
}
两种执行顺序的等价性可以由下图说明。
4.3 组合逻辑:eval 顺序由依赖决定
组合逻辑的赋值不依赖时钟,信号在同一时间步内传播。V3Order 根据变量读写依赖关系构建有向边:若逻辑块 B 读取逻辑块 A 写入的变量,则 A 必须先于 B 执行。

在这种结构下,V3Order 将 A 排在 B 之前,确保 B 读取到的是 A 的最新输出。连线赋值(来自 V3Inst 的 AstAssignW)作为逻辑顶点参与排序,被安排到正确的执行位置。
组合逻辑的依赖执行时序如下。

4.4 组合环:迭代求值
当组合逻辑形成环时,V3Order 无法通过单次拓扑排序确定顺序。此时,被标记为 cutable 的依赖边被断开,环中的逻辑被归入一个迭代块,在 eval() 中通过循环反复求值直至收敛。
   // 组合环在 eval() 中的迭代形式
for (int __iter = 0; __iter < VL_UNOPT_ITER; __iter++) {
    uint8_t __prev_a_to_b = a_to_b;
    uint8_t __prev_b_to_a = b_to_a;

    a_to_b = b_to_a + 8'd1;   // mod_a 组合逻辑
    b_to_a = a_to_b - 8'd1;   // mod_b 组合逻辑

    if (a_to_b == __prev_a_to_b && b_to_a == __prev_b_to_a) break;
}
-
• 每轮迭代保存旧值,执行环内全部逻辑,比较是否收敛。 -
• 收敛后退出循环, eval()返回。 -
• 若达到上限仍未收敛,工具报错退出。
4.5 V3Sched 的区域划分与 eval 结构
V3Sched 将设计中的逻辑划分为多个评估区域,各自对应 SystemVerilog 的不同调度区域:
V3Order 分别对 ico、act、nba 逻辑调用 order(),生成 _eval_ico、_eval_act、_eval_nba 三个函数。顶层 _eval 函数将它们按区域顺序组合:
   void _eval() {
    // 'ico' 区域:依赖于顶层输入的组合逻辑
    while (true) {
        _eval__triggers__ico();
        if (!ico_triggers.any()) break;
        _eval_ico();
    }

    // 'act' 与 'nba' 区域迭代
    while (true) {
        while (true) {
            _eval__triggers__act();
            if (!act_triggers.any()) break;
            latch_act_triggers_for_nba();
            _eval_act();
        }
        if (!nba_triggers.any()) break;
        _eval_nba();
    }
}
三个区域在每个时间步内的调度时序如下。

-
• ico区域在每个时间步开始时执行,确保输入变化后组合逻辑先行稳定。 -
• act与nba区域交替迭代:act计算派生时钟信号,nba提交非阻塞赋值。 -
• 每个区域内部的逻辑顺序由 V3Order的依赖图独立决定。
4.6 不同场景下 eval 顺序的综合对比
5. Verilator 的自动处理边界
Verilator 的自动处理能力覆盖连线展开、求值排序、组合环迭代,但边界清晰。
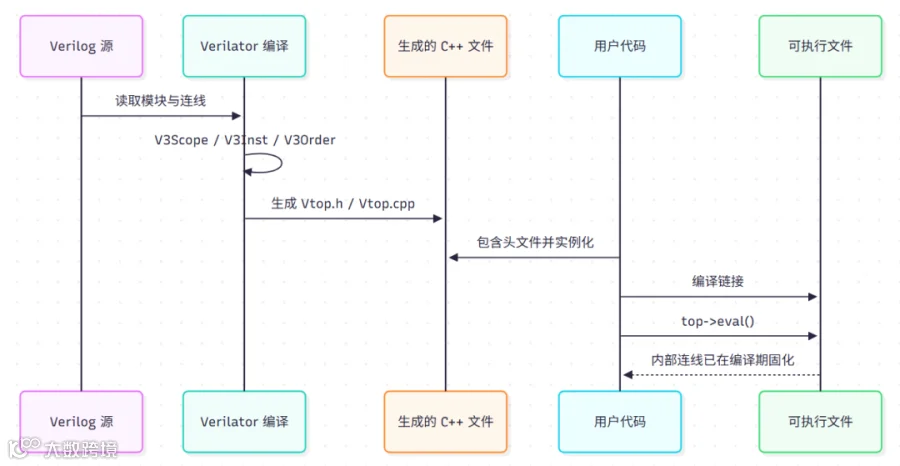
5.1 完整生成路径

从 Verilog 源到用户可执行文件的整体流程如下。
-
• 所有连线逻辑在编译期已经确定并固化到 eval()中。 -
• C++ 侧只看到顶层模型,内部连线、求值顺序、组合环处理全部被封装。 -
• 用户侧只需实例化一个 Vtop并调用eval()。
5.2 生成代码中的连线形态
5.3 边界之外的情形
以下情形超出 Verilator 自动处理范围:
-
• 运行期动态重连:连线在编译期固化,无法在仿真过程中改变。 -
• 双向端口:Verilator 不支持 inout端口,会报错。 -
• 跨工具联合仿真:与其他仿真器协同工作时,连线需在接口层手动建立。 -
• 行为级建模的连线:如 tran、rtran等开关级原语,Verilator 不支持。
6. 小结
核心结论:Verilator 通过
V3Inst将端口连接展开为AstAssignW,经V3Order排序后由V3EmitC生成eval()中的 C++ 赋值语句。不同逻辑类型下,子模块eval()顺序的调度策略由V3Order的依赖图自动决定,连线在编译期静态固化。
将前述内容归纳如下。
-
• 连线生成路径: V3Scope→V3Inst→V3Order→V3EmitC,最终形态为eval()内的普通赋值语句。 -
• 命名规则:变量名按层次路径构造, .替换为__DOT__,顶层信号无前缀。 -
• 单向连线: V3Inst按端口方向生成赋值,V3Order按依赖排序。 -
• 时序反馈环:反馈路径经过寄存器, eval()顺序无关,与单向连线处理方式一致。 -
• 组合反馈环:反馈路径无寄存器, UNOPTFLAT标记触发eval()内部迭代收敛。 -
• eval 顺序调度:时序模块间顺序无关;组合模块间由数据依赖决定;组合环迭代至收敛; ico→act→nba按区域顺序执行。 -
• 自动处理边界:连线展开、排序、组合环迭代均自动完成;动态重连、双向端口等超出范围。
明确 V3Inst 的展开机制、V3Order 的排序策略与 V3EmitC 的生成形态,是理解 Verilator 连线行为与 eval 顺序的关键。