


软件架构师罗小东,多年架构和平台产品设计经验,目前在 Agent 场景落地结合中。
概述
这里主要是记录一些过程,会略带有口语化。
业务场景需求是,将各门店的数据汇总,结合主数据、数据标准,按业务部门的要求,整理出销售报告和数据分析报告。过程主要包括多源数据采集,还有汇总,再结合数据标准一起处理。
周期大概是1个月左右的时间,期间是2个星期是试运行。
前期这个流程模式是由人工处理,汇总还有对账的,目前是由Agent和RPA业务处理,每天定时将结合处理之后,汇总发布到指定的业务人员邮箱里面,执行引擎使用的是AIPCowork(自研的Agent引擎,下面简称Cowork),还有RPA数据采集。
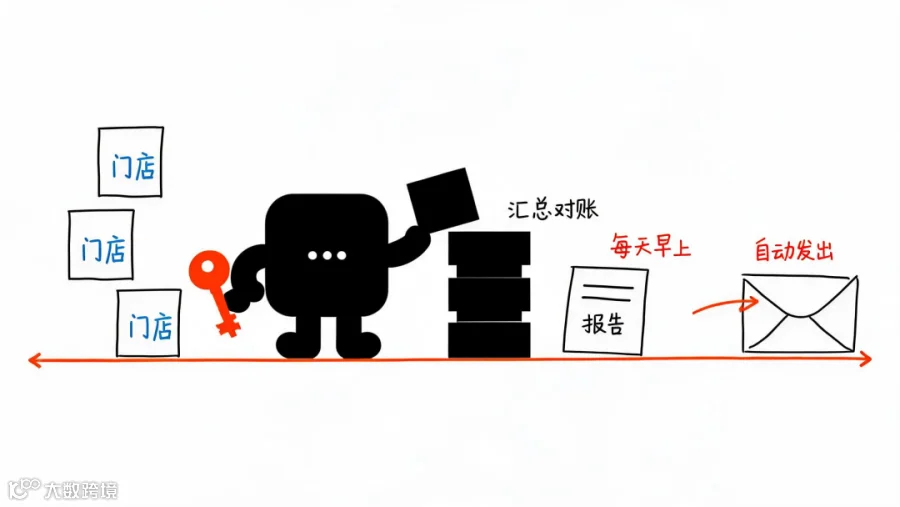
主要是将原来一天的汇总对账工作,每天早上让AI自动处理发给指定人员,最后结果发给确认这样。
这里主要阐述一些过程及分工是这样的:
-
• 这边提供的是Agent执行引擎,还有过程Harness技术设计。 -
• 交付主要由业务对接人员执行,包括过程的客户对接。
下面是遇到的一些问题点及定制化的内容:
-
• 多源数据数据采集的问题 -
• Cowork在SaaS下处理免登陆的问题 -
• 模型发散的问题Temperature参数配置 -
• 业务规则还有对账数据的问题
业务流程相对来说,比较简单直接,问题也比较少,相对来说也比较顺利,只是做了一些少许的定制化处理。后期的快速交付,也体现目前Agent的成熟和稳定性。
过程
这里针对问题和定制化内容的阐述。
多源数据采集和插件配置
这里主要是结合RPA,以及自行编写Cowork数据源管理插件来实现的。
由于实际业务中涉及的数据来源通常不止一个,并且不同数据源在格式、字段、更新频率、接口方式以及数据结构上都可能存在差异,因此需要对这些内容进行统一梳理和适配,避免后续接入和使用过程中出现数据混乱或处理不一致的情况。
在整体设计中,重点关注的是数据的稳定性和安全性。

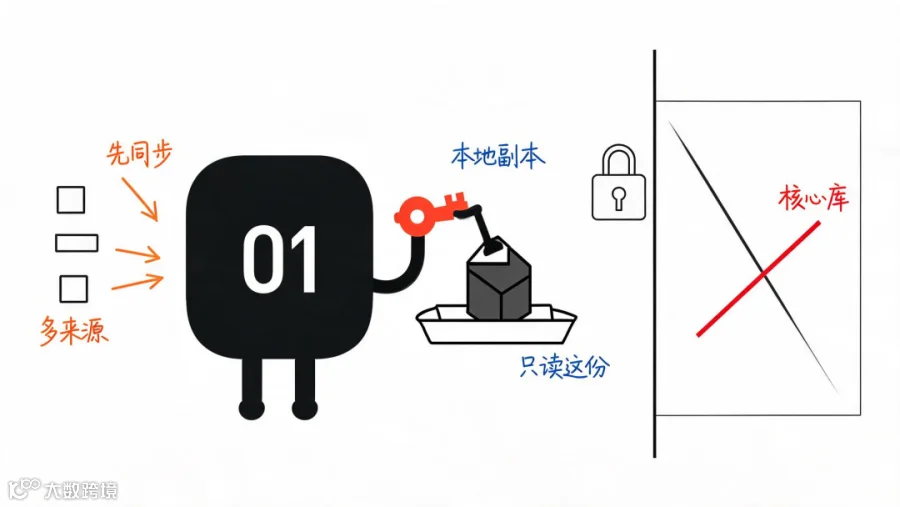
如果直接让Cowork工具或其他应用接触核心库,一方面存在越权访问、误操作修改线上数据的风险,另一方面也可能对核心库的负载和稳定性产生影响。因此,这里采用了“先同步、后接入”的方式,将多个数据源的数据先同步到本地,再写入本地数据库中,形成一份可独立使用的数据副本。
后续再接入Cowork工具时,实际处理和访问的是这部分前置库或本地副本,而不是直接操作核心业务库。这样既能够在一定程度上隔离风险,提升核心系统的安全性,也便于在本地环境中进行数据清洗、结构整理、格式统一以及异常数据排查,从而提高整体流程的稳定性和可控性。
另外一个插件的配置是邮箱插件。
这部分主要实现的是对外发送和通知能力。接入时,只需要配置客户指定的发送邮箱即可,包括账号、认证方式以及收件地址等基础信息。
在后期流程中,Agent会根据预设规则或任务触发条件,自动将相关数据、处理结果或通知内容发送到指定邮箱。这样可以在不需要人工频繁介入的情况下,完成邮件发送、结果反馈、提醒通知等动作,提升整体自动化水平和任务闭环能力。
Cowork在SaaS下处理免登陆的问题
原来的 Cowork 是 SaaS 模式,主要依赖用户登录后使用;而本地客户提供的是一台专用设备,用于在后台自动化执行流程。整个过程中不需要人工介入,也没有实时交互诉求。综合考虑部署环境、任务特性以及后续维护成本后,我们取消了原有登录模式,新增了本地免登录模式。
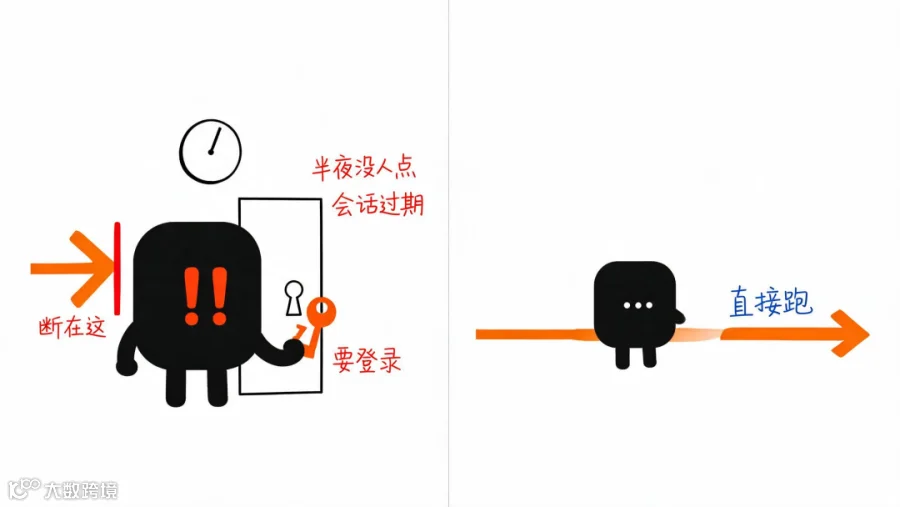
这也是我们在定时任务和长期自动化运行中需要重点考虑的一个点。Agent 引擎的应用场景其实很多,并不是所有场景都具备人工登录条件,也不是所有任务都需要登录态。若长期保持登录,在后台无人工介入的情况下,可能会因为安全策略、会话刷新失败或过期机制导致自动退出(即便会话有效期设置为半年,也可能实际失效)。通过本地免登录模式,可以减少对登录态的依赖,提升后台定时任务的稳定性和连续性。
模型发散的问题Temperature参数配置
这个是前期比较容易忽略的一个问题,主要解决的是模型发散的问题。前期并没有太过于重视这块,只是配置了默认的,没有针对性地调整相关参数,于是训练过程中就出现了下面的情况:
-
• 执行周期长,Agent不断的发散 -
• 推理周期长,而且不够聚焦
上面的情况,会导致任务结果稳定性不够,还有上下文容易跑偏,多轮执行成本明显上升,最终答案偏离目标,甚至形成无效循环。因此需要设定明确终止条件,控制工具调用频率,固定任务边界与执行步骤,并在关键节点加入自检、回溯与反思机制,避免模型持续发散,保证输出稳定、可控、可复现。

业务规则还有对账数据的问题
怎么样才叫“正确”,这里主要解决的,是每次跑出来结果不一致的问题。
也就是说,同样一批数据、同一个业务场景,不能今天跑是一个结论,明天跑又是另一个结论,而是希望结果能够稳定、可复现、可解释。
这个问题主要从两个方面着手。一个是业务规则,也就是业务上到底什么算通过、什么算异常、什么算需要复核、什么情况下应该被归入哪一类,这些判断标准要明确下来;另一个是主数据,包括基础字段、枚举值、状态定义、编码口径、业务对象之间的关系等,主数据如果不统一,后面无论怎么跑,结果都很难稳定。
除了输入侧要规范,处理完成之后,还需要做一次检查。这个检查可以类似于写 spec 一样,有一份明确的业务规范:哪些字段必须校验、哪些状态必须一致、哪些结果必须满足约束、哪些情况属于正常边界、哪些情况属于数据异常。同时,对于当前还不确定、暂时无法完全标准化的部分,也要明确列出来,尤其是会影响数据准确性的部分,需要单独标识、单独确认,而不是混在正常结果里。
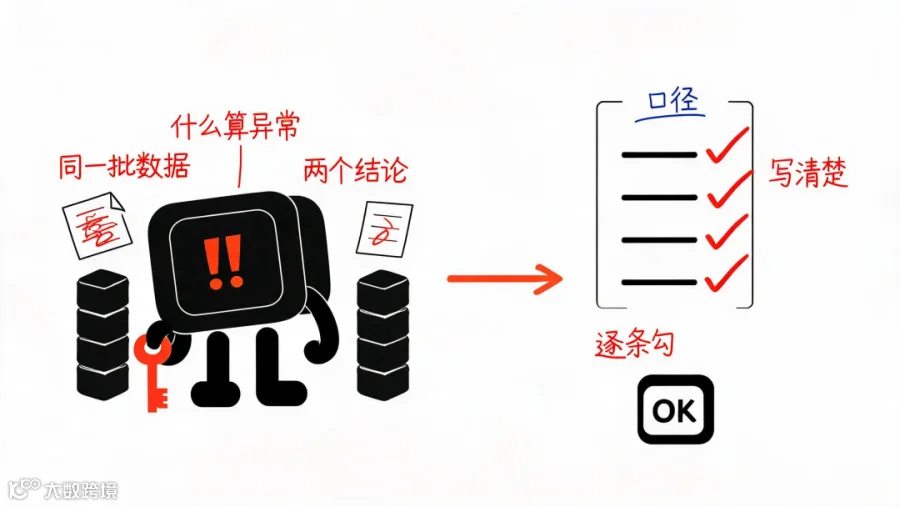
这一部分通常是整个过程中消耗周期最长的。特别是在前期还没有完整主数据、也没有清晰业务规则的情况下,问题会更突出。很多口径并不是纯技术问题,而是业务理解问题,需要跟业务方一起反复梳理、对齐,把原本靠人脑记忆或经验判断的规则,整理成规范文档,让流程能够统一执行,也让 AI 能够看懂、能按规则处理,而不是每次依赖临时解释。
过去这个阶段往往依赖人工对数,经验主要沉淀在具体人员身上。现在要做的,就是把这些散落的人经验、口头规则、隐性判断标准,系统地整理出来,形成稳定、清晰、可复用的业务规范和主数据标准。这样后续无论是人工复核,还是交给 AI 自动处理,才能有一个统一依据,也才能逐步解决每次跑结果不一致的问题。
总结
上面是一些临时笔记,主要也是做一些复盘,还有其它伙伴的了解过程。

这也是目前在规划和准备进一步落地的部分,目的是形成智能体的业务场景和解决方案闭环。一些FDE的交付经验分享,欢迎有兴趣的朋友讨论。