

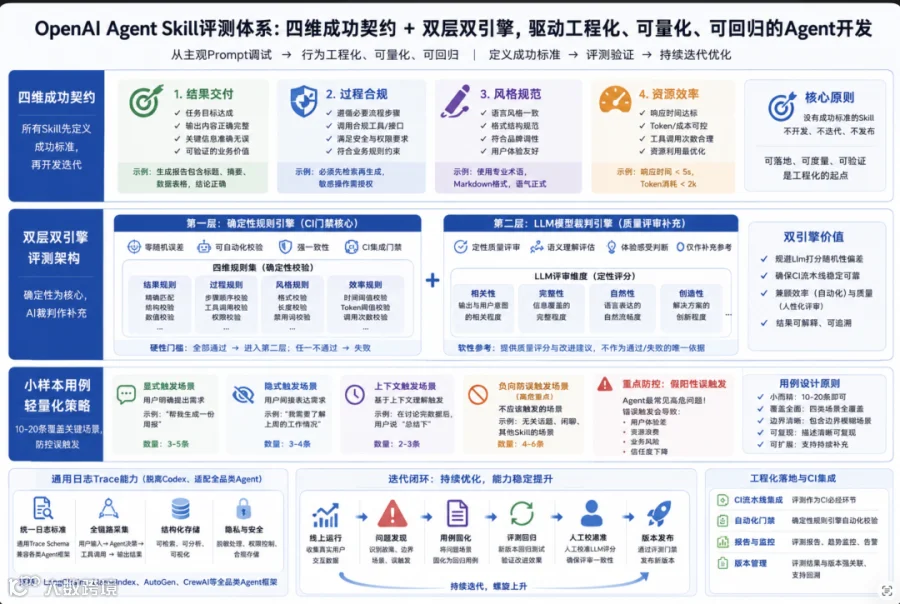
编者摘要:OpenAI Agent Skill评测核心是推动Agent开发从主观Prompt调试转向行为工程化、可量化、可回归,摆脱纯主观验收模式。体系核心为四维成功契约,涵盖结果交付、过程合规、风格规范、资源效率,所有Skill需先定义可落地的成功标准,再开发迭代。评测采用双层双引擎架构,以确定性规则引擎为CI门禁核心,零随机误差、可自动化校验,LLM模型裁判仅补充定性质量评审,规避模型打分偏差。用例采用小样本轻量化方案,仅需10-20条用例,覆盖显式、隐式、上下文触发及负向防误触发场景,重点防控Agent高危假阳性误触发问题。依托通用日志Trace采集能力,脱离Codex专属工具,适配全品类Agent。同时搭建迭代闭环,将线上故障、边界场景固化为回归用例,通过版本迭代回归、人工校准评分,实现Skill能力持续稳定优化,适配工程化落地与CI流水线集成。
附录:OpenAI Codex Agent Skill 评估方法论
核心一句话:Agent Skill 评估,不再靠主观感受,而是把 Skill 当成可回归测试的软件单元;先定义可度量的成功标准,再用「确定性规则检查为主、模型裁判为辅」的体系做评测,并且重点防范误触发(假阳性)
背景:OpenAI 这篇是针对 Codex 的 Skill 评测,Skill 是给智能体用的能力单元,放在 SKILL.md。很多人写 Skill 只是写长 Prompt,没有验收标准;这套方法就是补上 Skill 的单元测试 / 回归测试能力,可以接入 CI。
一、第一步:先定义「成功」,再写 Skill(4 大评估维度)
写 Skill 之前,先写验收标准,分成 4 类检查项,只保留必须通过的核心项,不要把所有偏好都塞进去:
- Outcome 结果目标:任务有没有做完
最终产物是否满足需求。例:项目能不能 npm run dev、目标文件是否存在。 - Process 过程目标:智能体有没有按预期调用 Skill、执行预期步骤
是否正确触发 / 不触发 Skill;执行的命令、调用工具顺序是否符合预期。重点:误触发(不该调用却调用)比不触发更危险,会改动工作区。 - Style 规范目标:产出是否符合团队 / 项目约定
代码规范、目录结构、组件写法、命名约定这类偏定性的要求。 - Efficiency 效率目标:有没有无效折腾、浪费 Token
是否循环重复执行命令、多余操作;输入输出 Token 消耗是否可控,避免 prompt 膨胀。
定义 Done 的价值:没有这套标准,Skill 只是长 Prompt;有了之后,Skill 支持版本管理、回归测试、CI 自动化。
二、构建评测用例集:小样本起步(10~20 条)
不需要大规模基准集,少量 case 就足够发现回归问题,用 csv 维护,4 类 case 缺一不可:
- 显式触发
直接带 $skill-name调用,验证 Skill 可以被显式唤起,防止改名 / 改描述导致直接调用失效。 - 隐式触发
不提及 Skill 名字,只描述业务场景,靠 SKILL.md里的description让模型自动选择 Skill。检验描述是否足够精准。 - 上下文触发
在带有额外领域噪声信息的 prompt 下,依然能正确识别场景并调用 Skill。模拟真实用户复杂提问。 - 负向控制(最重要)
:场景相似,但不应该触发 Skill。用来抓假阳性误触发。 原文例子:用户想给已有项目加 Tailwind,Skill 却新建完整 demo 应用,就是典型危险误触发。
后续开发遇到的真实 bug,持续追加成新用例,这个用例集是活的。
三、评测执行架构:Trace 事件流是第一性证据
原则:确定性规则检查是主力;模型 rubric 打分只是第二层补充,不能替代规则
- 采集原始 Trace 证据
使用 codex exec --json执行智能体,输出 JSONL 结构化事件流。 Trace 里包含:命令执行事件、文件变更、token 消耗、步骤启停事件。 好处:可复现、可解释,直接读事件做自动化判断,放进 CI 流水线。 可以拿到:是否执行npm install、创建了哪些文件、执行命令顺序、token 用量。 - 第一层:确定性检查(硬规则,优先跑)
写代码解析 JSONL 事件流,做布尔判断,完全稳定无随机性: -
命令执行校验:是否执行指定命令、有没有循环重试 -
文件产物校验:package.json、指定组件文件是否存在 -
效率校验:统计命令次数、input/output token,设置预算上限 -
产物运行校验: npm run build、轻量服务冒烟测试(可选,成本更高) -
工作区干净度:检查是否遗留多余文件 - 第二层:模型打分(rubric 规则量表,处理定性规范)
硬规则无法覆盖的风格、代码规范、结构质量,交给模型裁判。 做法: -
定义固定 JSON Schema 输出,强制模型返回结构化结果:整体是否通过、总分、分项 check 列表 + 备注 -
让模型只读仓库做评审,不修改文件 -
结果结构化,方便脚本聚合、对比不同 Skill 版本的分数变化 -
可接入 GitHub Action CI
四、完整评测工作流
-
前置:定义 4 维成功标准,写好 Definition of done -
开发 Skill,手动跑一遍,暴露隐藏假设:触发条件、环境依赖、执行顺序问题 -
构建 10~20 条小测试集(显式 / 隐式 / 上下文 / 负向) -
自动化执行: codex exec --json,保存 JSONL trace -
执行确定性规则检查,输出结果 -
(可选)模型 rubric 做风格定性打分 -
聚合分数,判断是否回归;发现失败案例 → 新增进测试集 -
持续迭代:逐步增加更重的检查(build、runtime 冒烟测试)
五、核心思想转变:从 Prompt Craft → Behavior Engineering
传统做法:反复调 Prompt 文本,凭主观感受好坏; 新范式:把 Skill 看作可测试、可评分、可回归的智能体行为单元。 Skill 不只是写给大模型看的说明书,而是一套具备可验证行为契约的组件,每次修改 Skill 都可以自动验证:
-
该触发的时候能不能触发 -
不该触发的时候会不会乱触发 -
执行步骤是否符合预期 -
产出物是否满足规范 -
资源消耗是否可控
六、工程落地要点总结
-
负样本优先级很高,假阳性误触发是 Agent Skill 最容易踩的坑; -
Trace 事件流是根源证据,优先基于事件做硬规则判断,减少模型裁判带来的随机性; -
从小用例集起步,真实故障驱动扩充测试用例,不要一次性构建庞大评测集; -
分层评测:轻量快速检查放 CI 主干,重的构建 / 运行冒烟测试按需开启; -
所有评测结果可对比,每次 Skill 变更都能看到是否引入行为回归。