
阿里CEO吴泳铭在云栖大会上抛出一个锐利判断:未来机器的思考总量将超过人类1000倍,99.9%的思考工作将由机器承担——但"机器智能时代的标志性产品,尚未诞生"。 他把AI Coding比作"1882年的电灯",意思是:方向对了,但离真正的普及还隔着整个电气革命。
与此同时,学术界正用一批硬核论文,把"超级智能"从口号拆解成可落地的工程蓝图。这些研究指向同一个结论:AGI的终局不在于把对话模型做得更大,而在于让AI拥有理解物理世界的"大脑"、操控物体的"手脚",以及一个能在行动前先"预演"未来的世界模型。
一、世界模型:不是"生成视频",而是"压缩物理现实"
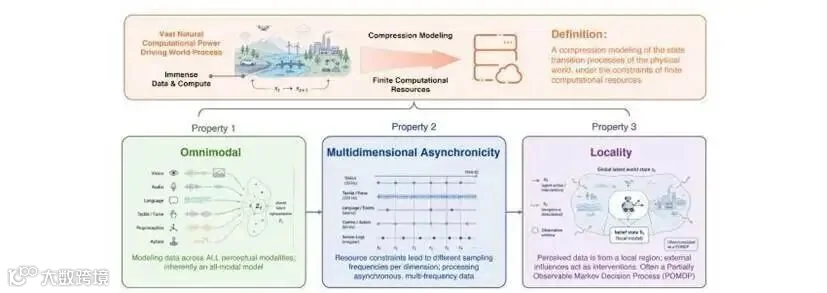
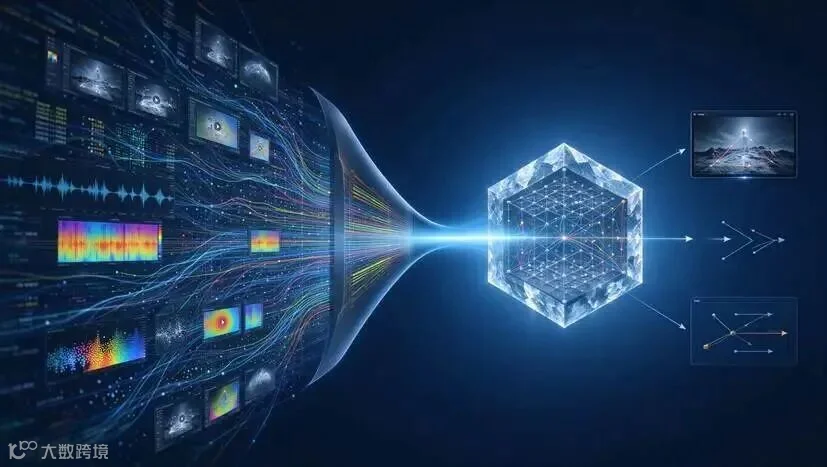
上海AI实验室给出了一个克制却锋利的定义:世界模型,是在有限算力约束下,对物理世界状态转移过程的压缩建模。
注意,关键词是"压缩",不是"生成"。世界模型的核心使命,是把高维、冗余、充满噪声的物理观测,蒸馏成紧凑可用的物理表征。视频生成只是压缩到位后顺带涌现的副产品,绝非目标本身。
由此衍生出三大核心属性:
- 全模态:视觉、听觉、触觉等所有感知通道同时建模,而非只处理单一信号;
- 多维异步性:不同维度数据的采样频率天然不同,视觉可能30帧、触觉可能1000Hz,模型必须兼容这种"不同步";
- 局域性:智能体只能看到局部信息,外部影响只能以干预形式存在,天然构成一个部分可观测马尔可夫决策过程(POMDP)。
最值得反复咀嚼的判断是:"数据决定上限"——任何智能系统在物理世界的泛化天花板,由训练数据的物理多样性决定,而非模型结构本身。 目前唯一能量级提供这种多样性的数据源,是开放互联网:每一段看似普通的视频中,都暗含物体恒存、刚性与柔性碰撞、遮挡与因果链条等物理常识。
二、从条件反射到谋定后动:世界-动作模型的崛起
如果说世界模型是"物理世界的大脑",那机器人还需要一个把想象转化为动作的接口——近三个月,这个接口有了正式名称:世界-动作模型(WAM)。
传统VLA(视觉-语言-动作)模型的逻辑是"看到什么就做什么",本质上是条件反射。WAM多走了一步:先在内部预测"这样做下去,物理世界会变成什么样",再决定是否执行。这一步之差,把机器人从"刺激-反应"推向了"想象-评估-行动"。
这条赛道正在集体冲刺:
NVIDIA的Cosmos 3 采用统一混合专家Transformer架构,把语言、图像、视频、音频、动作五种模态塞进同一个模型,宣称一个框架同时覆盖视觉语言理解、视频生成、世界模拟和世界-动作四大能力。
智元机器人的GE-Act 2.0 是首个"原生"世界-动作模型——从随机初始化开始、直接在具身数据上从头训练,不针对任何评测任务做微调。它用自研CoAE编码器把一帧256×384画面压缩为仅24个token,是DINOv3的十六分之一,在RTX 5090上生成一个动作块只需104毫秒。
最震撼的发现是"机器人Scaling定律"得到验证: 训练数据从300小时扩到3万小时(100倍),机器人在陌生场景零样本测试中能完成的精细任务从39项跳到76项——折叠毛巾、嵌套纸杯、插花等此前完全无法理解的动作,在数据量到位时"突然开窍"。

三、数据喂养:倒置金字塔工作流
Scaling的前提是数据,而物理数据的获取有一个LLM不曾面对的难题:动作标签极度稀缺、采集成本极其高昂。 谁能在"低成本获取足够物理多样性的数据"上胜出,谁就拿到了物理AI的入场券。
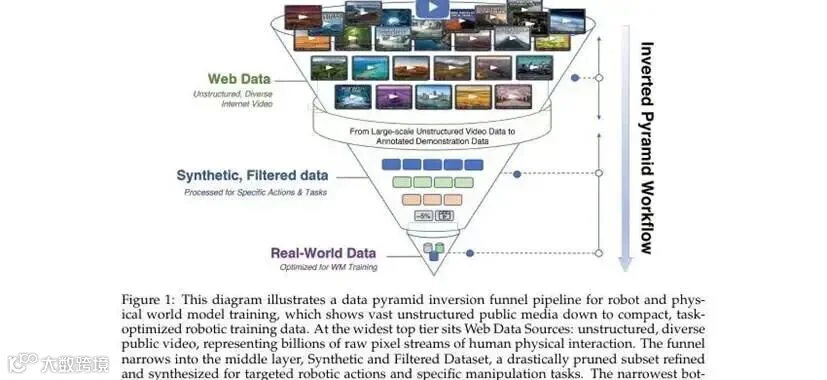
目前的方法论被称为"倒置金字塔工作流":
第一层,用数十亿量级的互联网视频解锁隐含的物理先验——专有机器人数据在多样性上注定无法与互联网竞争,不如先"借用"互联网里现成的物理常识。
第二层,逐层过滤、合成、提纯,将粗粒度的物理先验转化为任务对齐的紧凑数据。
智元与上海创智学院联合发布的τ0-WM 是这条路的大规模实践:在约27,300小时异构语料上预训练(含17,800小时真机遥操作、6,500小时UMI、3,000小时第一人称人类视频),模型仅5B参数,却将"动作生成""视频预测""任务评估"统一进一个共享预测表示。推理时,它采样多个候选动作,用动作条件视频模拟器"预演"未来,再挑出最有前景的一条——形成一个"提议-评估-修正"的闭环。
海外方面,Riemann-1.0 用超过20万小时交互数据,把"可执行的机器人策略"和"多本体视觉世界模拟器"融合进同一自回归模型,在RoboTwin2.0上取得94.3%、LIBERO上99.0%的成功率。
一个核心判断:机器人在重走LLM走过的Scaling之路——数据规模与多样性决定能力上限。 但物理数据比文本数据贵得多,这使得数据获取策略本身成为了核心竞争壁垒。
四、具身AGI分级:我们仍在L1-L2之间
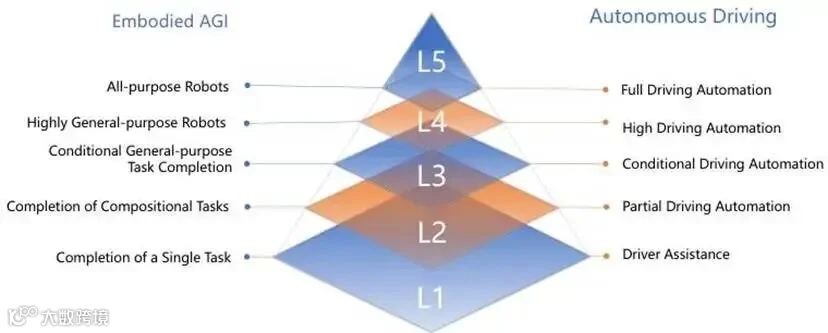
有了世界模型和动作接口,离AGI还有多远?南洋理工大学的综述给出了一个冷静的分级框架,参照自动驾驶的成熟度划分:
- L1:单任务完成
- L2:组合任务完成
- L3:有条件的通用任务
- L4:高度通用
- L5:全天候自主全能机器人
论文结论冷峻而清醒:当前所有具身智能系统,都处在L1到L2之间。 距离真正的L5,还隔着数个技术代际。
分级依据四个维度:全模态能力、类人认知、实时响应、开放任务泛化。最难跨越的是"类人认知"——自我意识、社交连接理解、程序性记忆、记忆重构。 这些能力无法通过现成的监督学习或强化学习获得,它们要求终身学习:模型部署后仍需持续更新内部状态,而非训练完成就"冻结"。
这恰恰是"具身AGI"与"聊天AGI"的本质分野:语言模型可以靠参数冻结稳定运行,但一个真正通用的机器人,必须像一个有记忆的生命体,在每天的交互中持续进化。 这既是技术挑战,某种程度上也是哲学命题。
五、ASI的另一条路径:垂直超级智能先行
通用AGI追求"广度",但超级智能(ASI)也可以先走"深度"。Alias Robotics的论文展示了一个垂直领域超级智能的真实样本——网络安全。
进化分三步:
第一步,PentestGPT让AI"辅助"人类做渗透测试,AI提供引导、人类负责执行;
第二步,网络安全AI(CAI)达到专家级水平,以3600倍于人类的速度、1/156的成本完成安全任务;
第三步,G-CTR将博弈论(纳什均衡)嵌入LLM Agent,使其在攻防对抗中具备超越人类的战略推理——成功率翻倍,行为方差降低5.2倍。
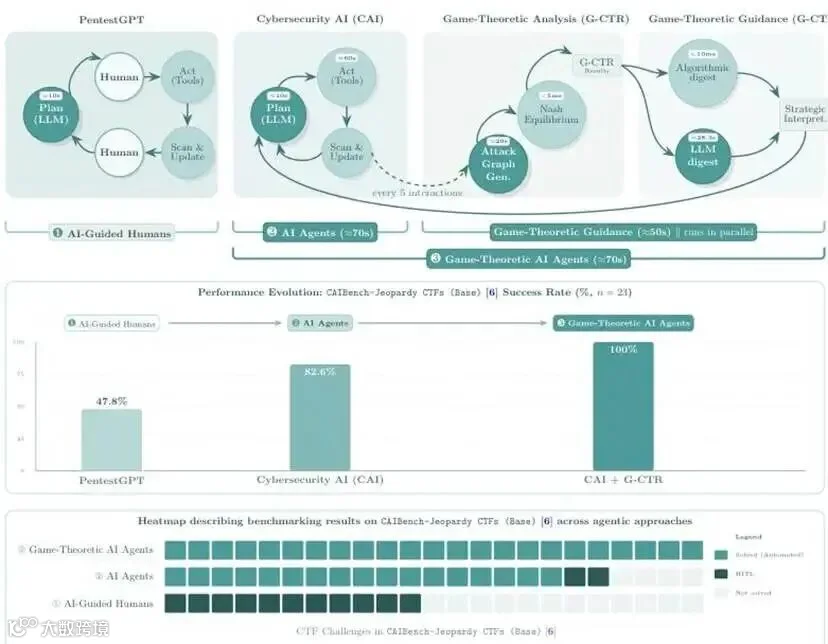
人机关系发生了三次反转:人类从执行者退为操作者,再退为监督者;AI从顾问升为执行者,再升为战略行动者。 当攻防双方都用上博弈论AI,网络安全就从"人机协作"演变为"算法军备竞赛"。
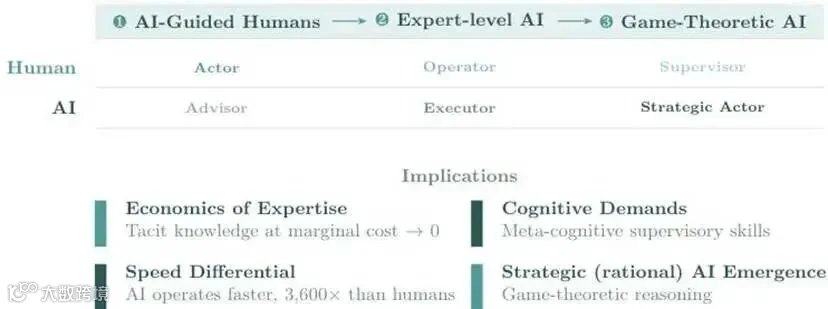
这为"超级智能"提供了另一种想象:ASI不必是一个全知全能的通用大脑,它可以是"在某个窄领域达到超人水平的智能系统"。 尤其当它被装进一个能行动的物理实体时,AI Agent、人工生命与机器人的合流,可能通向一种全新的硅基超智能形态。
六、机器人的大脑该长什么样?
综合上述研究,下一代世界模型的路线图逐渐清晰:
第一阶段,做统一多模态世界模型;第二阶段,做统一物理表征——一个压缩状态配多个解码器,渲染、模拟、规划都从同一状态解码;第三阶段,做成基础规模交互式模拟器——一个闭环、可复用、能安全试错的虚拟物理世界。

这回答了一个根本问题:机器人大脑不该是三个各管一摊的模块(一个看、一个想、一个动),而应该是一个统一的压缩表征,配上一个能把世界"预演"出来的模拟器。
未来真正难的不是让机器人"会做",而是让它"能想"——在真实世界里动手之前,先在内部把方案推演无数遍,并且推演得足够准。
当然,这条路并不浪漫。能量消耗、真实性与精度的权衡、长时间预测的误差累积、从仿真到现实的鸿沟——每一个都是硬骨头。更本质的隐忧是:当世界模型足够强、机器人足够通用,人机关系会不会重演网络安全领域里的"角色反转"——人类从执行者退居监督者,而智能体在物理世界里越跑越快?
世界模型是连接AI与物理现实的那座桥,机器人是AGI在物理世界的落脚点。当足够多、足够多样的物理数据喂进一个足够大的世界模型,机器人或许真的会在某一天"想明白了"再动手。
而我们要做的,是看清方向,同时认真思考:把世界交给机器人的大脑时,我们该把什么握在自己手里。

关注抖音【靓哥聊创业】
抖音号|54707203975
保存二维码打开抖音扫一扫