


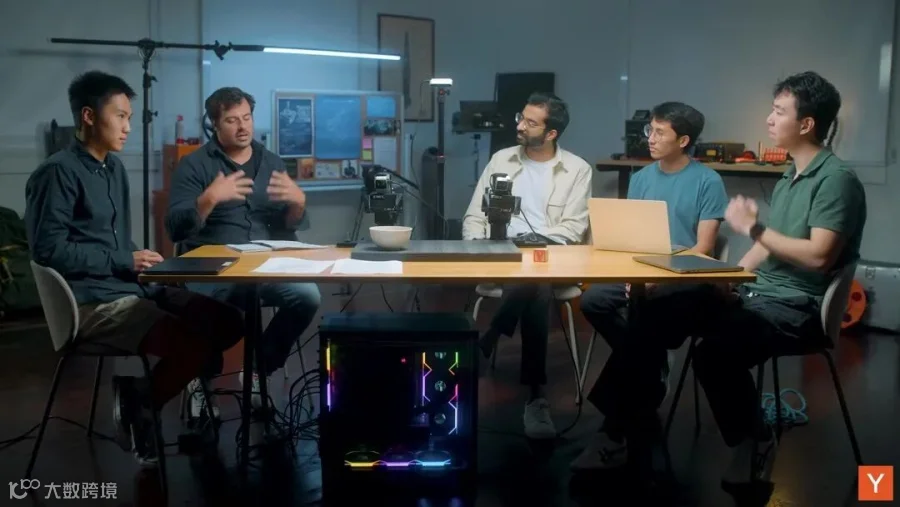
左:François,中:Jay,右:Vincent
RT-2 之后,机器人圈一直在等一个答案:控制机械臂的模型,到底要不要靠海量机器人数据专门训一遍。当通用大模型开始自己写代码、自己调工具,这个问题突然变得不好回答了。
对话里最直接的一幕是现场演示:Astra 只靠摄像头输入,在多轮工具调用中把桌上的方块拿起来放进碗里;但 Jay 当场指出,演示之所以慢,是卡在 Astra 的延迟上。Hanmei 猜测,Astra 在视觉上特别强,可能是因为预训练时用了比以往多得多的 computer use 数据,也已经用了大量 CAD 数据,这些数据大概都让模型学到了和大量机器人数据相似的对物理世界的理解。
本期由 Y Combinator 的 François 与嘉宾对谈:Waddle Labs 联合创始人 Hanmei 和 Vincent、Robocurve 联合创始人 Jay。Waddle Labs 让 LLM agent 自己写代码去控制任意机械臂,Hanmei 是 Harvard 数学系出身、曾任 Math 55 助教,Vincent 即宋亦丁,在 Gershman Lab 研究 Transformer 如何在上下文里做程序归纳;Robocurve 做的是用真机评测机器人模型,Jay 是其中一位联合创始人。这场对话从 RT-2 讲到代码即策略,从上下文学习的天花板讲到电脑端数据为什么能教会机器人物理世界。他们的主要观点包括:
苦涩的教训在这里不是架构问题,而是数据问题。 Vincent 认为,VLA 本来就搭在语言模型之上,数据瓶颈念了好几年进展很慢。关键的跨模态迁移,是把机器人这种传统上的分布外任务,变成拿了最多数据的那个模态的分布内任务。
干脆用最强的基础 LLM 控制机器人,而不是专门训一个机器人模型。 Hanmei 说,VLA 和 GPT-5 的关键差别不一定是架构,而是训练路线:往模型里灌 computer use 数据和编码数据,最后得到的本来就是通用 LLM agent,那何必再依赖机器人数据。
代码即策略最出彩的地方是一次性求解,不需要额外机器人数据。 Hanmei 提到 Google DeepMind 那批工作:把抓取、抬起、移动到某位姿写成 Python 函数给 coding agent,它就能写出调用它们的代码完成复杂任务,因为它已在海量代码数据上训练过。
上下文学习提升快但很快见顶,还容易波动。 François 留出 GSM8K 做 ICL 实验发现:提升很大而且几乎不花算力,但不是单调的,大约二三十到四十个例子就饱和,超过训练上下文长度后反而变差。再往上还有 RAG、LoRA、全量 SFT 和 RL 一层层递进。
延迟是眼下的一个大问题,但改善得非常快。 Jay 说现场演示慢是卡在 Astra 的延迟上,而这一档大模型每个月的延迟大约翻一倍,这个趋势延续下去,今年年底就能做到实时控制机器人。Hanmei 也说,让 Astra 一直待在回路里、每一步都要思考,太慢,经济上根本不成立。
computer use 数据能教机器人空间推理和上下左右。 Hanmei 说这类数据单独训模型用不到机器人上,但喂给大模型后,在屏幕上拖光标让 Blender 里的物体转起来,本身就在教空间概念。所以代码、computer use、第一视角视频应该全喂给同一个模型。
通用机器人两年内就会来,社会还没准备好。 Jay 说前沿实验室和做机器人基础模型的公司内部已有共识:两年内,甚至更早,就会出现通用机器人,随便一句自然语言指令,它能做到手脚麻利的十几岁孩子空手能做到的事。
上下文学习最终要沉淀下来,机器也需要睡觉。 François 说几乎所有有智能的东西都睡觉,睡眠中会发生压缩,类似 DAgger 那样收集数据、回头反思、更新权重文件,再蒸馏回自己的模型;Vincent 说这很像 DreamCoder 的睡眠阶段重构技能库。

从RT-2到苦涩的教训:机器人为什么开始吃语言模型的数据
Jay:最早把 AI 成功用到机器人上的方法之一就是 RT-2 那篇论文。他们在网页文本和图像上预训练语言模型,再用它来控制机器人。有意思的是,它就是语言模型微调出来的版本。它不输出英文,而是输出我们说的末端执行器位姿,也就是一组坐标,你可以把它转成关节指令来控制机器人。
某种程度上,这跟我们现在看到的 LLM 很像,只不过现在是模型足够强,不用微调,开箱就能干。
François:这其实很像我脑子里那个对应关系,就是 CoT、思维链的那个时刻。当年做 GSM8K,题目说 Susie 有 8 块钱,花了 5 块,现在还剩多少?模型必须输出四个井号,然后答案,然后 EOS,它没法思维链。后来我们允许它先说,好,8 减 5 等于 3,然后井号井号井号井号 3。也就是在给出动作或答案之前,先让它想。
现在也一样。VLA 基本就是一步到位,RT-2 基本就是必须直接输出动作,我没法为更复杂的任务多分配一点算力。而现在的代码思维链就能做到。就算你不真的输出代码,只是把它给模型,让它想想想想想,再输出动作也行。而且用代码的好处是,代码长度在柯尔莫哥洛夫复杂度上更低,用一段非常紧凑的代码,直接就是,代码在这儿。
Jay:对,我完全同意。说到底,这很大程度上就是苦涩的教训。你给 agent 或者给 AI 模型更多自主性,稍微松开点束缚,多给点资源,它其实就能做到很多我们本来要靠微调才能做到的事。
Vincent:我也插一句。我觉得苦涩的教训在这里真正有意思的地方是,VLA 从设计上、架构上本来就是搭在语言模型之上的,它们有推理的潜力,也会写代码。所以苦涩的教训也许不在于你一定要建什么架构,而在于什么数据最有用。大家嘴上念 VLA 的数据瓶颈已经念了好几年,进展一直非常非常慢。所以这里的教训可能是,我们有一种已经知道非常好用的数据模态。而跨模态迁移这件事,Hanmei 和我都特别兴奋,就是怎么把传统上属于分布外的东西,比如机器人,变成分布内的。也许践行苦涩的教训的方式就是,挑一个我们有把握的数据模态,它数据多,模型理解得好,然后拿它去解锁其他很多领域。
Jay:对,我再补一点。RT-2 之所以是这么好的模型,是因为它用的语言模型接到了语言模型训练所用的全部数据模态上。那些网页图像和网页文本标注,确实让这个 VLA 比不做任何预训练、直接训一个专门的机器人基础模型要强。
主持人:所以 RT-2 这类早期 VLA 路线,受益的是预训练。那在动作微调这条路上,原本的限制是什么,现在又怎么绕过去了?如果可以直接写代码,你刚才提到的其实是数据上的差别。这个数据上的差别到底是什么?RT-2 之后,模型在很多方面都变强了。
Vincent:比如第一,工具使用强多了。现在有一类数据就是,这些模型代码写得比以前好太多,所以它们能把复杂的策略写成代码。它们也更会用工具去探索所处的环境,比如自己能操作哪些机械臂。而这很大程度上来自上下文学习。
Hanmei:这些 VLA 和 GPT-5 或者 LLM 的关键差别,其实不一定是架构,而是你训练时采取的路线。我们想做被苦涩的教训洗脑的人,我们要吃各种数据的红利。我们想往机器人模型里灌 computer use 的数据,想往里灌编码数据。但你这么一灌,最后得到的就是我们说的那种通用 LLM agent。所以在我看来,那为什么不干脆做一个特别强的基础 LLM,然后用它来控制机器人,而不是去训一个专门给机器人用的模型,还得那么依赖机器人数据?

代码即策略与Voyager之后:学习的框架分几种
主持人:说到这个,如果时间倒回两年,我觉得「代码即策略」这个方向本来就是一个很好的信号,说明我们走在正确的路上。你们能不能聊聊,研究圈说的「代码即策略」到底是什么意思?我觉得值得放回当时的背景下看——那篇论文出来的时候,coding agent 才刚开始能用。那还是个大家靠写注释来自动补全 Python 代码块的年代,现在看像上古史,但那其实就是两年前。所以「代码即策略」是怎么工作的?它又是怎么启发了你们今天觉得可能的事情?
François:我大概会倒回到 Voyager,它是最早的那一批之一。coding agent 到底意味着什么?它需要好的工具使用能力,还有随手造工具的能力。造出来的东西就叫代码。你有 Python 内置函数,假设我只有内置函数,那些就是工具;然后我有 sort,有 if,有 for,有 while,有这些东西。我要用这些工具组装出一个新工具,叫一个新的 francois.py。这就是新工具,我接下来就能用它。
Voyager 就是这么干的。我不说 Voyager 是第一个这么做的,但它是做 Minecraft 里最出名的那个。它们能随手造出工具来调用,把游戏玩得更好,把思考和经验压缩成一个新工具,之后我再去调用它。
François:到 2024 年的时候,大家都有这个判断:只要我把全部的心血、资源、算力和智能全砸进去,把编程能力做上去,我们就能起飞。然后我就能把机器学习工程师自动化掉,接着我就真的起飞了,所有问题我都能解决。所以大家就都这么干了。但我不觉得他们当时真看明白了,说哦,我这么做之后,就能得到足够强的 LLM,强到可以给机器人写策略,我就能用真正的 coding agent 把整个机器人行业掀翻,还能用写 JavaScript 做漂亮艺术作品的 coding agent 把艺术家也掀翻。说实话,我不觉得他们当时有这个洞察。
主持人:能不能聊聊,早期那些「代码即策略」的方法到底能干什么?那个时候,coding agent 还远没有普及,大家也没有凭直觉就懂它怎么工作,也远没到用 RL 把 coding agent 训得特别会调工具的阶段。那早期这些方法,可能比 Voyager 还早的,比如 code as policies,我记得论文是 2022 年底出来的,差不多跟 ChatGPT 同期——它们当时的能力跟现在比是什么水平?
Hanmei:对,那些 code as policies 的论文,尤其是 Google DeepMind 团队的,特别厉害。他们做的事是造出一批函数,比如抓起一个物体、抬起来、移动到某个位姿,然后把这串函数以真正的 Python 函数的形式给 coding agent。coding agent 就能写出调用这些函数的代码,去控制机器人完成很复杂的任务。
最让人意外、也最出彩的地方是,coding agent 一次性就能做出来。它不需要额外的机器人数据,因为它已经在海量代码数据上训练过了,它已经知道要把方块放进碗里,先做什么、后做什么。我觉得正是这种一次性求解的能力、这种在上下文里探索的能力,推动了很多团队继续做数据方面的探索,包括我们,去研究怎么把 LLM 用到机器人上。
主持人:François,你之前讲过一套框架,说学习有很多种发生方式,有的学进权重里,有的是上下文学习,等等。你要不要简单讲讲这个?然后我们可以想想,过去这几年这些研究分别落在框架的哪个位置,尤其是它现在的走向。
François:我一直在做这个实验,其实还没写成论文。大概就是:从智能的角度看,把一个「状态—动作—结果」或者「状态—动作—奖励」的元组喂回策略,最高效的方式是什么?有 ICL,也就是上下文学习,我就是把它追加进去——大多数人用 LLM 就是这么用的,哎呀别这么干,你这么干;然后它还在上下文里,我能记住,能迭代。
但这只在你训练过、至少后训练过这个 LLM、让它具备学习和自我改进能力的情况下才成立,就是很早那批自我精炼和反思的文献,把多轮对话真正加进训练集里。没有这些,它就不学;或者说也学一点,但即便如此,ICL 能到的上限是有限的。
所以我做过这个实验:拿一个我们训过的 LLM,我留出一个任务,简单点就用 GSM8K。然后我做 ICL,看它在验证集上每个样本能提升多少。提升很大,而且很便宜,不花什么钱,没有 SGD,不烧算力。所以我很快就能在验证集上适应和提升,一个一个例子喂进去。第一,提升不是单调的,这很离谱,它一会儿变差一会儿变好,来回波动还挺剧烈。第二,它很快就到顶了,大概二三十个、也许四十个例子之后基本就饱和了,再往上下文里塞例子也没用。
主持人:等于说,你受限于模型能不能聪明地用满它自己的上下文。
François:从后训练看,它到底被喂了多少轮多轮对话,才学会自我改进和自我反思?然后最关键的一点是,它肯定做不到超过它训练时的上下文长度。如果它是在十万上训的,那实际上你的可用上下文窗口大概只有五万。一旦超过五万,就不再提升了,反而变差,因为模型没法对所有内容都做注意力。
你刚提了个特别好的例子,我之前没细想:如果我能做 RAG,或者把东西加载进活动记忆,随时按需把相似例子拉进来,这很像 agent、很像持续演进的 harness 的思路。那就像我要考试,或者开卷考试,有本教材给我查,我肯定考得更好。这肯定管用,而且我猜扩展性也好得多。
剩下两种范式就是 LoRA——一秩两秩随便,或者十秩、一百秩的 LoRA,再往上就是全量 SFT 和 RL。如果你是特斯拉,数据无限多,你做自动驾驶却用 ICL,你在干嘛?开什么玩笑,显然不会那么干。Figure 那种公司也一样。但有意思的是,在低数据量的场景下,ICL 能做得非常好。更酷的是,我们可以把 ICL 压缩进工具调用、压缩成工具,或者说压缩成学到的东西。就是这样一套层级,我们还没真正搞明白,而你们可能正站在最前面。
主持人:对,你们要不要展开讲讲?我猜这是你们做 Waddle 的核心思路之一。
Vincent:这里有几件事挺值得拆开讲。第一,我们一直把 harness 看成一种领域专精化的形式。比如你把机器人部署到一个新环境,可能是在湿实验室里,它主要就是反复做取放测试。这些东西很多可以在上下文里学,但之后要把这些上下文固化给未来的 agent 用,一种办法就是把学到的每项技能打包成具体的程序。把这些技能和记忆写下来,就是一种固化,就像是从过往经验里蒸馏出来给未来的 agent 用。这挺有意思的。
Vincent:另一件有意思的事是,这好像跟机器学习史上更广义的元学习文献有点关系。就是有一个更大的模型,去编程一个更小的模型来做事情。很有意思的一点是,对,这些小模型会在上下文里学习,它们被包在 harness 里面执行任务。只要大模型能把 harness 的领域专精化做得好,你就可以把模型做小、让它跑得更快。这是我们现在很感兴趣的方向。
最后一点,我觉得真正有意思的理论问题是,上下文学习到底能走多远。这个我觉得谁都说不准。有论文显示,这些模型在上下文学习时能近似做梯度下降。权重空间和符号空间之间的这条线,我觉得其实有点模糊。

现场演示拆解:工具调用、延迟与策略图
主持人:好,回到视频。我们现在看的到底是什么?
Jay:我们在看 Astra 控制机械臂,把桌上的方块拿起来放进碗里。
主持人:所以这里 Astra 只用摄像头输入,而且它大概知道自己控制的是哪台机器人,然后会写出控制机器人各个关节的代码。
Jay:对,它确实会看所有摄像头,所有画面它都能拿到。不过与其说是代码,更像是一次工具调用。它给机器人发指令去控制,把方块放进碗里。
主持人:这个场景里我们是直接用 Astra,但如果我们用的是 Waddle 的 harness,直接拿 Astra 控制和走 Waddle 的 API,差别在哪?
Hanmei:有时候直接让 Astra 去命令机器人该到哪个位姿,并不是最优的工具。如果是重复性任务,你就不想让 Astra 待在回路里,你可能想写一段能反复跑、跑得飞快的代码。或者如果这个任务你以前做过类似的,你应该能调用一个已经编译好的技能,用这个技能更快地完成任务,也更好地处理边界情况。
主持人:这里能看到它好像在往这个东西靠近。哦,好有戏剧性。
Jay:对。你能看出来延迟有点慢,因为我们卡在 Astra 的延迟上。但你看这个趋势,这些模型的延迟在飞快地改善。我们发现 Fable 这一档大模型的延迟大概每个月提升一倍,非常非常快。如果这个趋势继续,今年年底我们就能做到实时控制。
主持人:我们刚看了这个任务从头跑到尾,那不如顺着走一遍这里面到底发生了什么。这里有一个 coding agent 在闭环里跑,它大概会走哪些步骤?我们再对比一下直接用 coding agent 的版本,和把 Waddle 的工具外壳放进闭环的版本。
Jay:刚才发生的是,经过一连串轮次,Astra 从摄像头收到图像,然后输出机器人要去的末端执行器位姿。它要经过多个轮次才把任务做完。
Vincent:这不太算代码即策略,更像是工具调用。那些不起眼的部分其实很重复,所以很多都能用代码自动化。接近瓶子、把瓶子拿起来,这些事你做几遍之后就相当确定了。有意思的地方在于,你把这些变化点写进代码,做成一个策略图。这里有几个变化点,比如检测物体的时候,你可能会调一个 VLM 当工具。或者某一步失败的时候,你怎么判断它失败了?失败了又该怎么换别的做法?这类响应更灵活。我们习惯把一个 VLM 放进闭环里,这样虽然这个代码图本身是确定的,但那些变化点能让它泛化。
从程序合成到普拉托表征假说
François:我自己在机器学习该怎么做、以及AGI剩下的路该怎么走这件事上,最大的领悟或者说世界观的转变,来自我和François Chollet的很多次对话。2020年,甚至可能2018年,他写那篇论智能的度量的时候,就讲了很多直推式映射和程序归纳的区别。
直推式映射的意思就是,我学一个函数theta,把x映射到y。为什么这不对?因为它慢,而且信息效率低。要从x到y,我需要大量的x和y配对。如果配对很少,你就需要很强的归纳偏置。你真正需要的是一个好的生成器,能从x和y映射出那个函数。这时候我的theta输入几对x和y,输出的是把x映射到y的那个函数。对,这就是代码。所以就像给你一道编程面试题,哪怕在白板上,你说行,这是题目,这是几个例子,好,写个函数出来。然后我们输出的那个f,就是把x映射到y。
Vincent:这一点很有意思,因为我觉得这其实就是传统程序合成那一支文献做的东西。我感觉那些方法效果不太好,很大一部分原因就是你说的归纳偏置。你把问题的难点从找那个映射,转移到了找合适的归纳偏置,好把它映射成一小段代码再去做映射。但找出那套归纳偏置超级难。也许这正是Astra帮我们买来的东西。就连认知科学那边的文献也在大转向,从那种专门的神经符号方法,转到直接让Astra写代码来做映射。所以这也许是个很好的思考角度,它就是神经符号。这就是神经符号。
François:我们这边是神经元,然后它们吐出符号,也就是代码。
主持人:我觉得这里正好能接到最后一个话题,灵感也来自Phillip Isola的一篇论文,他起名叫普拉托表征假说。普拉托是引柏拉图的洞穴,你看到的是各种现实的影子。他在这里想说的是,已经有大量证据表明,语言模型和各种不同的数据表征,在不同的训练方式下其实学到了重叠的、类似事物之间的距离映射。也就是说,当你用越来越大的数据去训练这些系统,它们会收敛到一种对世界的一致映射。这也许意味着,语言模型在越来越擅长那些能用在像机器人控制这种新任务上的东西。我猜这个表征假说其实在你们几位和你们公司的世界观里是很核心的。不如你们讲讲自己怎么看?也可以顺便猜猜,为什么Astra这类模型在机器人控制上比之前的模型好那么多,再预测一下我们接下来会走到哪儿。
Jay:要把机器人模型和语言模型之争讲得具体一点,可以说,非常非常强的语言模型,对世界的表征会和非常强的机器人模型非常接近。如果是这样,那按普拉托表征假说,你有一个特别强的语言模型,你也就有了一个特别强的机器人模型。如果这是真的,那就是苦涩的教训最好的体现。因为你只需要一个特别强的模型,不管什么架构,它都会胜过那些稍微弱一点的专用模型。
computer use数据为什么能教会机器人物理世界
主持人:有件事不太符合直觉,我也想听听你们怎么看:为什么这些最新的模型,尤其是 Astra,在空间智能上好像强了这么多?我们都在网上看过它控制 Blender、做出很棒的 3D 图像的演示。刚才你还给 Jay 看了一个基准,它在某些任务上是明显的阶跃式提升。
你们觉得,在预训练和后训练上,OpenAI 的做法可能变了什么,让它们比半年前的模型强这么多?半年前的模型我们还在吃它们的红利,写代码仍然极强,数学题也照样解,但就是还没攻下这里所需要的空间智能。
Hanmei:我觉得 Astra 特别强的地方是视觉能力。它预训练时用的 computer use 数据可能比以往任何时候都多得多,也已经用了大量 CAD 数据做预训练。这些数据大概都让模型学到了和大量机器人数据相似的对物理世界的理解。
主持人:computer use 数据这点很有意思,因为它并不完全符合直觉。为什么 computer use 数据有助于理解物理世界?它一般就是在电脑上点来点去。你再多讲讲,为什么你觉得这是个大的突破点。我完全相信他们用了比以前多得多的 computer use 数据。
Hanmei:对。我觉得如果只是拿 computer use 去训一个模型,那它没法用到机器人上。但如果你把 computer use 数据喂给 Astra 这种大模型——我说的 computer use 数据,比如你在屏幕上拖光标,让 Blender 里某个物体转起来,好做设计——这就告诉你该怎么推理空间,至少告诉你上下左右这些概念,而这些正是控制机器人需要的。
所以我觉得这就是为什么这些数据能让大语言模型在使用机器人上强这么多。反过来,机器人圈里很多人也在试越来越多的数据类型,比如第一视角视频,从只用遥操作数据扩展到更大范围的数据,因为能教模型用机器人的不只是机器人数据。如果推到极致,那就是为什么不把各种数据——代码、computer use、第一视角视频——全喂给同一个模型?我觉得这样才能做出最强的使用机器人的智能体。
François:我觉得特别好笑的是,你回到八十年代的 Xerox PARC,我们当初做图形界面,就是让它更像物理世界,好让我们能跟它交互。结果我们造出来的这个环境,反而正好能帮机器人学习怎么使用物理世界。我们有文件系统,有文件,有文件夹,有 SolidWorks 和 Autodesk 的界面,让你转着看东西,做得跟物理世界很像。后来我们搞不定物理世界里的机器人,就干脆拿这些去训练,现在它在物理世界里就能跑了。
Hanmei:对,就是这样。有些很棒的论文,我记得有 Princeton 的,还有基于 Claude 做机器人的那篇也提到这一点:如果你设计一个合适的工具外壳,让跟机器人打交道的工具看起来像 computer use 的工具,比如让 agent 拖着光标来控制机器人往哪走,那大语言模型在这些物理任务上的表现就会更好。

通用机器人还有两年:延迟、睡眠与压缩
主持人:接下来想听听你们的判断。合理猜一下基础模型会怎么继续变强,再算上你们自己在评估这些模型、给它们搭工具外壳上的投入,你们觉得哪些能力现在看着还挺难,但过不了多久,也许几个月之后就会变得可行,甚至很轻松?像半年前,你们在 Twitter 上发的那几个演示,我当时觉得要让 LLM 做出来简直不可想象。
Jay:前沿实验室,还有搞机器人基础模型的那批公司,内部已经有共识:未来两年内,甚至更早,我们就会有通用机器人。这件事社会大概还没意识到,更谈不上做好准备。
所谓通用机器人,就是你随便给一句自然语言指令,它能做到一个手脚麻利的十几岁孩子空手能做到的事。能力上有点像机器人版的 ChatGPT 时刻,能泛化到没见过的任务和没见过的环境。
主持人:那对你们几位、对 Waddle Labs 的人来说,这意味着你们要建的是什么?
Hanmei:我觉得我们会一步步走,大概两年内到位。眼下能看到的挑战太多了。比如我特别喜欢在网上聊延迟,这是个大问题。如果你让 Astra 一直在回路里,每一步都要思考,那太慢了,经济上根本不成立。所以你怎么把 Astra 的第一遍求解,也就是这种上下文学习,固化成一个更快的技能或者策略,之后能以极高的吞吐反复跑起来?
François:我觉得人和机器的这种对应会越来越像这样:最优做法也许就是把新的状态、动作、奖励放回上下文里,这很快。但接下来得有类似睡觉的阶段。几乎所有有智能的东西都睡觉,你给我找一个完全不睡觉的智能系统试试。而在睡眠中会发生压缩,海马体里那种奇怪的过程,锐波涟漪传到两侧脑叶,白天被压缩过的记忆会经过一些奇怪的通道去训练权重。
类似地,也许正确做法就像经典强化学习里的 DAgger,数据集聚合框架:你不断收集数据,然后回头反思,用它去更新权重文件,再从这些经验里蒸馏回一个新的权重文件,那个文件可能不是 Astra,而是你自己的模型。
Vincent:听起来很像 DreamCoder。不过人们当年造的那些具体东西,比如 DreamCoder,它有一个技能库,然后在睡眠阶段基本上把所有东西重构得更紧凑。我们现在看到的是类似的事,只是不像以前在程序空间里那么刻板。现在也许你要重构的是轨迹,是技能。很多机器人代码即策略的论文都有这样一个不断长大的技能库,至于怎么把它们打印出来、怎么组织,谁都说不准。所以我觉得随着 Waddle 往前走,怎么管理我们不断增长的技能上下文和部署数据,都会很有意思。
主持人:那今天就聊到这里,我觉得这场讨论非常精彩。非常感谢 Vincent、Hanmei 和 Jay 来到这里。想到未来几年会看到的那些机器人进展,我非常兴奋。Jay,你说得完全对,我觉得大众并不清楚接下来会有多大的变化。未来几年会非常精彩。谢谢大家。
原视频:Robot-Use Agents: Why General-Purpose Models May Win in Robotics
https://www.youtube.com/watch?v=Jv5B5CEaPJI
编译:磊哥Thomas