


导读本文整理自寇宏达在 Agentic AI Summit-2026-深圳站上的分享。阿里巴巴淘天集团 1688 围绕垂直业务 Agent 的自动化评测进行了实践。本文重点介绍评测边界、离线与线上双轨评测、Rubric 与 Judge 工程、评测系统自检,以及如何把评测结果接入问题修复、回归和准出闭环。
主要内容包括以下几个部分:
1. Agent 评测不能只看答案:从真实任务到双轨评测体系
2. 评测系统也会“犯错”:让 Judge 从自动判分走向持续提准
3. 从“能跑”到“可信”:让评测真正进入 Agent 迭代闭环
Agent 评测不能只看答案:从真实任务到双轨评测体系
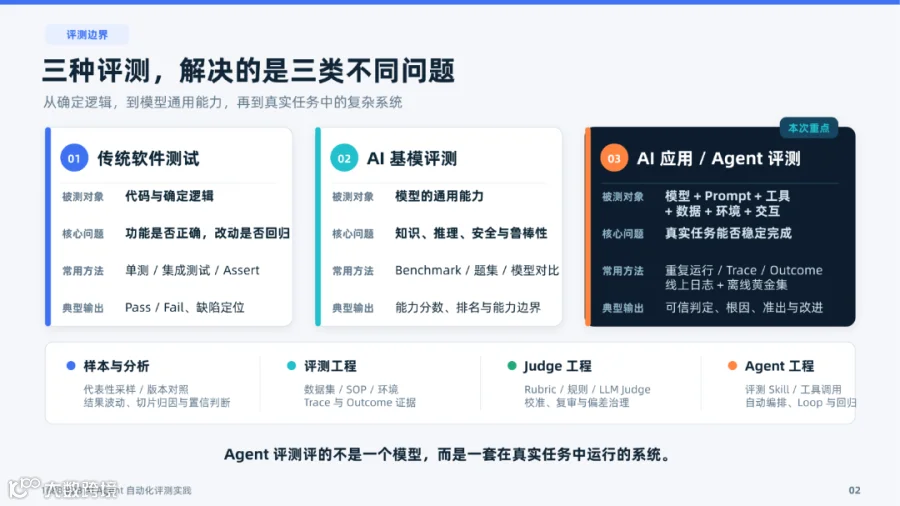
传统软件测试、AI 基模评测和 AI 应用/Agent 评测解决的不是同一类问题。传统测试面对代码与确定逻辑;基模评测关注模型的知识、推理、安全与鲁棒性;业务 Agent 的评测对象则是模型、Prompt、工具、数据、环境和交互共同组成的系统,要回答任务是否稳定完成、根因在哪里、版本能不能准出。工程上需要样本与分析、评测工程、Judge 工程和 Agent 工程共同参与。
真实场景:一条电商任务,可能在 6 个地方“看起来成功”
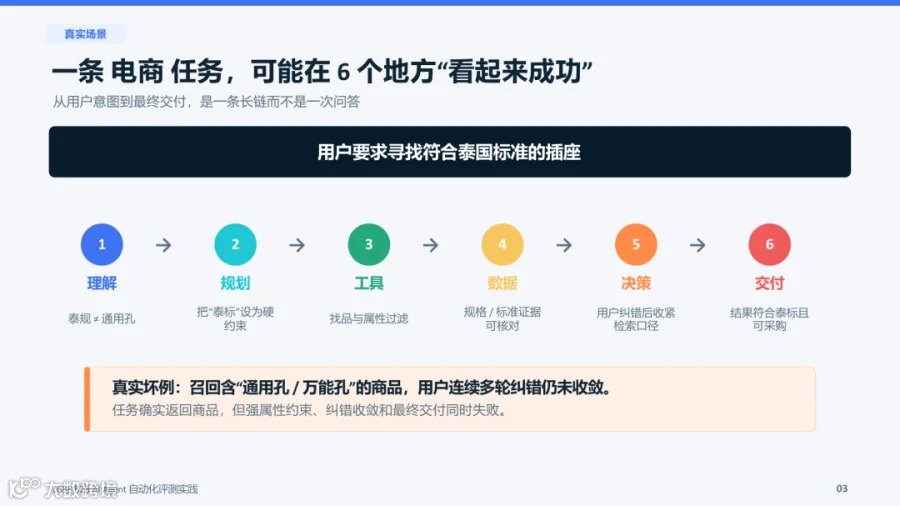
一个真实的 B2B 电商任务是:用户要求在 1688 找到符合泰国标准的插座。任务从意图到交付要经过理解、规划、工具、数据、决策、交付六个环节。Agent 要理解“泰规≠通用孔”,把泰标设成硬约束,在找品和属性过滤中真正执行,并核对规格证据、根据用户纠错收紧口径。坏例里,系统虽然返回了商品,却仍混入“通用孔/万能孔”,多轮纠错也没有收敛。

因此,Agent 评测不能只看最终答案。我们把真实任务拆成Task × Trial × Trace × Outcome:Task 写清输入、约束和成功标准;Trial 对同一 Query 重复执行,既看 pass@k 是否至少成功一次,也看 pass^k 是否多次稳定;Trace 保留对话、工具调用和中间状态;Outcome 核验真实环境中的终态和交付物。确定性事实和硬门槛交给规则、代码,语义意图和证据理解交给 LLM Judge,异常再进入评测自检。
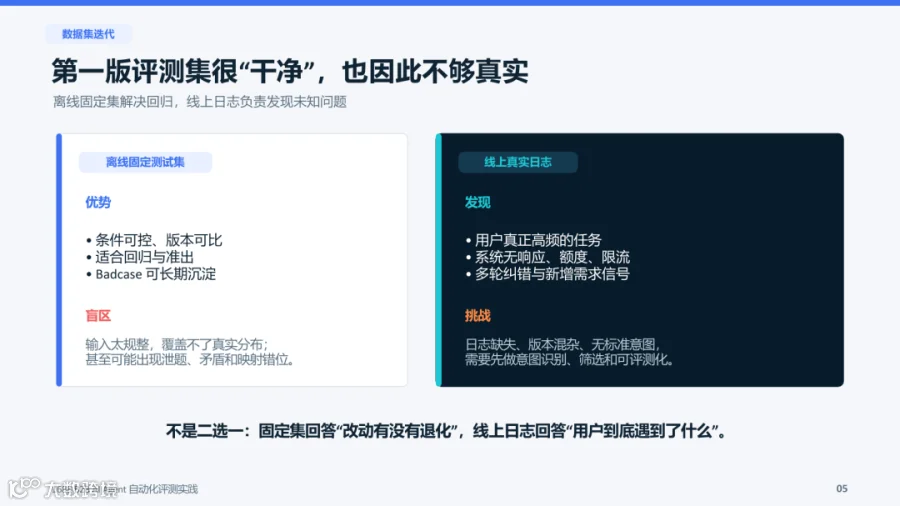
第一版离线评测集通常由业务专家构造,条件可控、版本可比,适合回归和准出,也方便沉淀 Badcase;问题是输入太规整,未必覆盖真实分布,还可能出现泄题、矛盾和映射错位。线上日志能暴露高频任务、系统无响应、额度或限流、多轮纠错和新增需求,但也有日志缺失、版本混杂、缺少标准意图等问题,需要先做意图识别、筛选和可评测化。两类数据不是二选一:固定集回答“改动有没有退化”,线上日志回答“用户到底遇到了什么”。
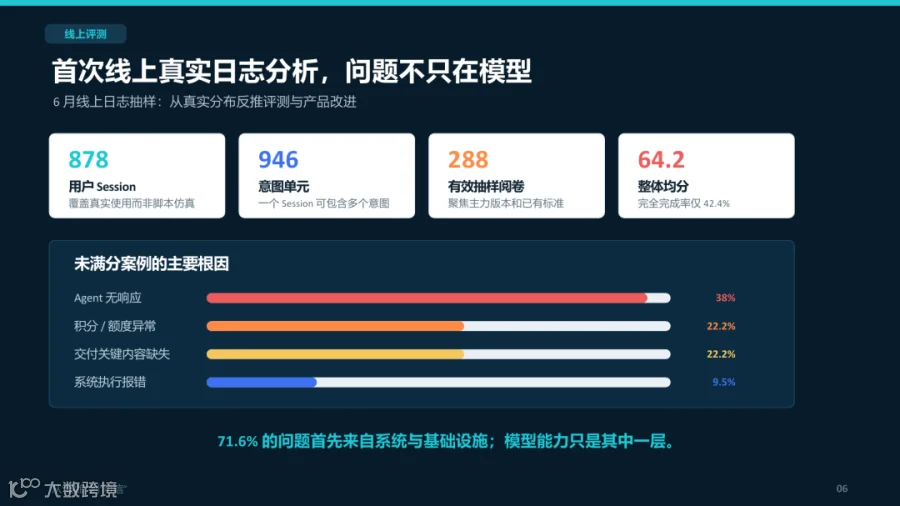
6 月的一次线上日志抽样包含878 个用户 Session、946 个意图单元和 288 个有效抽样阅卷,整体均分 64.2,完全完成率只有 42.4%。未满分案例中,Agent 无响应占 38%,积分/额度异常和交付关键内容缺失各占 22.2%,系统执行报错占 9.5%。按这组切片统计,71.6% 的问题首先来自系统与基础设施,模型能力只是其中一层。
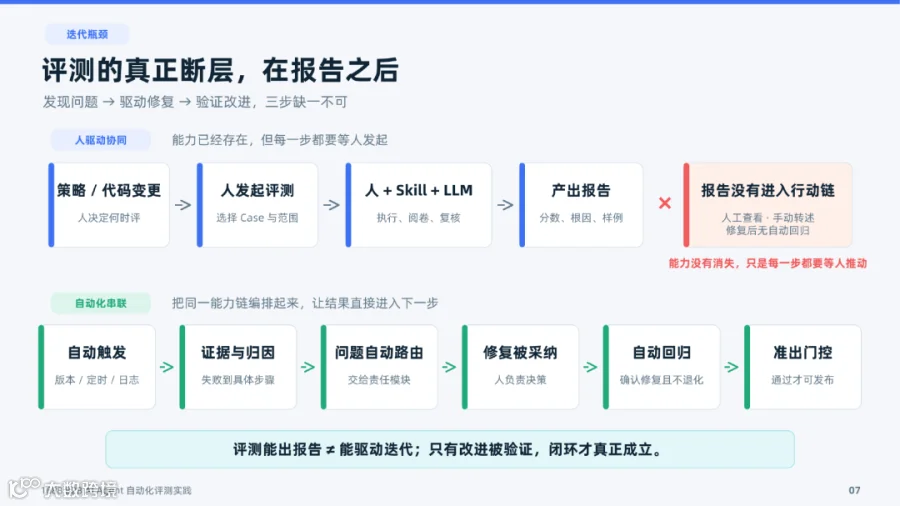
评测真正的断层往往在报告之后。早期流程中,业务版本发布后由人发起评测、串执行链路,再由 AI 产出报告,最后仍要人工校准和发布;报告并没有自动进入修复动作。最近的改造重点,是把版本或定时日志触发、证据归因、问题路由、修复采纳、自动回归和准出门控串起来。

全景架构里,离线黄金集和线上真实日志是两种入口,但后续共享同一套 Task、Trace、Rubric、Judge、归因标签和报告契约。标准 SOP 从构建任务、环境执行、收集证据、混合判定,到归因改进、回归准出。工程上始终绕不开四个关口:标准可执行、证据可验证、Judge 可信、闭环不退化。
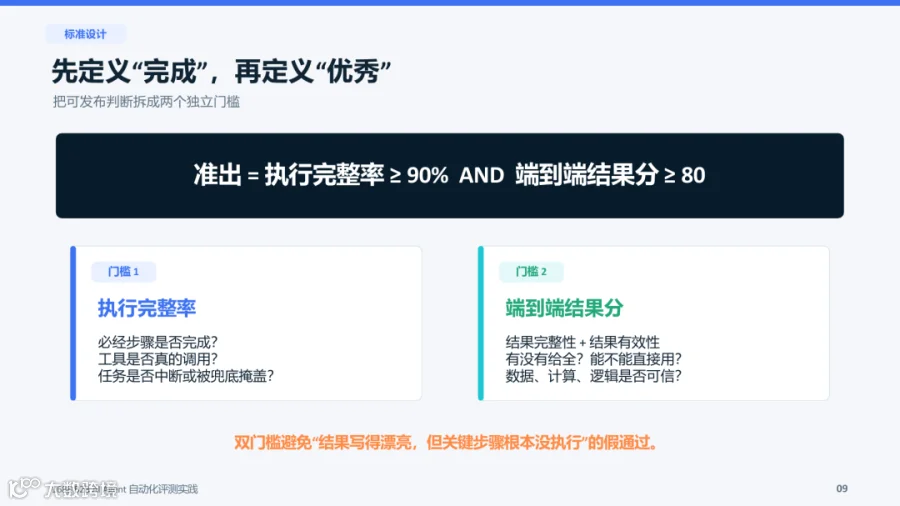
我们先把“完成”和“优秀”拆开。对垂直电商任务,准出采用两个独立门槛:执行完整率 ≥ 90%,同时端到端结果分 ≥ 80。前者检查必经步骤、关键工具和任务中断;后者检查交付是否齐全、能否直接使用,以及数据、计算和逻辑是否可信。这样可以挡住“结果写得漂亮,但关键步骤根本没执行”的假通过。
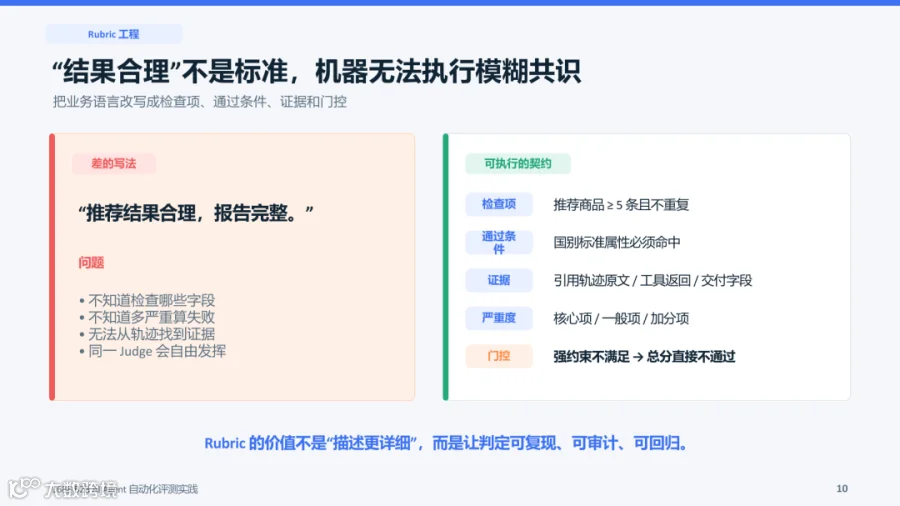
Rubric 的难点不是写得更长,而是把业务共识改造成机器能执行的契约。“推荐结果合理,报告完整”没有检查字段、失败边界和证据要求,同一个 Judge 很容易自由发挥。可执行的 Rubric 要明确检查项、通过条件、证据来源、严重度和门控,例如推荐商品数量、国别标准属性、轨迹原文或工具返回,以及强约束不满足时直接判不通过。
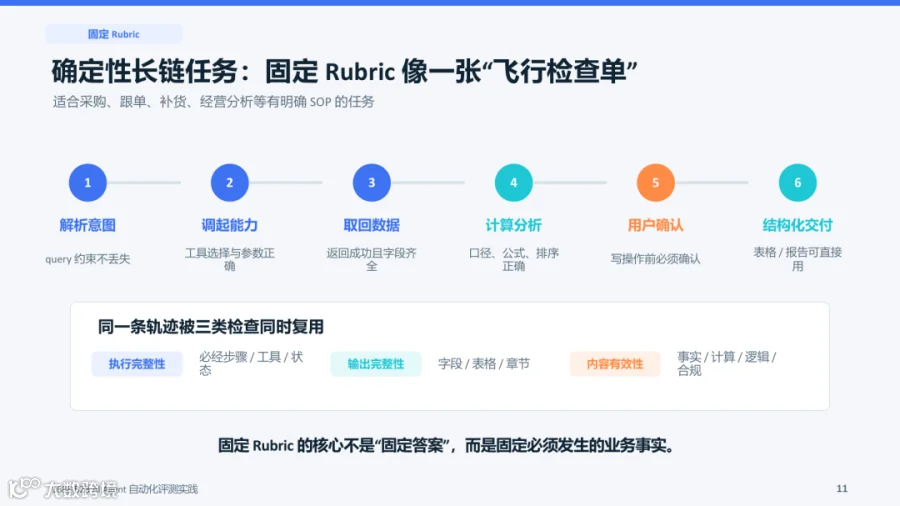
确定性长链任务适合固定 Rubric。采购、跟单、补货、经营分析都有明确 SOP,可以像“飞行检查单”一样检查解析意图、调起能力、取回数据、计算分析、用户确认和结构化交付。同一条 Trace 同时复用到执行完整性、输出完整性和内容有效性三类检查。固定的不是答案,而是必须发生的业务事实。
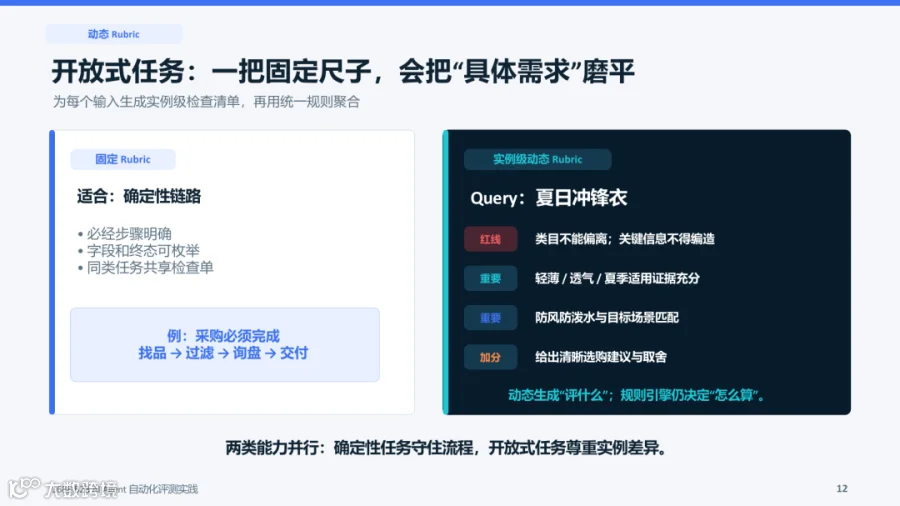
开放式任务需要实例级动态 Rubric。以“夏日冲锋衣”为例,类目偏离和关键信息编造属于红线;轻薄、透气、夏季适用,以及防风防泼水与目标场景的匹配属于重要项;清晰的选购建议和取舍可以作为加分项。动态 Rubric 按输入生成“评什么”,最终“怎么算”仍由统一规则聚合。

多模态任务更容易被平均分掩盖关键失败。一张服装图的9 个判项答对 7 个,整体准确率 77.8%,对象计数、对象识别/动作、场景主旨都可能满分,但对象位置仍然可以是 0/1。若位置关系是关键能力,就必须单独门控,不能让其他正确项把这个失败平均掉。
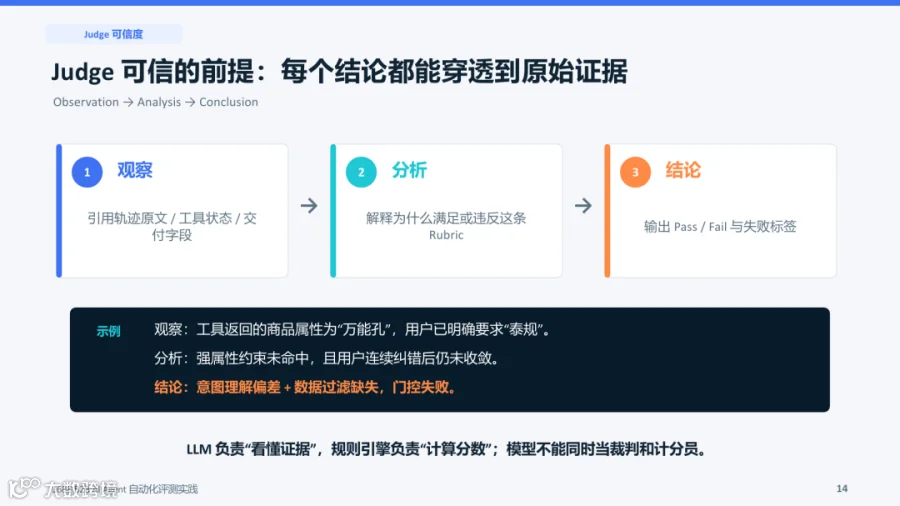
Judge 可信的前提,是每个结论都能穿透到原始证据。输出结构是 Observation → Analysis → Conclusion:先引用轨迹原文、工具状态或交付字段,再解释为什么满足或违反某条 Rubric,最后输出 Pass/Fail 和失败标签。LLM 负责“看懂证据”,规则引擎负责“计算分数”,不能让模型同时当裁判和计分员。
评测系统也会“犯错”:让 Judge 从自动判分走向持续提准
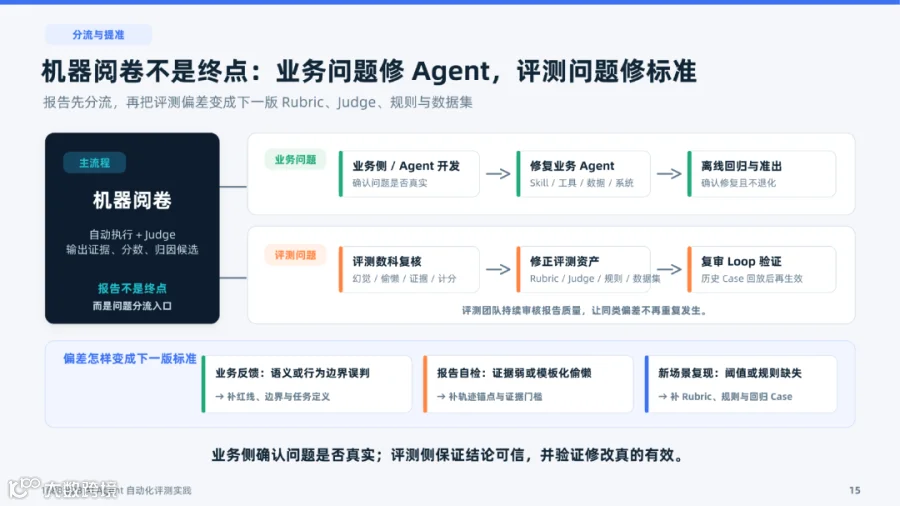
机器阅卷不是终点。业务侧确认真实问题后,去修 Agent 的 Skill、工具、数据或系统;如果业务侧认为是评测误判,则回到 Rubric、Judge、规则和数据集复审,再回放历史 Case。业务反馈会补充语义和行为边界,弱证据、模板化判断会转成新的证据门槛,新场景则补充 Rubric 和回归 Case。业务问题修 Agent,评测问题修标准。

我们曾扫描900 条 Verdict 记录,对应 260 个文件、10,026 个判项:56.7% 的 Fail 存在证据弱问题,46.4% 的 Pass 有走过场现象,4.7% 的同 Case 分差达到 30 分以上,1.7% 出现分数与扣分不一致。根因也不只是模型强弱:单次 Prompt 判太多项会造成注意力衰减,证据格式太宽松会放过弱锚点,模型同时判定和算分又缺少确定性兜底。

因此我们把一部分“纪律”写进运行时,而不是继续往 Prompt 里堆规则。七道确定性闸门分别处理证据强度、反证原则、模板化检测、过度跳过、分数重算、方差裁决和数值对账;输入侧做微批次与顺序随机化,输出侧强制证据三段论和单项重试。能用规则或 Python 对账解决的,不再问一次大模型。
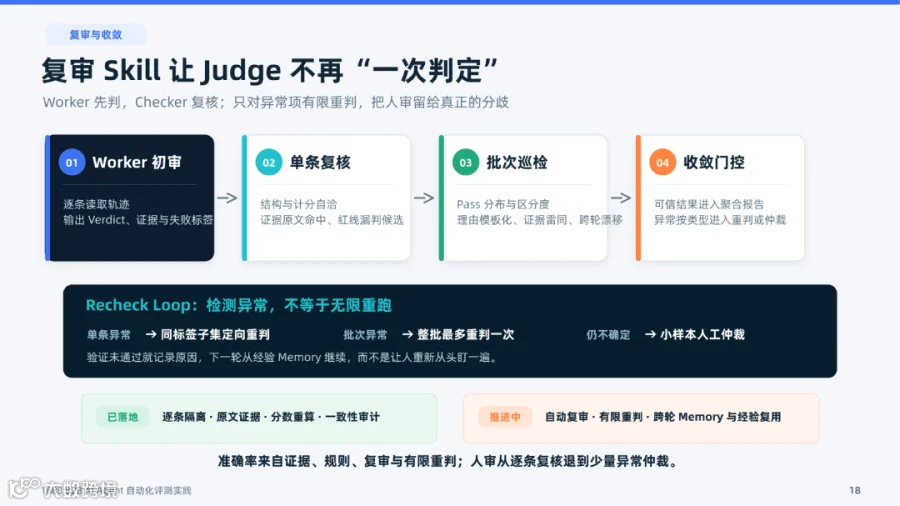
复审也不是把所有结果无限重跑。流程从 Worker 初审开始,再做单条复核、批次巡检和收敛门控。单条异常只对同标签子集定向重判;批次异常整批最多重判一次;仍不能确定的 Case 再交给小样本人工仲裁。已经落地的重点包括逐条隔离、原文证据、分数重算和一致性审计,自动复审、有限重判以及跨轮 Memory 与经验复用仍在推进。

离线评测和线上日志评测最终形成两个入口。离线样本由版本化黄金集和历史 Badcase 组成,通过重复运行、版本对照和关键切片归因守住上线准出;线上日志负责发现真实分布、异常链路、高频需求和未知问题。线上问题经过脱敏和分层后回流离线黄金集,修复后重新回归,再继续上线观测。两边必须共享 Task、Rubric、Judge、归因标签和报告契约。
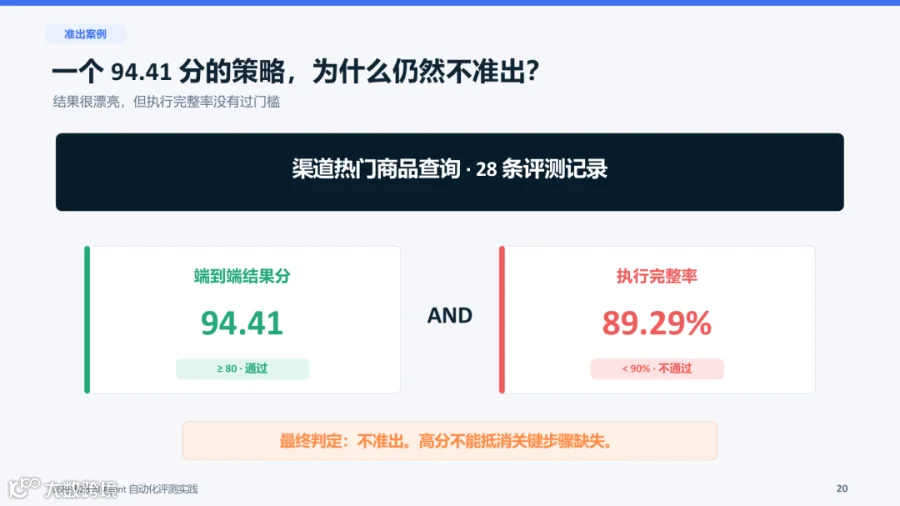
双门槛在实际 Case 中会显得很“反直觉”。一个渠道热门商品查询策略,端到端结果分是 94.41,超过 80;但执行完整率只有 89.29%,没有达到 90%,最终仍然不准出。对 B2B 长链任务来说,高分不能抵消关键步骤缺失。
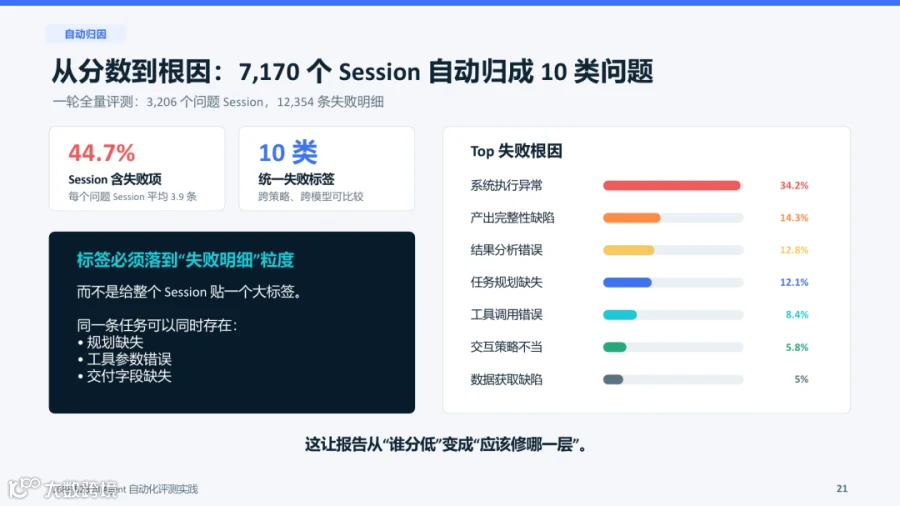
只有分数还不够,下一步必须落到根因。一轮全量评测覆盖7,170 个 Session,其中 3,206 个问题 Session、12,354 条失败明细,44.7% 的 Session 含失败项。失败被归为10 类,主要包括系统执行异常、产出完整性缺陷、结果分析错误、任务规划缺失、工具调用错误、交互策略不当和数据获取缺陷。标签必须落到“失败明细”粒度,同一个 Session 可以同时存在多类问题。
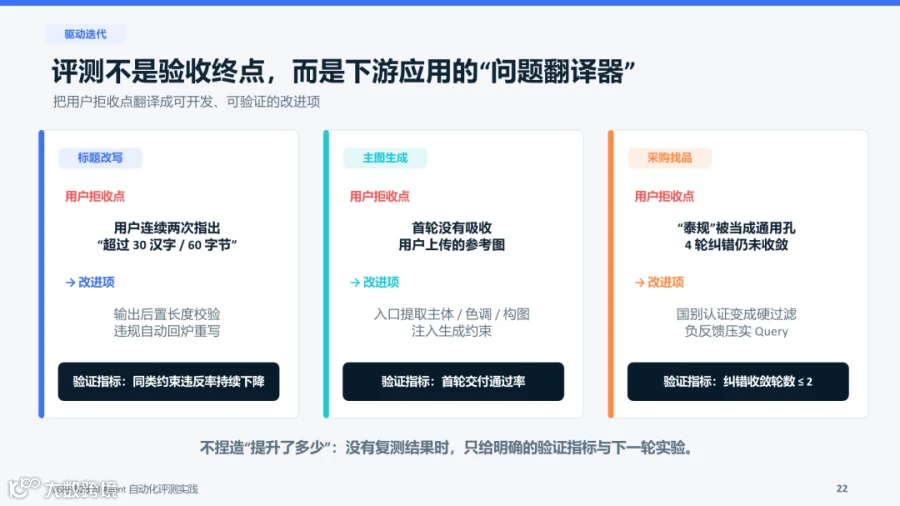
评测因此更像下游应用的“问题翻译器”。标题改写超出“30 汉字/60 字节”,改进项就落到输出后置长度校验和违规自动回炉;主图生成首轮没有吸收参考图,就在入口提取主体、色调和构图并注入约束;采购找品把“泰规”当成通用孔、四轮纠错仍未收敛,就把国别认证变成硬过滤,并用负反馈收紧 Query。没有复测结果时,不先写“提升了多少”,而是给出验证指标和下一轮实验。
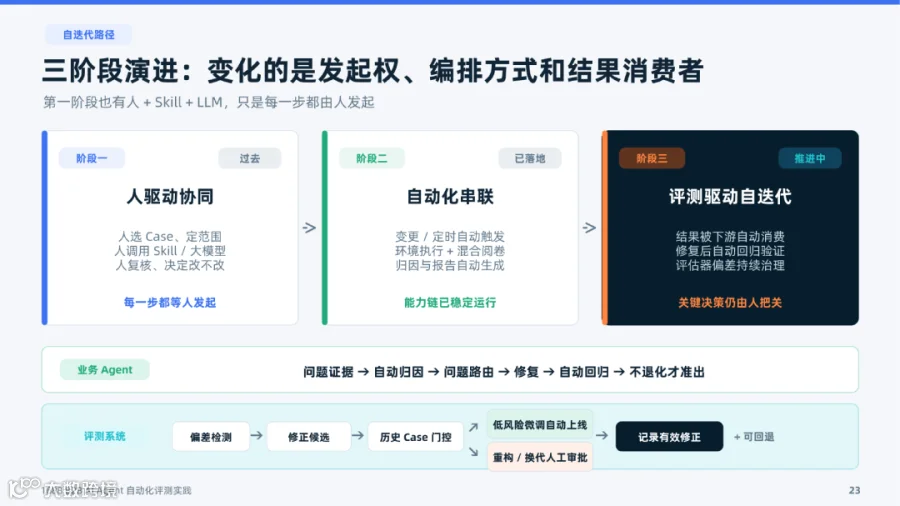
整个体系经历了三个阶段:阶段一是人驱动协同,人选 Case、调用能力、复核并决定是否改;阶段二是自动化串联,版本变化或定时任务自动触发环境执行、阅卷、归因和报告;阶段三正在推进评测驱动自迭代,让结果被下游自动消费,修复后自动回归,并持续治理评测器自身偏差。变化的是发起权、编排方式和结果消费者。

常见坑大多不在“选哪个 Judge 模型”:只看最终答案;标准是模糊共识,没有阈值、证据和门控;评测集过度干净或自身污染;让 Judge 自己算分;一次判太多项造成位置衰减和模板化偷懒;自动报告只追求快而没有复检;只给总分却没有归因。真要先做三件事,就是把“完成”定义清楚、强制证据、离线和线上同时评。
从“能跑”到“可信”:让评测真正进入 Agent 迭代闭环

最后可以归成三个结论。第一,评测对象不是答案,而是意图、轨迹、交付和行为边界。第二,Judge 不是终点,它必须被证据、规则闸门和复审 Loop 约束。第三,分数不是价值,能归因、能回流、能验证修复,评测才真正进入业务闭环。评测系统自己,也需要被评测。
以上就是本次分享的内容,谢谢大家。
分享嘉宾
INTRODUCTION
寇宏达
淘天集团
1688-AI评测负责人
淘天集团-1688-AI评测负责人,深耕电商与产业互联网数据科学与分析十多年,专注 AI 重构业务数据工作流&数据agent建设,主导品类经营 AI Agent 体系与 1688 AI 应用评测平台从0到1落地。熟悉B2B、近场电商、金融风险业务,完整经历了数据从"分析洞察"到"驱动决策"再到"AI自动化执行"的能力跃迁。始终坚信数据的价值不止于报表,更在于重构业务流程、让决策自动发生。
往期推荐
Data Agent多维归因分析与Skill化改造
Jev爆火背后:Agent为什么开始需要独立的Decision Layer?
本体落地不难,首批中国企业已跑通,金融、电商、制造全覆盖
Harness Agent 在实际业务中的落地现状和未来发展
98.5% 自动审核、0.003% 欺诈率:金融 Agent 的真实水位
从 BI 到 Agentic BI:让数据应用从展示走向受控行动
智能体架构与实践:构建下一代推荐与搜索系统
Agent 评测没有统一标准——美团、高德、科锐国际各走各路,该学谁?
语义+本体+Harness的Data Agent架构探索!
腾讯金融合规 Agent 实战:32B 小模型、Skill 化规则与双轨自进化

点个在看你最好看
SPRING HAS ARRIVED
