


最近我在做一条三分钟的视频:用沃尔玛运营里的竞品分析任务,聊聊 WorkBuddy 和 ChatGPT 怎么选,后半段再把数字人口播的制作过程拆给大家看。
有人问我:“AI 做视频,是不是输入一句话就能出片?”我把这次做过的步骤摊开说。这里面有 AI 帮忙的地方,也有我必须自己看、自己改的地方。
先定题:视频只回答一个问题
这次的题目是“做跨境电商运营,WorkBuddy 和 ChatGPT 怎么选”。如果只是把两款工具的功能各念一遍,观众很难带走什么。我把问题落到沃尔玛卖家熟悉的动作上:拿同一份竞品表,让工具提炼卖点、检查数据、起草英文商品文案,最后由人核对结果。
我让 AI 帮我收集资料、整理提纲,但结论不能替观众先下。视频里说的是选择思路:看准确率、所需权限和成本;它不是一次“谁全面胜出”的性能排名。
再写稿:先念一遍,听哪里别扭
我把三分钟拆成几段:开场问题、两款工具的工作入口、沃尔玛运营例子、数字人口播怎么做、结尾提问。每句话尽量只讲一个意思。书面上看着完整的长句,念出来经常会卡,所以稿子定下来前,我会把它读一遍,再删掉那些“看起来高级、说出来费劲”的词。
稿子之后是分镜。哪一句出人物,哪一句放截图,哪一句要做对比卡片,都先写清楚。画面有任务:帮观众看懂这句话。

人物和声音:先做五秒试片
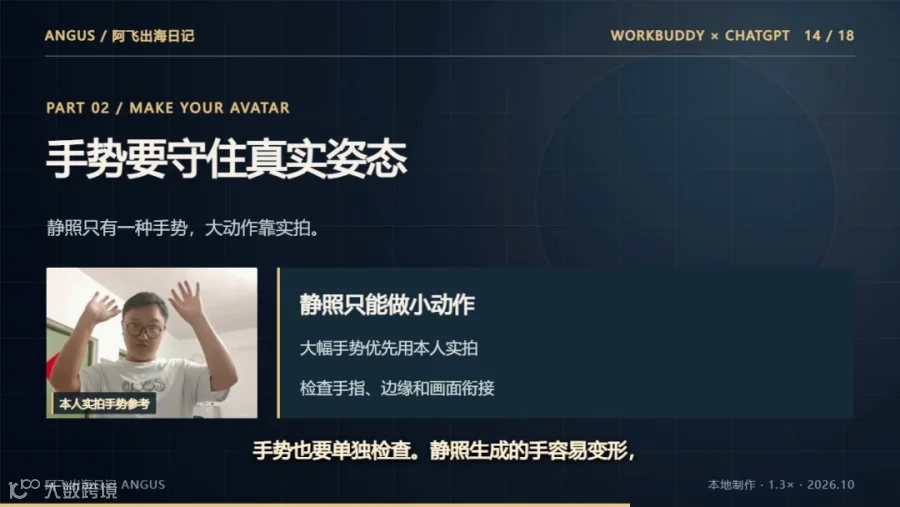
我用的是自己的照片、视频和声音样本。片头取本人视频画面,在本地做了约五秒的照片口播;后面讲手势时,直接用我自己拍的挥手、抬手片段。这条片子并不是三分钟全程由数字人对嘴。
为什么先做五秒?因为照片驱动出来的嘴型、眼神和脸部边缘,短片一看就知道能不能用。静照里的手也只有一种姿势,大动作容易变形;想要自然手势,实拍更稳。这次我没有把本人的照片和录音上传到第三方数字人网站。
本地试片的人声用 F5-TTS 根据参考音生成,照片嘴型用 SadTalker 驱动。声音模型有一件事必须单独说:这版试片使用的 F5-TTS 预训练权重是非商业许可。正式商业发布前,我会换成本人完整录制的口播,或核对清楚可商用的声音方案。
剪辑:把每一层放到该出现的时间
我用 HyperFrames 把人物、实拍片段、图文卡片、字幕、口播和音乐放在一条时间线上。口播在这版样片里调到 1.3 倍速,导出前还得重新听:赶时间不能把字赶糊。字幕按句出现,音乐压在人声后面,重点词才放大。
这一段最花工夫的是修改。某句话太长,就改稿并重新对字幕;某张卡片看不清,就调整停留时间;人物动作接得生硬,就回时间线重排。工程留着可编辑,下一条视频也能沿用这个做法。
最后一遍,我主要查这些
① 工具和平台的事实有没有来源,例子是不是被我说成了实测结果;
② 字幕有没有错字、漏句,手机上看会不会太小;
③ 口型、手指和人物边缘有没有穿帮;
④ 截图里有没有客户资料或不该公开的后台信息;
⑤ 音乐、图片和声音模型的授权能不能用于正式发布。
成片之外,我还给这条视频准备了发布标题、简介、标签和竖版封面。视频发出去,观众最先看到的就是这些;文案要说准视频里真实出现了什么,不能把“五秒照片口播”写成“全程数字人讲解”。
如果你也想开始做,先找一个自己每天会遇到的问题,试着拍一条一分钟的。题目、三段口播、几张能说明问题的画面,就够做第一版了。做完再看哪里听不清、哪里看不懂,下一条会比上一条顺。