


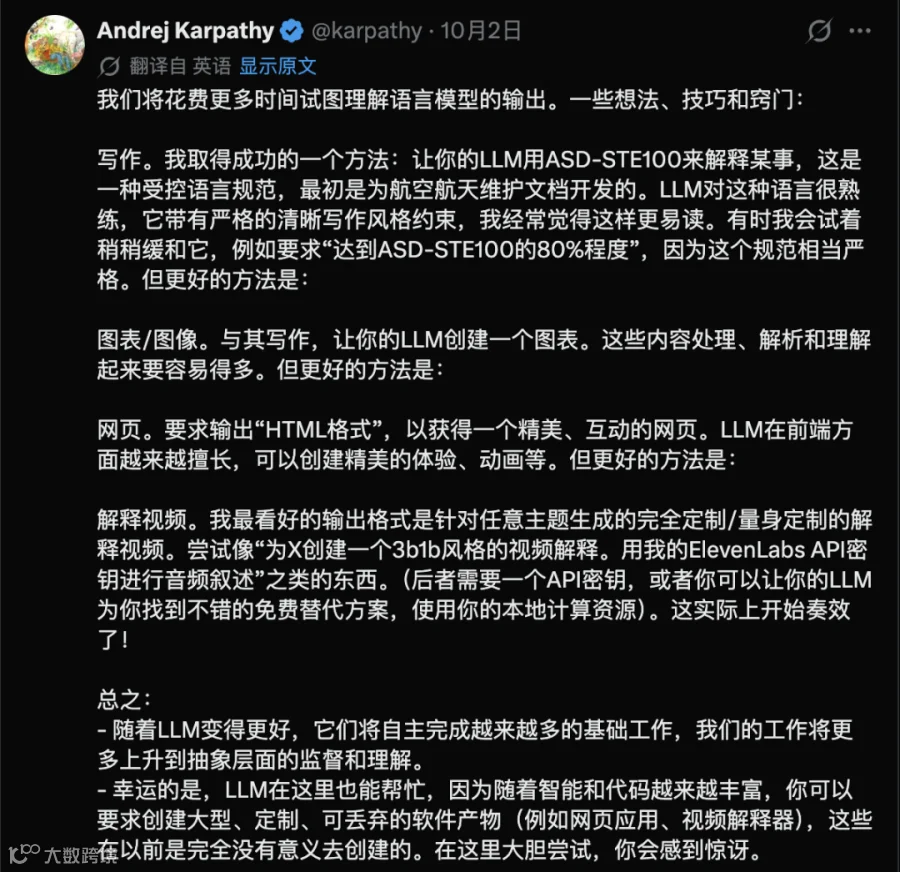
Andrej Karpathy(卡帕西)时隔两个月再次发文,指出随着大模型日益智能化,繁重的底层执行将交由AI自主完成,人类的核心工作正全面转向高维度的审查与理解。为了降低理解成本,他公开了日常使用的四套实操技巧,涵盖了从文本到视频的递进式输出方案。
大模型输出优化的四级进阶策略
第一级:写作——文本受控表达
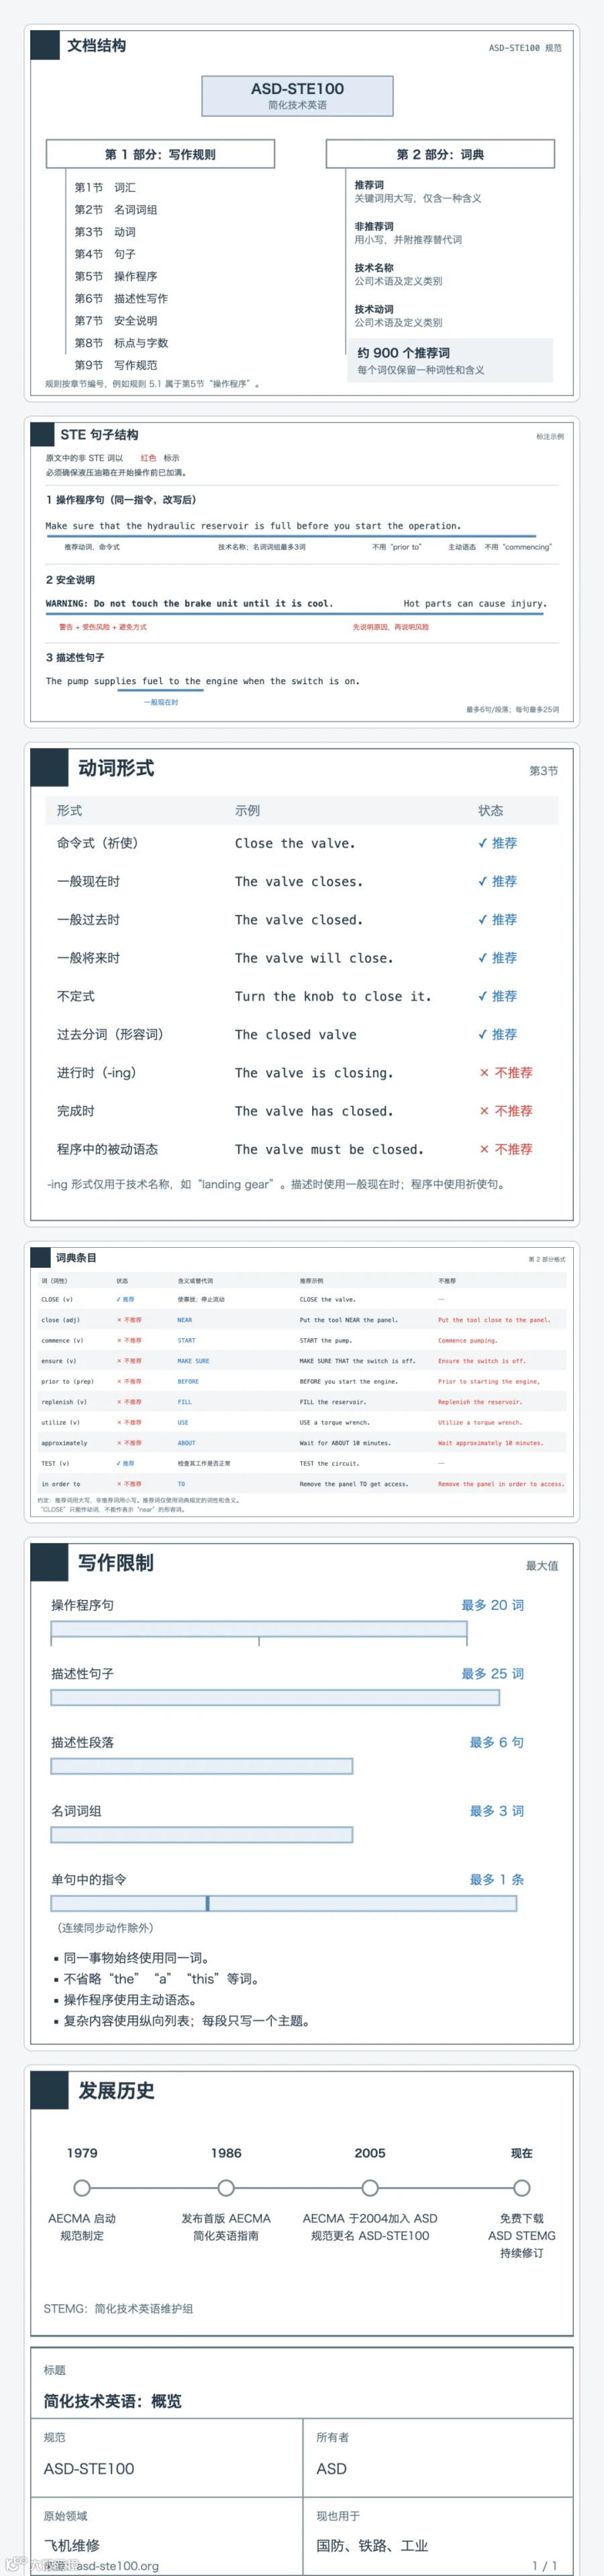
建议让大模型遵循ASD-STE100规范来解释内容。ASD-STE100原为航空维护文档使用的受控语言规范,词汇受限且规则严格。大模型在此类约束下能生成极其干净、易读的文本。若觉得原版规范过于严苛,可在提示词中要求达到80%的ASD-STE100标准。
↑ 上下滑动查看完整图片 ↑
第二级:图表化呈现
相比纯文本,图形信息在处理、解析和吸收效率上更具优势。建议直接要求大模型生成图表,以提升信息传递效率。
第三级:可交互网页
利用大模型在前端开发方面的能力,直接要求其输出HTML代码。大模型能够快速构建带有动画和交互体验的网页,这种形式在相关技术团队内部已逐渐成为默认的输出方式。
第四级:定制解说视频
这是卡帕西目前最看好的输出形态,即针对任意主题生成完全定制的解说视频。用户可以指令大模型制作类似3Blue1Brown风格的视频解说,并调用ElevenLabs等API进行语音配音。若无API密钥,也可让大模型寻找利用本地算力的免费替代方案。目前,这种全自动生成视频的方案已在实践中跑通。
未来工作模式展望
卡帕西总结认为,随着大模型持续进化,基础繁重工作将实现自动化。由于当前智能和代码获取成本极低,用户可以要求大模型随手制造庞大、定制且“用完即弃”的软件产物,如临时生成的网页应用或视频解说。这种在过去因成本高昂而不可行的做法,如今已成为现实。他建议用户继续拓展提示词的边界,以获取超出预期的结果。
结语
上述前三种输出方式,目前多数主流模型已具备良好表现。而在动态视频生成方面,纯代码生成视频的能力仍有提升空间,部分模型结合特定工具链即可实现。行业正在积极探索基于大模型的动态视频工作流,未来相关文章与实践案例值得期待。