


导读微软研究人员在 2026 年 8 月公开的一项研究中,把带注意力汇的滑动窗口注意力,与多种经过后训练的线性注意力方案放到同一基础模型上比较。结果很有吸引力:前者不用追加训练,在多数通用任务对照中仍能保留较高分数,论文的速度与显存微基准也占优。但长上下文成绩远未追上全注意力。本文按质量、训练代价和推理成本拆开看,回答工程团队该怎样使用这条基线。
本文 2217 字,阅读约 6 分钟|先把比较对象摆在同一张桌上 → 短任务 → 长上下文 → 成本优势有条件 → 真正可带走的,是一条更严格的测试顺序
先把比较对象摆在同一张桌上
如果手里已经有一个预训练的 Transformer,想让长上下文推理少占显存,可以走两条路。一条是改变现有模型在推理时能看见哪些历史 Token;另一条是改造注意力计算,再用额外数据训练,让模型适应新结构。前一条的代表是带注意力汇的滑动窗口注意力,后一条包括论文测试的多种后训练线性化方案。这里的“基线”,是复杂改造前先测的简单参照:若两者在同一任务上表现相近,就需要进一步问额外训练换来了什么。
全注意力会让当前 Token 查询此前所有 Token 的 Key 和 Value。生成越久,要保存的 KV Cache(键值缓存)越大。滑动窗口注意力(SWA)只让它看最近一段历史;论文还固定保留最开始的 4 个 Token。这些开头位置常吸收较多注意力,被称为注意力汇(attention sinks)。若它们随窗口一起被丢掉,原模型可能出现严重性能下降。论文测试的 SWA(64, 4),就是总计 64 个可见位置中保留 4 个开头位置,其余用于最近的局部窗口;这一设置不需要追加训练。
线性注意力则把不断增长的历史压进固定大小的运行时状态,让后续 Token 读取和更新该状态。把已训练好的全注意力模型改成这种结构,通常需要后训练来恢复性能。比较时还有一个细节:LoLCATs 等受测方法本身混合了线性注意力与局部滑动窗口,不能把论文读成“纯滑动窗口对所有纯线性模型”。
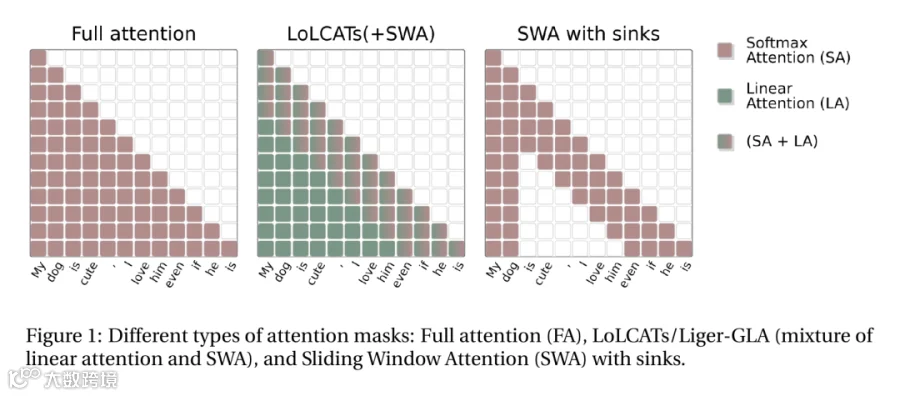 图片说明:论文图 1 从左到右对照全注意力、线性与局部窗口混合的 LoLCATs,以及保留开头位置的滑动窗口;色块表示各位置可使用的注意力形式,并非性能成绩。 图片来源:Sliding-window beats linear attention 论文
这张图也说明两条路线解决的是不同层面的问题:SWA 缩小当前 Token 能直接查询的 KV 范围;线性化则改变历史信息的表示与更新方式。两者都想控制运行时成本,但质量损失、训练投入和实现条件需要分别比较。
位置编码则负责让模型区分 Token 的位置。对使用 RoPE 的模型,调整位置编码有时能让它处理更长的位置序列,但能否准确利用远处信息仍需检验。本文讨论的论文没有通过修改位置编码扩展长度;它改变的是推理时可关注的历史范围。更省缓存,不等于模型就能用好更长的上下文。
Q、K、V 到底在算什么?把因果 Mask 放进 attention 的每一步
短任务:免训练基线确实很强
论文在 Phi、Mistral、Llama、Qwen 等基础模型上,比较 MMLU、ARC、HellaSwag 等六项通用知识与推理任务。结果是:在 11 组受测模型与线性化方案的对照中,SWA 有 9 组取得最高的非原模型平均分。按论文汇总口径,64 窗口、4 个注意力汇位置的 SWA,六项任务平均恢复了原模型 99.0% 的分数;MMLU 单项恢复比例为 93.2%。这里的“恢复”是学生分数除以原模型分数,不是 99% 或 93.2% 的答题准确率。
拿同一基础模型看更直观。Llama 3.1 8B 在六项任务上的平均分,全注意力原模型是 72.5,SWA 是 71.8,经过约 4000 万 Token 后训练的 LoLCATs 是 70.3。三者差距并不大;SWA 的优势是这一步没有额外训练。换成 MMLU,三者分别是 65.4、60.6、54.9,也能看出“平均分接近”不代表每个任务都无损。
但 9 比 11 不是普遍胜利。Phi-1.5-1.3B 上,LoLCATs 的平均分以 62.5 对 62.4 略高;Qwen2.5-32B-Instruct 上,QRWKV6 为 77.3,SWA 为 76.6。更重要的是,论文比较的是选定基础模型上的后训练线性化方法,没有证明从零训练的线性架构、所有混合架构都不如 SWA。
长上下文:赢了对手,也可能离目标很远
如果业务要从长材料中准确找回细节,短任务平均分就不够用了。论文在 Llama 3.1 8B 上做的 BABILong 测试,把这一点摆得很清楚。4K 上下文、256 窗口、QA1—QA5 平均准确率分别是:全注意力 60%,SWA 15%,LoLCATs 3%。SWA 明显领先该线性化方案,却只达到全注意力的四分之一。
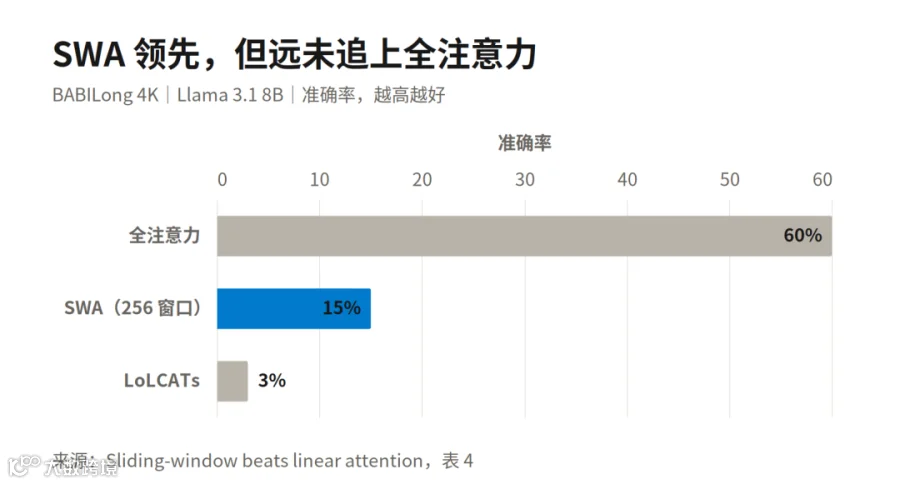 图片说明:根据论文表 4 重绘;Llama 3.1 8B、4K 上下文、256 窗口,数值为 BABILong QA1—QA5 平均准确率。图片来源:Sliding-window beats linear attention 论文
再看 1K 上下文,同一张表里 LoLCATs 是 22%,SWA 是 20%,全注意力是 70%。窗口方案并非在每个上下文长度、每项任务中都更好。单针检索(Single Needle-in-a-Haystack)也显示类似边界:在 4K、512 窗口的三种题型里,SWA 准确率是 19%、23%、23%,而全注意力约为 100%。这两项任务的质量评测最长只到 4K;不能据此推断 128K 等更长输入或其他窗口配置的成绩。
这组数字给工程判断加了一道门槛:“比某种线性化方案好”与“足以完成自己的长文任务”是两个问题。窗口外信息虽能通过多层局部计算间接传播,却不能因此假定任意久远的细节都可准确取回。要做文档问答、长日志分析或跨章节推理,先用自己的距离分布和错误容忍度测,不能拿通用任务的 99% 恢复率替代。
成本优势有条件:训练量和部署显存要分开算
从改造成本看,SWA 这条基线很省事:论文的受测设置不用后训练;LoLCATs 则使用约 4000 万 Token,其他线性化方案的训练量和阶段数也各不相同。这说的是把已有模型改到可用所需的训练投入,不是线上每次请求的成本。
为了比较解码速度与注意力状态显存,论文另做了一组微基准:四层 Transformer、隐藏维度 1024、16 个注意力头、批量 1、float16,运行在 RTX PRO 6000 Blackwell Max-Q 上。全注意力和 SWA 使用 FlashAttention,线性方案使用 ThunderKittens 对应内核。在这套条件下,SWA=64 的解码吞吐最高;上下文超过窗口后,它的 KV 状态显存保持平稳。全注意力的缓存则继续随上下文增长。
 图片说明:论文图 2 左侧是解码吞吐,右侧是 KV 缓存或循环状态显存;横轴为上下文长度。结果来自四层模型、批量 1 与指定显卡及内核,不能直接当作完整服务的端到端成本。 图片来源:Sliding-window beats linear attention 论文
因此,部署时我会先核对两个实现事实:推理框架是否真的只保留窗口与开头位置的 KV,而非只改了掩码却继续存着全部缓存;自己的模型和内核是否能在目标批量、提示词长度及生成长度下保持同样趋势。图 2 支持的是这套微基准里的吞吐与状态显存比较,不包含真实服务的预填充、调度和整体时延。
真正可带走的,是一条更严格的测试顺序
对已有 Softmax Transformer、又想把推理状态压到固定范围的团队,我会把带注意力汇的 SWA 放进候选列表,而且排在需要额外后训练的线性化改造之前测试。它的价值在于:用较低改造成本,先测出一个不弱的质量与推理成本参照。
这项测试至少要留下三组同条件结果:原模型全注意力的质量上限;不同窗口大小的 SWA 质量与 KV 占用;候选线性化方法在相同基础模型和任务上的成绩、追加训练量及服务吞吐。短任务与长距离检索分开看,才能发现平均分掩盖的失败。
论文没有比较包含全注意力层的混合模型,也没有完成 Agent、多模态或真实生产服务的验证。结论是“先测一个强而便宜的基线”,不是“滑动窗口已经解决长上下文”。若你的任务需要稳定找回远处的具体信息,4K 测试中 15% 对 60% 的差距,就足够提醒你别跳过自己的验收。
参考资料
《Sliding-window beats linear attention》论文原文、表 1—4 与图 1—2: https://arxiv.org/html/2608.28444
论文 arXiv 记录与版本日期: https://arxiv.org/abs/2608.28444
YaRN 位置编码扩展方法与有效长度验证: https://arxiv.org/abs/2309.00071
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!