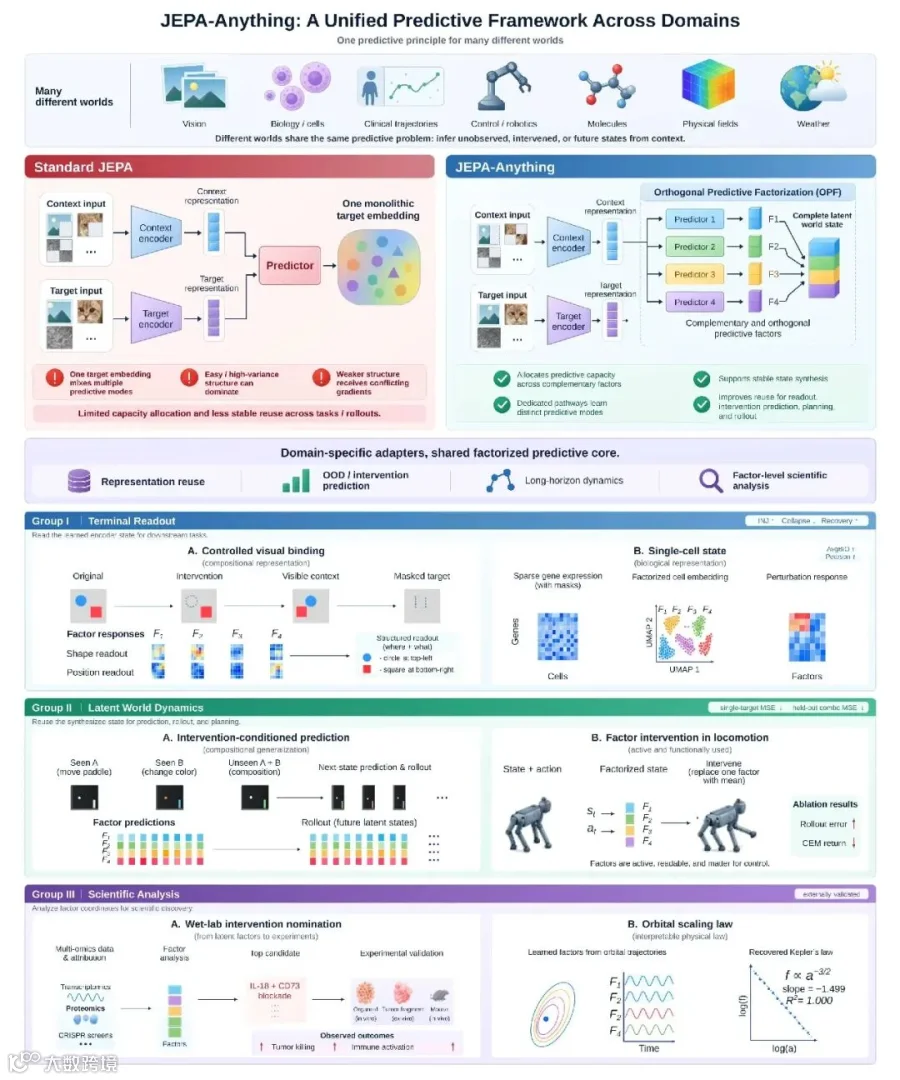
一套预测原则能否同时建模图像、细胞、临床记录、机器人控制、分子动力学、物理场和天气?PhAI Labs联合香港中文大学、复旦大学等团队提出JEPA-Anything,把JEPA的单一目标表示拆成K个互不重叠的正交预测因子,在7个领域的10个匹配任务上全部跑赢标准JEPA,干预预测误差最多下降34.83%,部分预测因子还拿到了湿实验支持。
世界模型这两年讲得很多,但绝大多数工作是「在一个领域里把预测做准」:视觉世界模型管视频,分子世界模型管动力学,临床模型管疾病风险。它们很少回答一个更根本的问题——这些看似毫不相关的系统,背后是否存在同一条可复用的预测学习原则。

JEPA(Joint-Embedding Predictive Architecture)是这条线上最受关注的框架之一,LeCun团队2023年的I-JEPA、2025年的V-JEPA 2都出自这个系列。但标准JEPA用一个预测器去拟合一整块目标表示,多个预测头如果各学各的,很容易学到大量重复的方向,既浪费容量,也谈不上「因子」。
PhAI Labs联合香港中文大学、复旦大学、香港城市大学,以及布里斯托大学、斯坦福大学、牛津大学、普林斯顿大学提出JEPA-Anything,在JEPA基础上引入正交预测因子分解(Orthogonal Predictive Factorization,OPF):把d维目标表示切成K个宽度为r的因子(Kr=d),每个因子配一条独立预测通路,再用Moore–Penrose伪逆把K个因子预测拼回完整状态。论文在视觉、单细胞、临床轨迹、干预控制、连续控制、PDE与天气、分子动力学七个领域验证,另加了生物干预与开普勒定律两项外部校验。
需要说清楚的一点:JEPA-Anything共享的是学习原则和隐状态接口,不是同一套权重或同一个encoder。每个领域仍用自己的encoder(DINOv3、scGPT、GPT-2 small、TrajCast等),OPF只是那个被反复复用的预测核心。
相关链接
-
论文:https://arxiv.org/abs/2609.20800 -
代码:https://github.com/Gen-Verse/JEPA-Anything -
模型:https://huggingface.co/collections/Gen-Verse/jepa-anything -
开源协议:代码Apache-2.0;
内容介绍

JEPA-Anything做的是一件事:给定某个系统的当前观测,预测它下一个状态的隐表示,并且把这个隐表示拆成若干个互不重叠、各自可解释的因子。
与常规「一个大模型吃所有模态」的路线不同,它的核心特点是:
-
跨领域共享算法,不共享权重——视觉用DINOv3 ViT-S,单细胞用scGPT,临床用GPT-2 small,分子用TrajCast风格等变网络,各领域只改adapter和采样器; -
因子间显式正交——不是靠事后聚类解释,而是在训练目标里直接约束子空间互不重叠; -
预测状态可直接复用——既能当普通encoder特征做readout,也能作为显式的latent transition做干预预测、规划与多步rollout。
适用场景:科学发现类世界模型研究、多领域自监督表示学习、需要从隐状态做干预推演的agent规划。

方法概述
一套机制管「怎么把状态拆开」,一套机制管「怎么让每个因子都活着」。
1. 统一的隐状态接口(One Interface, One Predictive Core)
每个领域提供一个adapter,把原始观测x映射成content token H和结构描述子S;再由view sampler选出上下文索引C和目标索引T。接口统一为x → (H,S) → (H_C, S_C, T, S_T),之后的全部计算完全一样:online encoder编上下文得到z_c,EMA目标编码器编完整观测得到z_t,EMA参数按θ̄ ← mθ̄ + (1-m)θ更新且不接收梯度。领域之间只换adapter和采样器的语义,预测核心与隐状态接口保持不变。
2. 正交预测因子分解(Orthogonal Predictive Factorization, OPF)
标准JEPA用单个预测器拟合整个目标嵌入,多个头容易学出重复方向。OPF引入K个可学习投影子P_k ∈ R^(d×r)并要求Kr=d,对stop-gradient后的目标表示做分解z_t^(k) = P_k^T z̃_t;每个因子由独立预测器q_k从上下文预测得到ẑ_t^(k),最后用(P^T)†伪逆合成完整状态ẑ_t。约束项L_orth同时要求每个投影子内部近似标准正交、不同投影子之间互相正交。论文证明了在这个零惩罚极限下P是正交阵,条件数κ₂(P)=1,预测误差不会被合成过程放大——这正是多个预测头能拼成一个完整状态、而不是互相打架的几何保证。机制审计里,无约束多头条件的跨因子子空间重叠为0.4550、条件数高达438.52,而OPF两项分别为5.18×10⁻¹⁶和1.00005。
3. 因子活性与编码器防塌缩(Maintaining Factor and Encoder Activity)
正交只规定了子空间之间的关系,不能保证每个因子都被真正用起来。OPF再加两个铰链项:L_fac对每个因子的每个坐标设一个标准差下限γ_fac,低于下限就产生梯度,防止某些因子「躺平」;L_enc对online上下文表示的每个坐标设独立下限γ_enc,直接给编码器反塌缩梯度。两项与预测项、正交项一起组成加性损失L_OPF,再加到各领域原有的基础损失上。实测中,九个带路由统计的预测任务平均使用3.782个有效因子(共4个),平均主导因子占比0.324,说明容量是分布式的,不是某一个因子独大。
实验结果
单细胞表示与扰动预测
预训练用约80万个人类肾脏细胞,在PBMC-10K聚类和Adamson、Norman两个扰动数据集上评估,5个种子取平均。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
| JEPA-Anything | 0.8301 | 0.7752 | 0.814 | 0.942 |
四项全部第一,其中零样本AvgBIO相对Cell-JEPA提升0.0558。
干预条件下的组合预测(CITRIS Interventional Pong)
与稠密标准JEPA同数据、同模型预算、5个固定种子配对比较,指标为四通道MSE。
|
|
|
|
|
|---|---|---|---|
|
|
|
0.006218 | -34.83% |
|
|
|
0.008223 | -12.90% |
|
|
|
0.008665 | -8.58% |

跨域动态与PDE
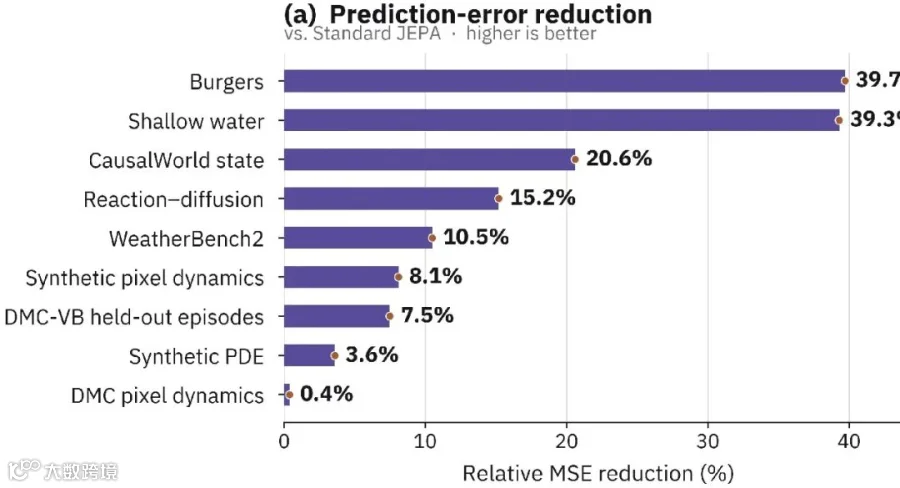
十任务匹配benchmark上,JEPA-Anything相对标准JEPA的MSE降幅从Burgers的**39.7%**到DMC pixel dynamics的0.4%不等,浅水方程39.3%、CausalWorld状态预测20.6%、Reaction–diffusion 15.2%、WeatherBench2 10.5%。附加的APEBench评测里,Burgers留出段MSE从0.16621降到0.08389(约-49.5%),六步rollout从0.29186降到0.16153(约-44.7%),Kuramoto–Sivashinsky留出段提升约13.2%,且三个指标都在每个种子上改善。

分子动力学rollout
TrajCast风格O(3)等变骨干,在液态水、α-石英、气相扑热息痛、苯四个体系上做100步自由自回归rollout,5个独立训练模型取平均。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
2.459 |
|
|
|
|
|
1.877 |
|
|
|
|
|
1.776 |
|
|
|
|
|
0.0645 |
四个体系的一步MAE与100步RMSD均为最低。
外部校验:湿实验与开普勒定律
因子分析接口提名的候选干预——IL-18联合NT5E/CD73阻断——在Huh7–PBMC共培养、患者来源类器官、肿瘤片段和免疫健全小鼠中均观察到抗肿瘤活性增强与免疫细胞激活增强。

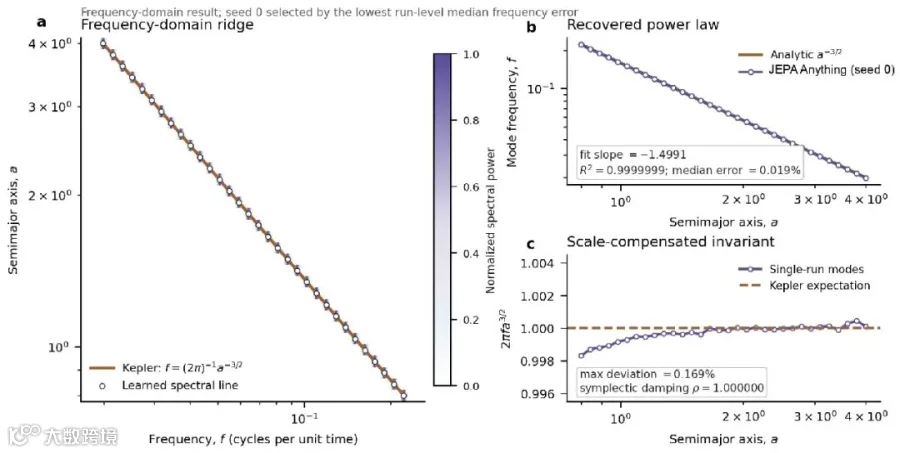
轨道部分,从无物理标签的位置–速度轨迹做谱分析,学到的latent频率与轨道半长轴满足开普勒关系f∝a^(-3/2),拟合斜率**-1.4991**、R²=0.9999999。
局限与未来方向
首先,连续控制不是全胜。容量匹配的CEM规划里,JEPA-Anything在Walker2d和HalfCheetah上平均回报更高,但Hopper上标准JEPA更好,论文自己写明「规划性能依赖环境」。
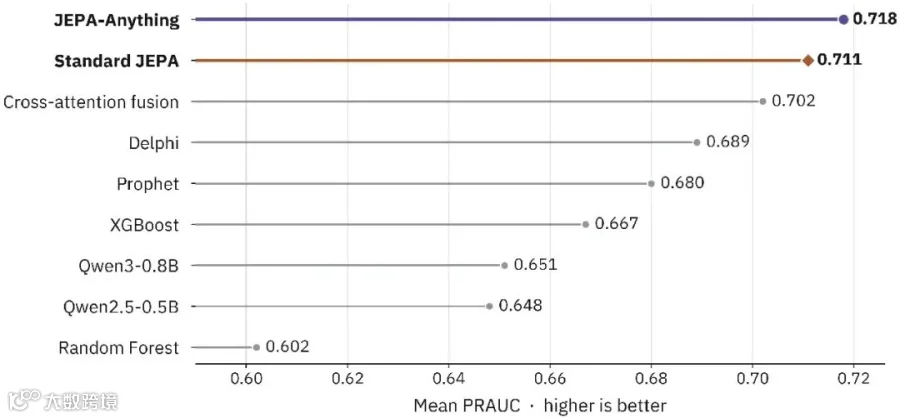
其次,临床任务的领先幅度很小。超过1000个事件的平均PRAUC只从0.711提到0.718,绝对提升0.007;单细胞Norman的Pearson从0.787到0.814,幅度也不大。这类提升是否足以改变实际工作流,需要看具体任务的容错空间。
第三,「Anything」是学习原则层面的通用,不是模型层面的通用。各领域不共享encoder也不共享权重,跨到一个新领域仍要重新训练;论文也承认正交因子本身并不确立因果机制,共享预测架构也不保证跨域表示对齐。
此外,权重没有发布。仓库只包含可复用的核心库、任务设计工具和一个synthetic线性动力学结构示例,README明确说明「不包含图中所示的领域数据集与训练好的模型权重」,checkpoint manifest记录的是一个未训练示例。论文里的数字无法用开源代码直接复现。
未来方向上,作者把OPF定位成Discovery Foundation Models与ScienceIDE、ScienceBuddy这类科学智能体工作流的预测底座,核心待解问题是分布偏移下的不确定性校准,以及「模型可靠到什么程度才值得指导一次实验」。
结论
JEPA-Anything验证了一件具体的事:把JEPA的单一目标表示显式拆成互不重叠的正交因子,并用伪逆把它们拼回去,在七个差异极大的领域里都能稳定带来预测收益,其中四个分子体系的100步rollout和CITRIS的单干预预测提升最实在。
对于做世界模型与自监督表示研究的读者,OPF是一个可以直接叠加到现有JEPA实现上的加性损失项,机制审计的四个几何指标(子空间重叠、σ_min、条件数、合成NMSE)值得照抄到自己的消融里;对于做科学计算或临床预测的工程团队,这篇的价值更多在思路上,权重未发布,短期内无法直接部署。风险提示必须说清楚:Apache-2.0只覆盖代码,论文核心结果没有可下载权重支撑,仓库的结构示例也不产生任何性能数字,引用时不要把它当成已开源的可用模型。
如果世界模型的通用性最终不是靠一个巨大的统一模型,而是靠一条可以被反复实例化的学习原则,那么JEPA-Anything给出的这条正交因子化路线,是目前证据最完整的一份。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~