

哈喽,大家好~
实验之前的数据预处理中,有一个非常关键的步骤:特征选择。
今儿和大家聊聊为什么要做特征选择?
数据矩阵 与标签 (可以是分类或回归),在高维问题(尤其当 )中。
一般来说,直接使用所有特征会面临:
-
过拟合风险高:模型可以拟合噪声; -
维度灾难:推断/优化不稳定、计算开销大; -
可解释性差:难以理解哪些变量真正重要; -
测量成本高:实际采集或存储过多特征有代价。
以上四种,足以让实验没办法进一步开展~
特征选择的核心目标是在不显著牺牲模型性能的前提下,选出与目标变量最相关、且相互冗余较少的一组特征子集 ,通常满足 ,以提升泛化性能、鲁棒性和可解释性。
一个经典的理想化目标函数是:
其中 是泛化风险(如期望损失), 是仅使用特征子集 训练得到的模型。
该问题一般为 NP-hard,因此实际采用启发式方法或可替代的凸/非凸正则化策略。
特征选择三大方法
特征选择通常分为三大类:
过滤式(Filter):不依赖具体模型,基于统计量或信息论指标,对每个特征独立打分,再排序筛选。例如皮尔逊相关/ANOVA F检验/互信息等。
包装式(Wrapper):把选择子集当作搜索问题,利用模型性能(如交叉验证的分数)作为评价函数,引导前向/后向搜索或用RFE等方法递归消除。
嵌入式(Embedded):在模型训练过程中同步进行特征选择,例如 L1 正则(Lasso/稀疏Logistic)或树模型的重要性度量等。
下面,咱们分别对上述三种方法,进行一个简单的介绍,让大家更加容易理解~
过滤式
过滤式方法的思想是设计一个与 相关的打分函数 来度量第 个特征 与标签 的关系,然后对 排序并选取前 大或满足阈值的特征集合。
常见指标:
皮尔逊相关与 t 检验(回归/二分类近似)
皮尔逊相关系数:
在高斯噪声假设下,对零假设 (真实相关为零),可构造 t 统计量:
在 下 近似服从自由度 的 t 分布,可以得到 值并控制多重比较。
对二分类问题,ANOVA F 检验常用来衡量不同类别的均值差异,相当于对 的组间方差与组内方差比率的检验。单因素 ANOVA 的 统计量为:
其中 是类别数, 是第 类样本数, 是该类的索引集合, 是该类在特征 上的均值, 是整体均值。
互信息
互信息度量随机变量间的非线性依赖程度:
其中:
-
; -
当且仅当 与 独立; -
不要求线性关系,能捕捉更广泛的依赖。
实践中常用基于 kNN 或核密度的互信息估计器,sklearn 提供了基于最近邻的 mutual_info_classif/mutual_info_regression 估计。
最小冗余最大相关
过滤式中处理冗余的经典方法是 mRMR,目标是找一个集合 ,使得:
-
与目标 的相关性最大化; -
集合内特征之间冗余最小化。
常见的目标:
其中 是冗余度量,通常取互信息 或者用皮尔逊相关的绝对值 作为近似。该问题常用贪心迭代:初始空集,每步加入一个使目标增幅最大的特征。
大家要注意,严格的 mRMR 用 ,估计两两互信息在连续变量场景较耗时,工程上可用 替代。
包装式方法
包装式方法把特征子集当作超参数,用模型在验证集上的分数作为评分函数,通过搜索策略寻找较好的子集。
典型方法:
逐步前向/后向选择
-
前向选择:从空集开始,每次加入使验证性能提升最大的一个特征,直到达到上限 或性能不再提升。 -
后向消除:从全集开始,每次删除使验证性能损失最小的一个特征。
贪心方法不保证全局最优,但在实际中常有不错表现。
递归特征消除
RFE 是一种借助估计器的重要性进行迭代筛除的方法。假设有一个线性模型(如 Logistic/Linear)或树模型,我们在每次拟合后根据系数绝对值或特征重要性排序,删除一部分重要性最低的特征,然后在剩余特征上重复。
RFE 的优化思想可以理解为对目标函数的近似局部贪心搜索。sklearn 提供了 RFE 与 RFECV(交叉验证选择特征数量)实现。
嵌入式方法
嵌入式方法在模型训练中引入稀疏或结构化先验,从而直接驱动特征选择。
L1 正则与稀疏性
以二分类 Logistic 回归为例,给定权重向量 和偏置 ,负对数似然为:
引入 L1 正则:
L1 正则的一个关键性质是诱导稀疏:在最优解处,有大量 。
用次梯度/KKT 条件可以解释稀疏性:
-
对 使 ,有
-
对 使 ,有
这意味着如果损失对某维的梯度绝对值小于阈值 ,该维会被压到零。
几何上是 L1 球具有尖角,与光滑等损失曲面相切于坐标轴点,从而诱导稀疏。
对线性回归(Lasso),目标为:
在坐标下降中,经典的软阈值更新可以写为:
其中 。这直接体现了 L1 如何将小于阈值的贡献推到零。
弹性网
当特征强相关时,纯 L1 会有不稳定性,弹性网引入 L2 项:
其中 。L2 有助于在相关特征间共享权重,提升稳定性;L1 保持稀疏。
完整案例
我们构造一个具有以下性质的数据集,模拟现实难点:
-
样本数 ,特征数 ; -
特征按组相关:30个组,每组10个特征;同组特征强相关(由潜变量加噪生成); -
有 个信息性特征(部分线性,部分非线性,包含交互项),其余为冗余或纯噪声; -
分类边界由线性项、交互项与非线性变换混合形成,使线性方法存在一定挑战; -
我们在训练-测试拆分后,对比多种特征选择策略在选择质量(发现真实特征)与下游模型性能(AUC)之间的关系; -
训练下游分类器使用正则化 Logistic 回归,因为可解释,易于控制。
方法对比:
过滤式:
-
SelectKBest + mutual_info_classif(非线性依赖) -
SelectKBest + f_classif(ANOVA F,近似线性) -
自实现 mRMR(使用 MI 与相关惩罚的贪心近似)
包装式:
-
RFE(基于 LogisticRegression)
嵌入式:
-
稀疏 Logistic(L1,Saga 优化),用系数绝对值排序 -
随机森林重要性(基尼重要性)
稳定性选择:
-
基于 L1 Logistic 的子样本稳定性路径(多组正则强度)
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_score
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import roc_auc_score
from sklearn.feature_selection import SelectKBest, mutual_info_classif, f_classif
from sklearn.feature_selection import RFE
from sklearn.ensemble import RandomForestClassifier
from sklearn.base import BaseEstimator, TransformerMixin, clone
from sklearn.utils import check_random_state
from sklearn.metrics import precision_recall_curve, average_precision_score
from scipy.stats import rankdata

rng = check_random_state(42)

# 1) 生成数据
def generate_synthetic_data(n=5000, p=300, groups=30, group_size=10, rho=0.9, n_informative=20, random_state=42):
    rng = check_random_state(random_state)
    assert groups * group_size == p

    # 组潜变量
    z = rng.normal(size=(n, groups))
    # 构造各组特征
    X = np.zeros((n, p))
    for g in range(groups):
        eps = rng.normal(size=(n, group_size))
        X[:, g*group_size:(g+1)*group_size] = rho * z[:, [g]] + np.sqrt(1 - rho**2) * eps

    # 选择若干信息性特征分布在前几个组
    informative_idx = []
    # 从前4个组中选出若干特征作为信息性一阶特征
    groups_for_signal = [0, 1, 2, 3]
    for g in groups_for_signal:
        # 每组随机挑选部分特征
        idx_in_group = rng.choice(group_size, size=3, replace=False)
        informative_idx.extend(list(g*group_size + idx_in_group))
    informative_idx = list(sorted(set(informative_idx)))[:n_informative]  # 取前n_informative个

    # 构造线性项权重
    w = np.zeros(p)
    # 让线性项主要集中在 informative_idx 的前 12 个,以保证有较强线性信号
    main_linear = informative_idx[:12]
    w[main_linear] = rng.uniform(0.8, 1.5, size=len(main_linear)) * rng.choice([-1,1], size=len(main_linear))

    # 构造交互项(从 informative_idx 中选择两对)
    if len(informative_idx) >= 6:
        ia, ib, ic, idd = informative_idx[0], informative_idx[1], informative_idx[2], informative_idx[3]
    else:
        ia, ib, ic, idd = 0, 1, 2, 3

    # 构造非线性项:sin 作用在若干 informative 特征的线性组合上
    nonlin_set = informative_idx[12:16] if len(informative_idx) >= 16else informative_idx[:4]
    beta_nonlin = rng.uniform(0.5, 1.0, size=len(nonlin_set)) * rng.choice([-1,1], size=len(nonlin_set))

    # 线性部分
    linear_part = X @ w
    # 交互部分
    inter_part = 1.5 * (X[:, ia] * X[:, ib]) + 1.2 * (X[:, ic] * X[:, idd])
    # 非线性部分
    nonlin_part = 2.0 * np.sin(X[:, nonlin_set] @ beta_nonlin)

    eta = 0.3 * linear_part + 0.8 * inter_part + 0.8 * nonlin_part
    # 激活概率(逻辑函数)
    prob = 1.0 / (1.0 + np.exp(-eta))
    y = rng.binomial(1, prob)

    true_informative = set(informative_idx)  # 真实信息性特征索引集合
    return X, y, true_informative, {
        'w': w, 'ia': ia, 'ib': ib, 'ic': ic, 'id': idd, 'nonlin_set': nonlin_set, 'beta_nonlin': beta_nonlin
    }


# 2) 辅助:根据打分或重要性产生特征排名
def rank_features_by_scores(scores):
    # 分数越大越优,返回从优到劣的索引序列
    # 当存在 NaN,替换为 -inf
    s = np.array(scores).astype(float)
    s[np.isnan(s)] = -np.inf
    order = np.argsort(-s)  # descending
    return order, s

# 3) mRMR 近似(使用互信息与相关惩罚),贪心选择
class ApproxMRMR(BaseEstimator, TransformerMixin):
    def __init__(self, k=20, lambda_red=0.5, random_state=42):
        self.k = k
        self.lambda_red = lambda_red
        self.random_state = random_state
        self.selected_ = None
        self.scores_ = None# 保存每个特征的最终得分(便于排名)
        self.mi_ = None      # 与y的MI
        self.corr_ = None    # 皮尔逊相关矩阵(绝对值)

    def fit(self, X, y):
        from sklearn.feature_selection import mutual_info_classif
        rng = check_random_state(self.random_state)
        X = np.asarray(X)
        y = np.asarray(y)
        n, p = X.shape

        # MI with y
        mi = mutual_info_classif(X, y, random_state=self.random_state)
        # correlation matrix (absolute)
        corr = np.corrcoef(X, rowvar=False)
        corr = np.nan_to_num(corr, nan=0.0)
        corr_abs = np.abs(corr)

        selected = []
        candidate = set(range(p))
        scores = np.zeros(p)

        for t in range(min(self.k, p)):
            best_j = None
            best_score = -np.inf
            for j in candidate:
                red = 0.0
                if len(selected) > 0:
                    red = corr_abs[j, selected].mean()
                score = mi[j] - self.lambda_red * red
                if score > best_score:
                    best_score = score
                    best_j = j
            selected.append(best_j)
            candidate.remove(best_j)
            scores[best_j] = best_score

        self.selected_ = np.array(selected, dtype=int)
        self.scores_ = scores
        self.mi_ = mi
        self.corr_ = corr_abs
        return self

    def transform(self, X):
        return X[:, self.selected_]

    def get_support(self, indices=False):
        mask = np.zeros_like(self.scores_, dtype=bool)
        mask[self.selected_] = True
        return self.selected_ if indices else mask

    def get_ranking(self):
        # 根据 scores_ 从大到小排序(未选中的为 -inf,故排不到前面)
        order = np.argsort(-self.scores_)
        return order, self.scores_


# 4) 稳定性选择:对L1 Logistic在不同C上进行子样本重采样统计频率
def stability_selection_L1_logreg(X, y, C_grid, n_subsamples=50, sample_fraction=0.5, random_state=42, max_iter=2000):
    rng = check_random_state(random_state)
    n, p = X.shape
    sel_freqs = np.zeros((len(C_grid), p))

    for iC, C in enumerate(C_grid):
        counts = np.zeros(p, dtype=float)
        for b in range(n_subsamples):
            idx = rng.choice(n, size=int(n * sample_fraction), replace=False)
            X_sub, y_sub = X[idx], y[idx]
            pipe = Pipeline([
                ('scaler', StandardScaler()),
                ('clf', LogisticRegression(penalty='l1', C=C, solver='saga', max_iter=max_iter, n_jobs=-1))
            ])
            pipe.fit(X_sub, y_sub)
            # 获取系数
            clf = pipe.named_steps['clf']
            coef = clf.coef_.ravel()
            selected = np.where(np.abs(coef) > 1e-8)[0]
            counts[selected] += 1.0
        sel_freqs[iC] = counts / n_subsamples
    return sel_freqs  # shape: (len(C_grid), p)


# 5) 评估函数:给定排名,计算不同k下的测试AUC,以及特征发现的精确率-召回(针对真实集合)
def eval_rankings(X_train, y_train, X_test, y_test, ranking_dict, true_set, k_list, random_state=42):
    results = {}
    for name, order in ranking_dict.items():
        aucs = []
        precs = []
        recs = []
        ap_list = []  # 平均精度(特征发现的PR曲线的面积),作为额外参考
        for k in k_list:
            sel = order[:k]
            # 模型性能(AUC)
            pipe = Pipeline([
                ('scaler', StandardScaler()),
                ('clf', LogisticRegression(penalty='l2', C=1.0, solver='lbfgs', max_iter=2000))
            ])
            pipe.fit(X_train[:, sel], y_train)
            prob = pipe.predict_proba(X_test[:, sel])[:,1]
            auc = roc_auc_score(y_test, prob)
            aucs.append(auc)

            # 特征发现质量:计算精确率-召回(把选择任务当作发现真实集合的检索任务)
            hits = len(set(sel).intersection(true_set))
            precision = hits / max(k, 1)
            recall = hits / max(len(true_set), 1)
            precs.append(precision)
            recs.append(recall)

            # 为了计算AP(Average Precision),我们需要对所有特征给一个**相关标签**,并基于排名构造PR。
            # 我们采用一种近似:对全体特征构建一个二值向量 gt[j]=1 if j in true_set else 0,
            # 再把 ranking 的顺序作为打分顺序(分数随排名递减),由此计算一个PR曲线的AP。
            gt = np.zeros(X_train.shape[1], dtype=int)
            for j in true_set:
                gt[j] = 1
            # 构造分数:排名靠前分数高
            scores = np.zeros_like(gt, dtype=float)
            # 使用反向名次作为分数
            for r, j in enumerate(order):
                scores[j] = len(order) - r
            precision_curve, recall_curve, _ = precision_recall_curve(gt, scores)
            ap = average_precision_score(gt, scores)
            ap_list.append(ap)

        results[name] = {
            'k': k_list,
            'auc': np.array(aucs),
            'precision': np.array(precs),
            'recall': np.array(recs),
            'AP': np.array(ap_list)
        }
    return results


# 6) 主流程
X, y, true_set, extra = generate_synthetic_data()
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.35, stratify=y, random_state=42
)

n, p = X.shape
print("Data shape:", X.shape, "Positive rate:", y.mean())
print("True informative size:", len(true_set))

# 6.1 过滤式:MI与ANOVA F
skb_mi = SelectKBest(score_func=mutual_info_classif, k='all')
skb_mi.fit(X_train, y_train)
mi_scores = skb_mi.scores_
order_mi, _ = rank_features_by_scores(mi_scores)

skb_f = SelectKBest(score_func=f_classif, k='all')
skb_f.fit(X_train, y_train)
f_scores = skb_f.scores_
order_f, _ = rank_features_by_scores(f_scores)

# 6.2 mRMR近似
mrmr = ApproxMRMR(k=min(80, p), lambda_red=0.6, random_state=42)
mrmr.fit(X_train, y_train)
order_mrmr, mrmr_scores = mrmr.get_ranking()

# 6.3 包装式:RFE (Logistic)
# 注意:RFE 计算可能相对耗时,可适当减少步长或特征数量
base_lr = LogisticRegression(penalty='l2', C=1.0, solver='liblinear', max_iter=2000)
rfe = RFE(estimator=base_lr, n_features_to_select=30, step=0.1)  # 先RFE到30维,再按coef排序
rfe.fit(X_train, y_train)
# 用 RFE 支持的特征再根据 coef 细化排名
support_rfe = np.where(rfe.support_)[0]
# 在支持内用绝对系数值排序
pipe_tmp = Pipeline([('scaler', StandardScaler()),
                     ('clf', LogisticRegression(penalty='l2', C=1.0, solver='liblinear', max_iter=2000))])
pipe_tmp.fit(X_train[:, support_rfe], y_train)
coef_abs = np.abs(pipe_tmp.named_steps['clf'].coef_.ravel())
order_in_support = np.argsort(-coef_abs)
order_rfe = support_rfe[order_in_support]
# 把不在支持内的特征按某种顺序拼接到后面(这里用MI次序补全)
rest = [j for j in order_mi if j notin set(order_rfe)]
order_rfe_full = np.concatenate([order_rfe, rest])

# 6.4 嵌入式:L1 Logistic + 系数排序
pipe_l1 = Pipeline([
    ('scaler', StandardScaler()),
    ('clf', LogisticRegression(penalty='l1', C=0.5, solver='saga', max_iter=3000, n_jobs=-1))
])
pipe_l1.fit(X_train, y_train)
coef_l1 = np.abs(pipe_l1.named_steps['clf'].coef_.ravel())
order_l1, _ = rank_features_by_scores(coef_l1)

# 6.5 嵌入式:随机森林重要性
rf = RandomForestClassifier(
    n_estimators=300, max_depth=None, min_samples_split=2, min_samples_leaf=1, random_state=42, n_jobs=-1
)
rf.fit(X_train, y_train)
imp_rf = rf.feature_importances_
order_rf, _ = rank_features_by_scores(imp_rf)

# 6.6 稳定性选择(针对L1 Logistic,在多组C上做重采样)
C_grid = np.logspace(-1.5, 0.7, 10)  # 比较宽的正则强度范围
sel_freqs = stability_selection_L1_logreg(
    X_train, y_train, C_grid, n_subsamples=60, sample_fraction=0.5, random_state=42, max_iter=3000
)
# 对每个C,得到频率作为排名依据(取平均或取最大频率)
freq_mean = sel_freqs.mean(axis=0)  # 简化做法:将多个C的频率取平均
order_stab, _ = rank_features_by_scores(freq_mean)

# 整理排名用于评估
ranking_dict = {
    'MI': order_mi,
    'ANOVA_F': order_f,
    'mRMR_approx': order_mrmr,
    'RFE_LR': order_rfe_full,
    'L1_Logistic': order_l1,
    'RandomForest': order_rf,
    'Stability_L1': order_stab
}

# 评估:k列表
k_list = [5, 10, 15, 20, 30, 40, 60, 80]
results = eval_rankings(X_train, y_train, X_test, y_test, ranking_dict, true_set, k_list)

# 7) 可视化
palette = sns.color_palette("bright", n_colors=len(ranking_dict))

# 子图1:稳定性选择路径热力图(频率随C变化)
plt.figure(figsize=(7, 6))

# 按平均频率排序取前50
topk_for_heatmap = 50
top_idx = np.argsort(-freq_mean)[:topk_for_heatmap]
freq_sub = sel_freqs[:, top_idx]  # shape=(len(C_grid), topk)

im = plt.imshow(
    freq_sub.T,
    aspect='auto',
    interpolation='nearest',
    cmap='turbo'
)

plt.title(
    'A) 稳定性选择路径(L1 Logistic)\n特征选择频率随 C 变化(前50)',
    color='#e74c3c',
    fontsize=12,
    fontweight='bold'
)
plt.xlabel('不同的 C(右侧代表更弱的正则)', color='#2c3e50')
plt.ylabel('特征(按平均频率排序)', color='#2c3e50')

plt.xticks(
    range(len(C_grid)),
    [f"{c:.2f}"for c in C_grid],
    rotation=45,
    ha='right'
)

cbar = plt.colorbar(im, fraction=0.046, pad=0.04)
cbar.set_label('选择频率', color='#2c3e50')

plt.tight_layout()
plt.show()


# 子图2:模型性能 vs. 选择特征数(AUC曲线)
plt.figure(figsize=(7, 5))

palette = sns.color_palette("bright", n_colors=len(ranking_dict))

for i, (name, res) in enumerate(results.items()):
    plt.plot(
        res['k'],
        res['auc'],
        marker='o',
        lw=2.0,
        color=palette[i],
        label=name
    )

plt.title(
    'B) 测试集 AUC vs 选择特征数',
    color='#e67e22',
    fontsize=12,
    fontweight='bold'
)
plt.xlabel('选择的特征数 k', color='#2c3e50')
plt.ylabel('AUC', color='#2c3e50')
plt.ylim(0.5, 1.0)
plt.legend(loc='lower right', frameon=True)

plt.tight_layout()
plt.show()


# 子图3:相关性热图(在某方法选择的Top40内)
plt.figure(figsize=(6, 6))

# 以 L1_Logistic 的 Top40 为例
ref_method = 'L1_Logistic'
ref_order = ranking_dict[ref_method][:40]
corr_sub = np.corrcoef(X_train[:, ref_order], rowvar=False)

sns.heatmap(
    corr_sub,
    cmap='coolwarm',
    vmin=-1,
    vmax=1,
    square=True,
    cbar=True
)

plt.title(
    'C) 选择子集内部相关性(L1 Top-40)',
    color='#16a085',
    fontsize=12,
    fontweight='bold'
)
plt.xlabel('特征索引(Top-40 内顺序)', color='#2c3e50')
plt.ylabel('特征索引(Top-40 内顺序)', color='#2c3e50')

plt.tight_layout()
plt.show()


# 子图4:特征发现的PR曲线(Perfect discovery of true set)
plt.figure(figsize=(6, 5))

for i, (name, res) in enumerate(results.items()):
    plt.plot(
        res['recall'],
        res['precision'],
        marker='s',
        lw=2.0,
        color=palette[i],
        label=f"{name} (AP≈{res['AP'][-1]:.2f})"
    )

plt.title(
    'D) 发现真实特征的 PR 曲线(随 k 变化)',
    color='#8e44ad',
    fontsize=12,
    fontweight='bold'
)
plt.xlabel('召回率(相对于真实特征)', color='#2c3e50')
plt.ylabel('精确率(选中特征中为真)', color='#2c3e50')
plt.xlim(0, 1.05)
plt.ylim(0, 1.05)
plt.legend(loc='lower left', frameon=True)

plt.tight_layout()
plt.show()


# 部分方法在k=20时的对比
k0 = 20
print("\n=== 在k=20时的对比(AUC/Precision/Recall) ===")
for name, res in results.items():
    idx = np.where(np.array(res['k']) == k0)[0]
    if len(idx):
        i = idx[0]
        print(f"{name:15s}  AUC={res['auc'][i]:.3f}  Prec={res['precision'][i]:.3f}  Rec={res['recall'][i]:.3f}")
稳定性选择路径热力图:
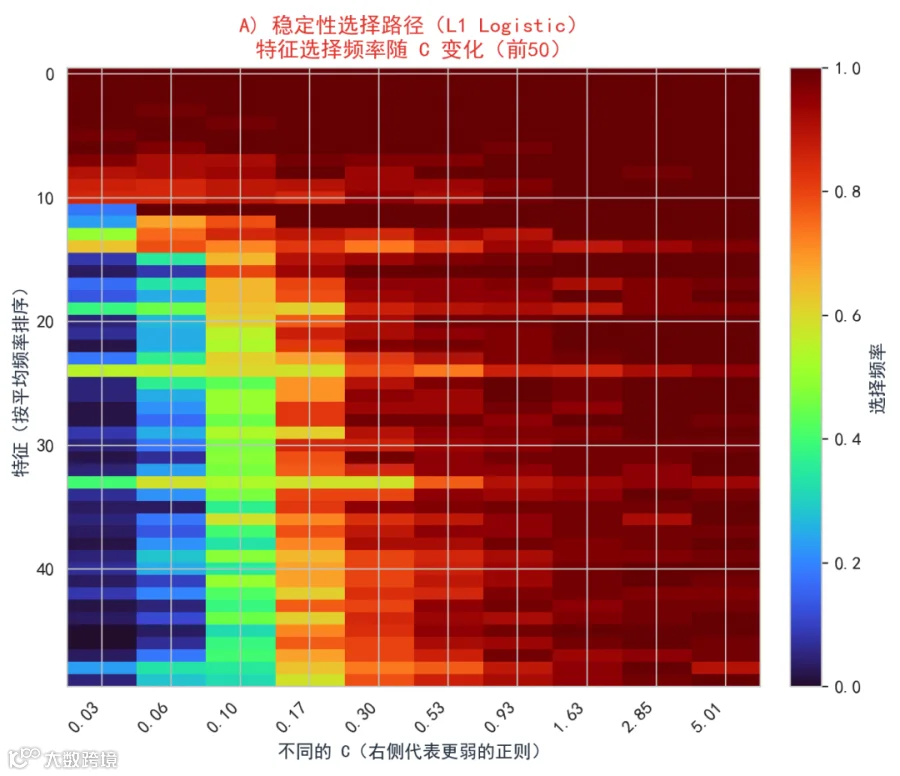
横轴为不同的正则强度,C 越大正则越弱,选择特征越多;纵轴为特征,按平均频率排序后取前50;颜色表示在若干子采样重复中的被选频率。
如果一个特征在大多数子样本、较广的正则范围内都被选中,说明该特征稳定且强。这比一次性训练得到的0/1 选择更稳健,能识别那些对扰动不敏感的核心变量。对于频率忽高忽低的特征,提示其不稳定或依赖特定正则强度。
AUC vs k:
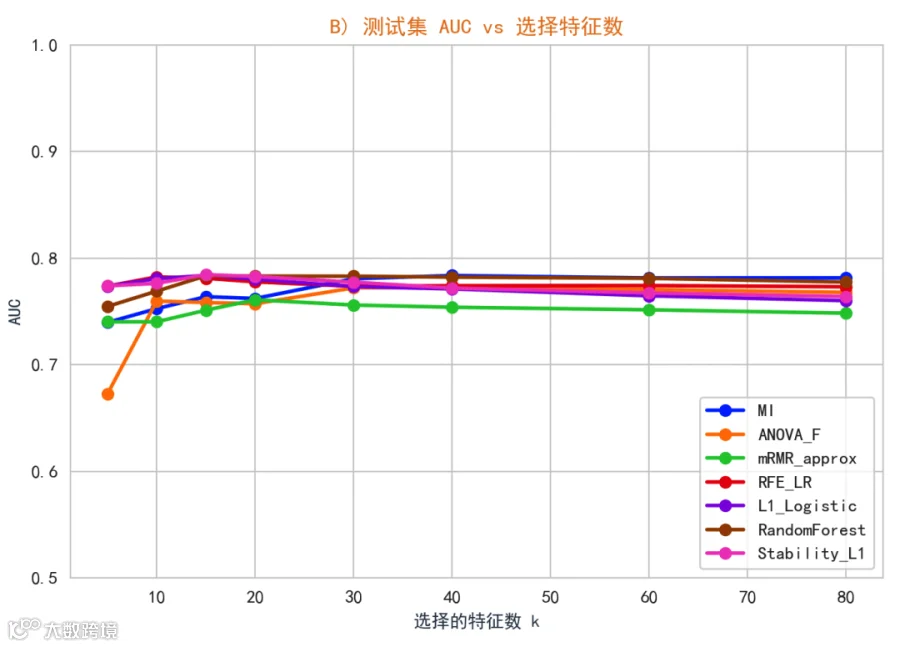
展示各方法在选择不同数量的特征后,下游 Logistic 模型的测试 AUC。曲线呈现先上升后趋稳或下降的典型现象:过少特征不足以表达信息,过多则引入噪声或冗余导致泛化变差。
帮助确定性价比最佳的 k 值,以及比较方法在不同预算下的预测能力。例如,如果 L1_Logistic 与 Stability_L1 曲线在较小 k 上更高,说明稀疏正则兼具筛噪与保信的优势。
Top-40 内部的相关性热图:
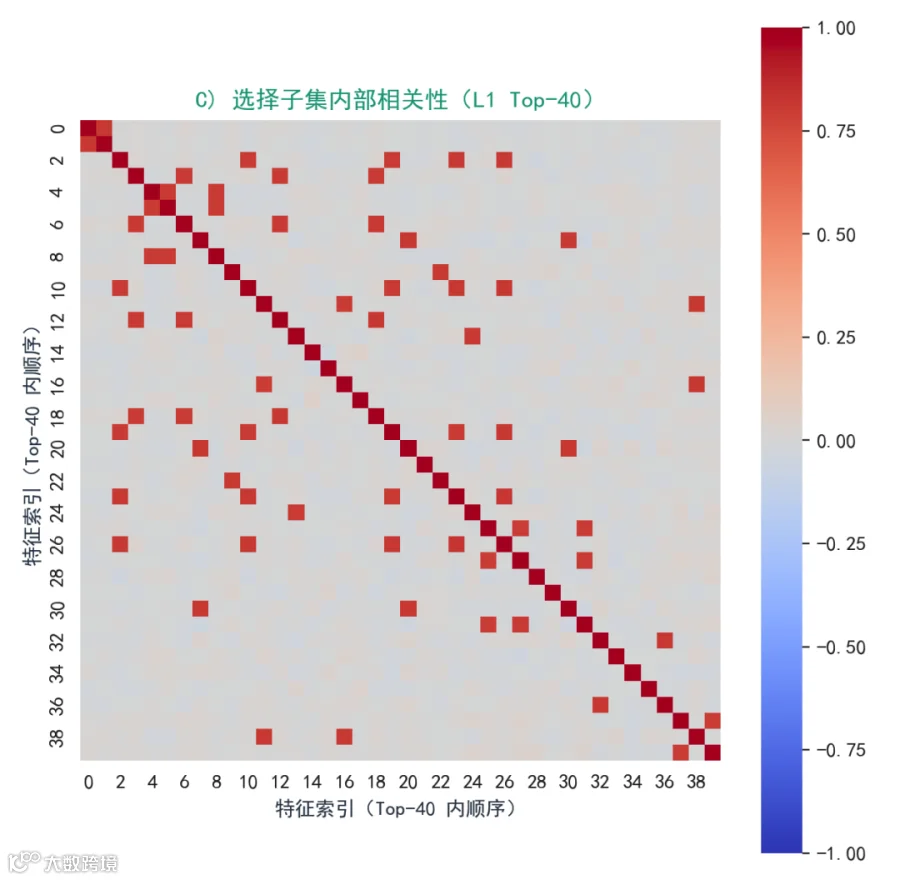
以某方法(如 L1_Logistic)的前40个特征为例,画出其皮尔逊相关矩阵。若出现明显的块状高相关,说明被选集合内存在冗余簇(来自同一特征组),这可能造成解释冗余或模型稳定性问题。
提示我们是否需要进一步做去冗余处理(如 mRMR/相关约束)或采用弹性网而非纯 L1 以分摊权重的稳定性;也提示在部署端是否可以删去成本较高而信息重复的变量。
特征发现PR曲线:
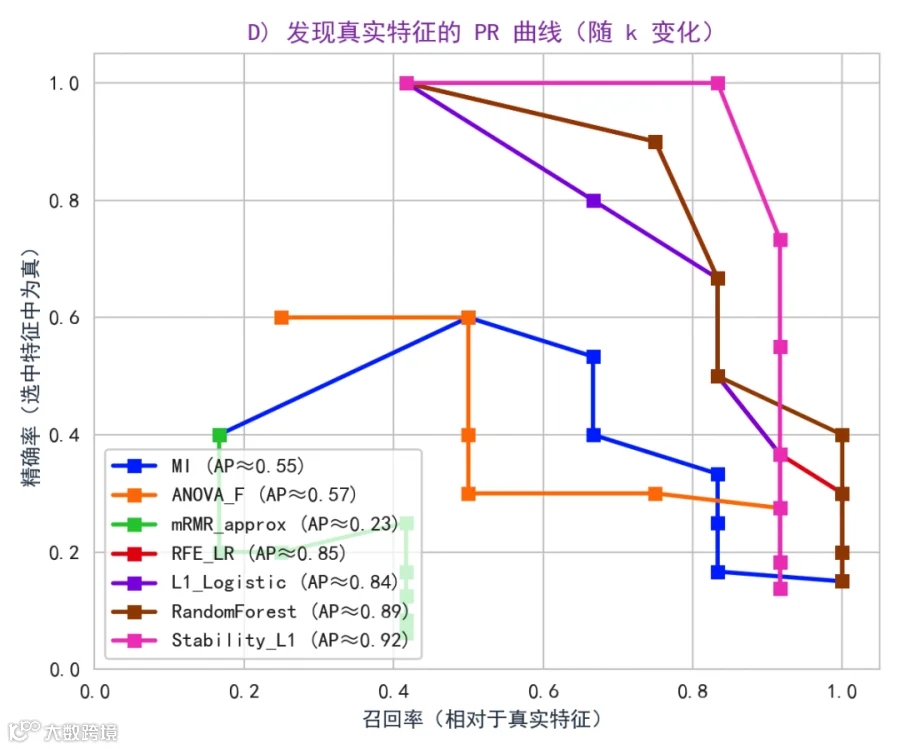
不同方法对真实信息性特征集合的发现质量。随着 k 增加,召回上升但精确率可能下降;理想情况是曲线整体更靠近右上角。
这是特征选择作为变量发现任务的专属评估,区别于下游 AUC。一个方法可能在预测性能上不错,但发现的特征并非真实致因而是其代理(proxy);PR曲线揭示了方法在科学发现/解释维度的真实性能。
由于数据中包含强相关簇与非线性交互,可能观察到以下现象:
MI 往往优于 ANOVA F,在包含非线性与交互时,能抓住 ANOVA 难以捕捉的非线性依赖;
L1 Logistic 在较小 k 时能取得较高 AUC,因其稀疏性与对噪声的抑制;但面对强相关簇,其选择可能在高度相关特征间随机性较大;
随机森林重要性可能擅长捕捉非线性与交互关系,但在高度相关特征中重要性会分摊,导致发现真特征的精确率不一定最高;
mRMR 近似(MI-相关惩罚)在去冗余方面有优势,Top-k 集合内的相关性通常较低;
稳定性选择能显著提升选择的鲁棒性,热力图会显示几个坚挺的特征在广泛的 C 区间都以高频被选,作为核心变量候选;
在 AUC vs k 的曲线中,各方法在小 k 区间的排名尤为重要,反映出在资源有限时,谁能更早找准关键特征。
优化项
Group Lasso/OSCAR/SGL 等结构化稀疏:如果知道特征的组结构,可以用组稀疏选择整组或组内稀疏(sklearn未内置,可借助第三方库);
Knockoffs 与 FDR 控制:现代变量选择的统计保证(如 Model-X Knockoffs)可在存在复杂依赖时提供更可靠的错误控制(需要专用实现);
交互发现:在管道中显式构造二阶交互项(PolynomialFeatures)后配合 L1 进行筛选;
稳定性选择的多正则网格:不仅在单一 C 上统计频率,还可跨多个 C 求最大/平均频率,并设置双阈值选择;
重要性重估(refit):先选择一批特征,再用更强模型(或去除冗余)重新拟合与排序。
总结
总体而言:若目标是预测为主,L1/Elastic Net 与稳定性选择是强力基线;在存在非线性时,树模型/互信息提供增益;
若目标是变量发现/解释为主,应结合稳定性选择、FDR 控制、mRMR 去冗余以及与领域知识的交叉验证;
切记使用严格的评估流程(嵌套CV、防泄露),并优先选择在小 k 区间表现稳健的方法,以达到成本-性能-解释性的良好平衡。