


01 一个被忽视的巧合
2026年6月,一个叫"Loop Engineering"的概念在AI编程圈突然火了。
Anthropic的工程师说"我现在的工作就是写Loop",Google的AI工程总监Addy Osmani系统整理了这个概念,OpenAI和Anthropic的最新产品都在往这个方向演进。

Loop Engineering架构:五大模块 + 记忆机制(来源:基于Addy Osmani的Loop Engineering概念)
所有人都在讨论:Loop是什么?怎么配置?怎么省钱?
但没人注意到一个更深层的问题:Loop的底层逻辑,跟钱学森1954年提出的工程控制论,几乎是完美对应的。
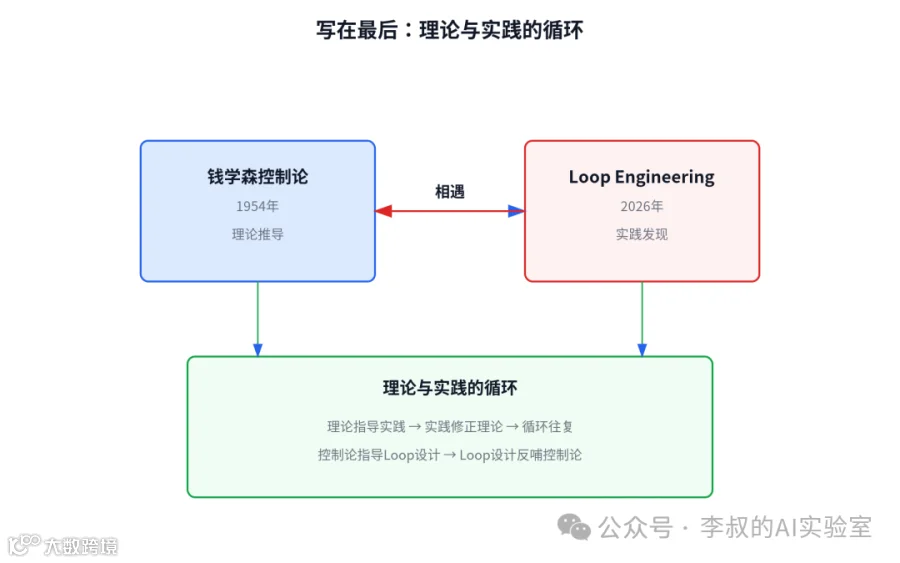
这不是巧合。这是"从理论到实践"和"从实践到理论"在同一个点上相遇了。
钱学森在70年前推导出的控制论原理,正在被2026年的AI工程师从实践中"重新发现"。
这篇文章不是Loop的入门教程(网上已经有很多了)。这篇文章要做的是:用控制论的框架,重新理解Loop Engineering。
02 钱学森工程控制论的五个核心原理
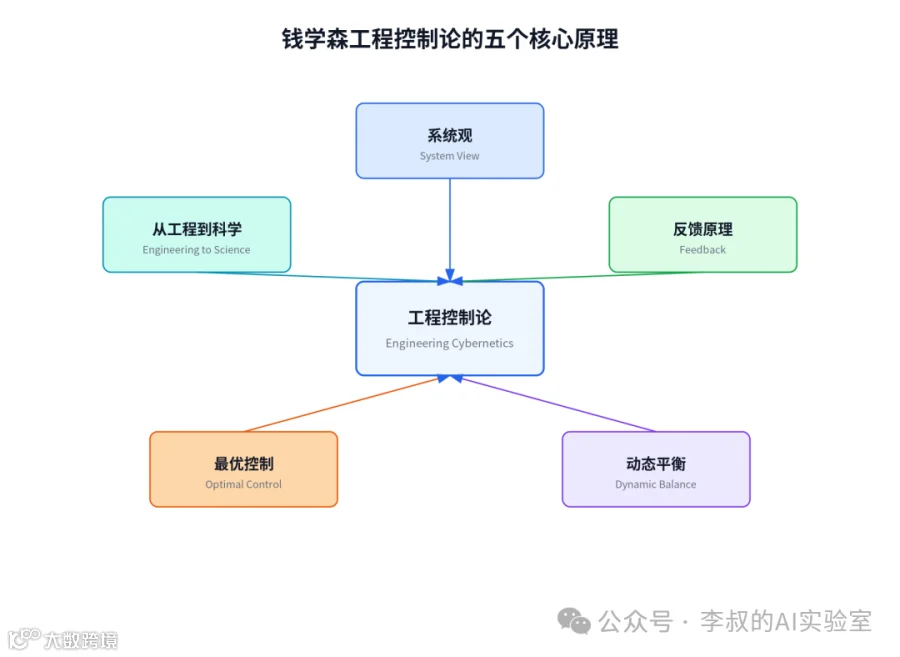
在讲Loop之前,先快速回顾钱学森工程控制论的核心思想。这五个原理,是理解后面所有内容的钥匙。
原理一:系统观
整体系统,要素关系及交互,非孤立部件。
一个系统不是零件的简单堆砌,而是零件之间关系的总和。改变一个零件,可能影响整个系统的行为。
原理二:反馈原理
输出回输输入,比较偏差调节。负反馈趋稳,正反馈偏离。
这是控制论的灵魂。系统的输出被送回输入端,与期望值比较,偏差驱动调节。负反馈让系统趋于稳定,正反馈让系统加速偏离。
原理三:动态平衡(稳定性)
扰动中调节回归期望状态。
系统不是静态的,它会在扰动中不断调节,最终回归期望状态。稳定性不是"不动",而是"在动中保持平衡"。
原理四:最优控制
约束下寻找性能指标最优策略,设计即优化。
在给定约束条件下,找到让性能指标最优的控制策略。设计本身就是优化问题。
原理五:从工程到科学
实践反哺理论,经验抽象为原理。
工程实践中的经验,可以抽象为科学原理。理论指导实践,实践修正理论,循环往复。
方法论:还原与整体统一、定性定量结合、理论与实践循环。
适用范围:任何"感知 - 判断 - 调节 - 优化"的闭环系统。
03 Loop Engineering是什么?

Loop Engineering的核心定义:用你设计的系统替代你本人去提示Agent。
你不再是那个不断输入指令的人。你是那个设计循环结构的人。
具体来说,Loop由五个组件构成:
1. 自动化调度:让Loop自动触发、自动执行、自动停止
2. 工作树隔离:让多个Agent同时工作而不互相干扰
3. Skill:外部化的意图,让Agent有"记忆"
4. 连接器:让Agent能访问文件系统之外的资源
5. 子Agent:分离执行和验证,让系统能自我审查
加上一个记忆机制(状态文件),记录已做什么和下一步做什么。
现在,让我们用控制论的视角,重新审视这五个组件。
04 深度映射:控制论原理如何对应Loop设计
映射一:反馈原理 ↔ Loop的闭环迭代
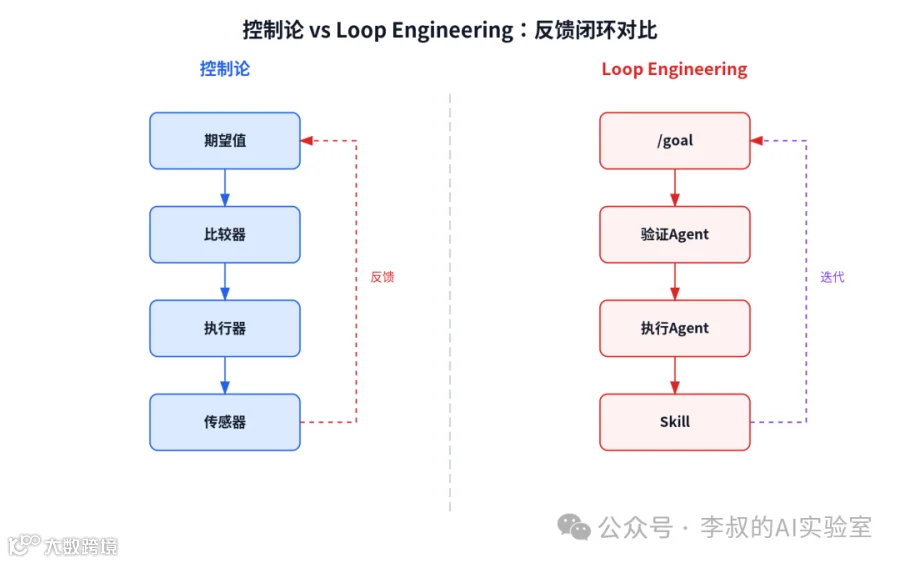
这是最直接的对应。
Loop的核心是什么?是闭环。
Agent执行任务 → 验证Agent检查结果 → 如果没达到目标,继续迭代 → 如果达到了,停止。
这就是控制论里的"负反馈":输出(代码质量)被反馈回输入端,与期望值(目标条件)比较,偏差驱动调节(下一轮迭代),直到误差归零(条件满足)。
对比一下:
关键区别在于:你不再手动调节,系统自己调节。
这就是为什么Loop比Prompt高级——它不是"更好的Prompt",它是"Prompt的控制系统化"。
用控制论的术语说:
-
Prompt Engineering是开环控制(你输入,AI输出,结束) -
Loop Engineering是闭环控制(你定义目标,系统持续调节,直到收敛)
映射二:系统观 ↔ 五个组件相互依赖
钱学森强调:系统不是零件的简单堆砌,而是零件之间关系的总和。
Loop的五个组件也是相互依赖的,缺少任何一个,系统就无法自洽。
举个例子:
-
没有工作树隔离,多个Agent会互相干扰,自动化调度就变成了"自动制造混乱" -
没有Skill,每次运行都从零推导项目背景,自动化调度就变成了"自动重复错误" -
没有连接器,Agent只能看到文件系统,无法真正行动,Loop就变成了"自动建议器" -
没有子Agent,执行和验证是同一个人,系统就无法自我审查,闭环就变成了"自欺欺人的闭环"
这五个组件不是"模块",它们是系统的要素。改变一个,会影响整个系统的行为。
这就是为什么"设计Loop"比"写Prompt"难——你不是在写一条指令,你是在设计一个系统。
映射三:动态平衡 ↔ /goal的收敛机制

钱学森说:稳定性不是"不动",而是"在动中保持平衡"。
Loop里的/goal就是这个原理的完美体现。
/goal不是按频率循环,而是一直跑到条件为真才停。每一轮结束后,一个独立的小模型负责判断是否已完成。
这意味着:
-
系统在持续迭代("动") -
每轮都在检查是否达到目标("比较偏差") -
如果没达到,继续迭代("调节") -
如果达到了,停止("回归期望状态")
这就是动态平衡:系统在扰动(代码bug、测试失败)中不断调节,最终回归期望状态(所有测试通过)。
更妙的是,这个过程是自适应的。如果第一轮就通过了,系统只跑一轮;如果需要十轮,系统跑十轮。系统不需要你预设"跑多少次",它自己知道什么时候该停。
这就是控制论里的"自适应控制"——系统根据反馈自动调整行为,直到达到目标。
映射四:最优控制 ↔ Skill固化约束
钱学森说:设计本身就是优化问题——在约束条件下,找到性能指标最优的策略。
Loop里的Skill就是这个原理的体现。
Skill是什么?是外部化的意图——项目约定、构建步骤、踩过的坑,写一次,每次运行都能读到。
从控制论的角度看,Skill就是约束条件。
它告诉Agent:
-
我们用什么架构(约束) -
不用什么架构(约束) -
构建步骤是什么(约束) -
曾经踩过什么坑(约束)
Agent在这些约束条件下,寻找最优解(写出最好的代码)。
没有Skill的Loop,Agent会用自己的推断填补你没说清楚的地方。它可能会选一个"技术上最优"但"项目上不可行"的方案。
有了Skill,Agent在约束内寻优,找到的是"项目上最优"的方案。
这就是控制论里的"约束优化"——不是找全局最优,而是在约束条件下找局部最优。
映射五:从工程到科学 ↔ Skill的复利增长
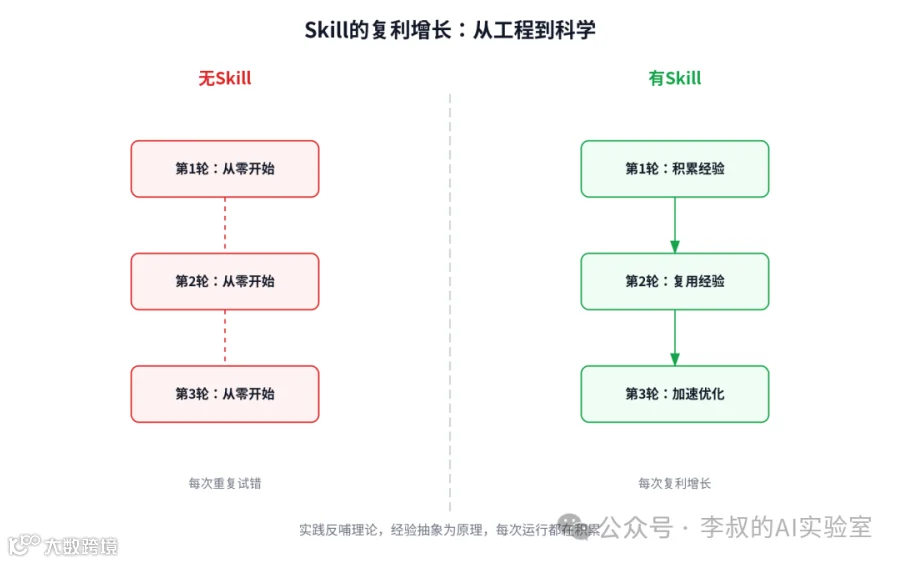
钱学森说:工程实践中的经验,可以抽象为科学原理。理论指导实践,实践修正理论,循环往复。
Loop里的Skill就是这个原理的体现——但它是自动化的。
每次Loop运行,Agent会遇到新的问题、踩到新的坑。这些经验被记录在Skill里(或者在状态文件里),下次运行时就能读到。
这就是"实践反哺理论":
-
实践:Agent执行任务,遇到问题 -
抽象:把经验写进Skill -
理论:Skill成为下次运行的指导 -
循环:下次运行时,Skill指导Agent避开同样的坑
更妙的是,这个过程是复利增长的。
没有Skill的Loop,每轮都从零推导你的项目;有了Skill,它是在累积经验。
这跟人类学习的本质是一样的:你不需要每次都重新发明轮子,因为你把知识写在了书里、画在了图上、记在了笔记里。Skill就是AI的"书"和"笔记"。
05 记忆机制:被忽视的"状态空间"
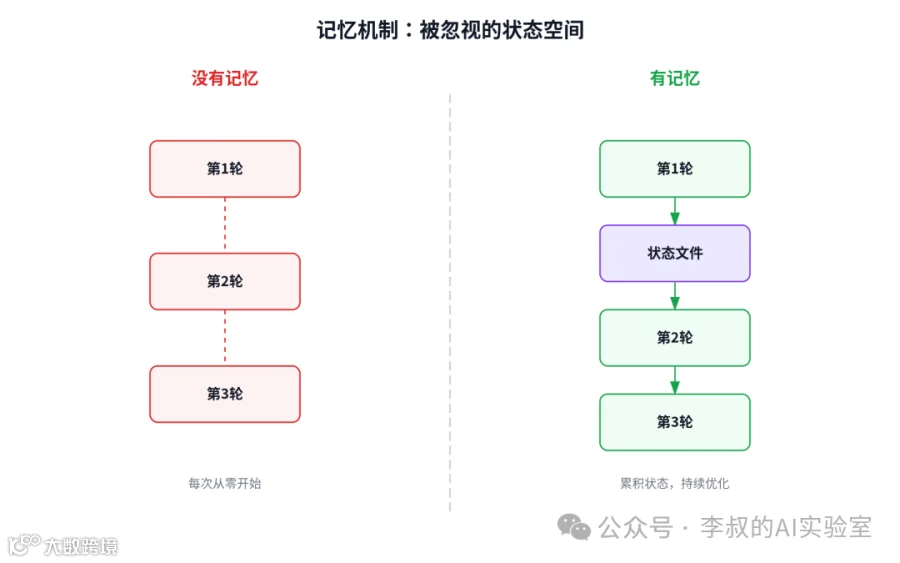
控制论里有一个重要概念:状态空间。
系统的状态,是描述系统在某一时刻所有相关信息的集合。知道当前状态,才能决定下一步怎么调节。
Loop里的记忆机制(状态文件),就是系统的"状态空间"。
它是一个markdown文件,或一块Linear看板,记录已做什么和下一步做什么。
没有记忆的Loop,每次都是从零开始——它不知道上一轮做了什么、哪些尝试失败了、哪些方向值得继续。
有记忆的Loop,是在累积状态。它知道哪些路走不通,哪些路有希望,下一轮应该往哪个方向探索。
这就是控制论里的"状态反馈"——系统根据当前状态决定控制动作。
06 为什么这个映射重要?

你可能会问:知道Loop对应控制论,有什么用?
用处很大。
第一,它说明Loop不是"新发明",而是控制论的自然延伸。
这意味着:控制论70年积累的理论、方法、工具,都可以用来指导Loop的设计。
你不需要从零开始摸索"怎么设计Loop"。控制论已经告诉你:
-
闭环比开环好(反馈原理) -
系统观比零件观好(系统观) -
动态平衡比静态稳定好(稳定性) -
约束优化比全局优化好(最优控制) -
经验抽象比重复试错好(从工程到科学)
第二,它提供了一个评估Loop设计质量的框架。
当你设计一个Loop时,可以用控制论的五个原理来检查:
1. 反馈原理:我的Loop是闭环还是开环?有没有验证机制?
2. 系统观:五个组件是否相互依赖?缺少任何一个会怎样?
3. 动态平衡:系统能在扰动中收敛吗?还是会在错误方向上加速?
4. 最优控制:Skill是否清晰定义了约束?Agent在约束内寻优吗?
5. 从工程到科学:经验是否在积累?还是每次都在重复试错?
第三,它揭示了Loop的真正风险。
控制论里有一个概念叫"正反馈失控"——如果反馈是正的(偏差越大,调节越强),系统会加速偏离,最终崩溃。
Loop也有这个风险。
如果验证子Agent太宽松("差不多就行了"),执行子Agent会越做越差,但系统会认为"已经完成了"。这就是正反馈失控——偏差越来越大,但系统认为在收敛。
解决方案是:验证必须严格,独立于执行。这就是为什么子Agent的设计如此关键。
07 实践意义:用控制论思维设计更好的Loop
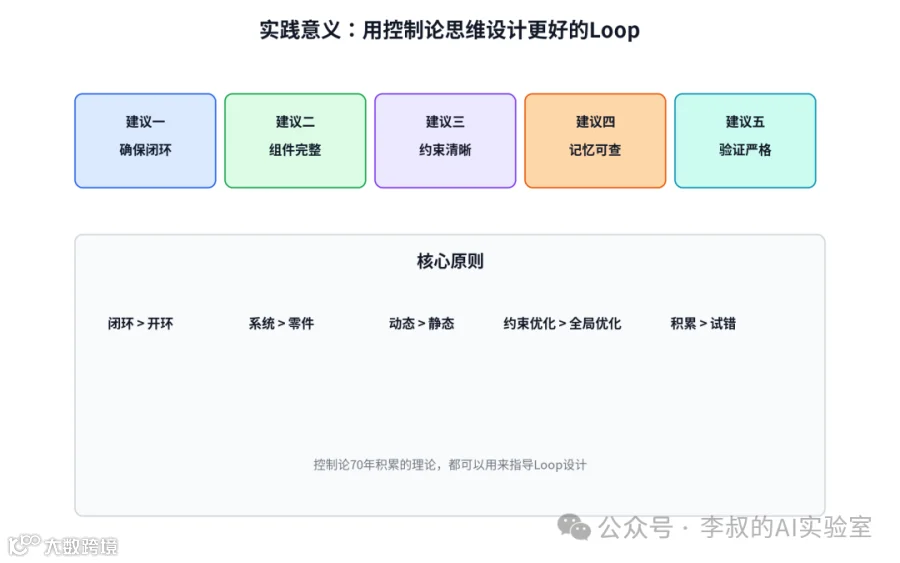
基于控制论的框架,我给你几个设计Loop的实操建议:
建议一:确保闭环,避免开环
如果你的Loop没有验证机制,它就不是Loop,它是"自动执行脚本"。
检查方法:你的Loop有没有独立的验证子Agent?验证标准是否清晰、可检验?
建议二:五个组件缺一不可
不要只关注"自动化调度"而忽略"Skill"或"子Agent"。五个组件是相互依赖的。
检查方法:如果去掉任何一个组件,系统还能正常工作吗?如果不能,说明你依赖它;如果去掉后系统"还能跑但质量下降",说明你需要它。
建议三:Skill要清晰定义约束
Skill不是"项目介绍",它是"约束条件"。
检查方法:你的Skill是否明确写了"我们用什么架构、不用什么架构"?是否写了"曾经踩过什么坑"?
建议四:记忆机制要可查询
状态文件不是"日志",它是"状态空间"。它必须可查询、可更新。
检查方法:你的状态文件是否能快速回答"上一轮做了什么、哪些尝试失败了、下一轮应该往哪个方向探索"?
建议五:验证必须严格,独立于执行
这是避免"正反馈失控"的关键。
检查方法:验证子Agent是否独立于执行子Agent?验证标准是否客观、可检验?
08 最后
2026年的AI编程,正在经历一场静悄悄的革命。
这场革命不是"AI取代程序员",而是"程序员的角色重新定义"。
从写代码的人,变成写Prompt的人。从写Prompt的人,变成设计Loop的人。
但Loop不是"新发明"。它是控制论在AI时代的自然延伸。
钱学森70年前推导出的原理——反馈、系统观、动态平衡、最优控制、从工程到科学——正在被2026年的AI工程师从实践中"重新发现"。
这不是巧合。这是理论与实践的循环。
理论指导实践,实践修正理论。控制论指导Loop设计,Loop设计反哺控制论。
这就是钱学森说的:"从工程到科学,实践反哺理论,经验抽象为原理。"
所以,当你设计Loop时,不要只关注"怎么配置、怎么调优、怎么省钱"。
用控制论的思维,设计一个真正自洽的系统。
因为最终决定产出质量的,不是模型,不是工具,而是你——那个站在系统外面,设计整个循环结构的人。
参考:
- 钱学森《工程控制论》(1954)
- Addy Osmani对Loop Engineering的系统整理
- Lance Martin的Claude Fable 5实验
如果觉得有用,转发给你那个还在一句一句跟AI聊天的朋友。
李叔 — 一名 AI 技术实践者,专注于探索 LLM 与传统系统的深度集成,让 AI 真正为你干活。