


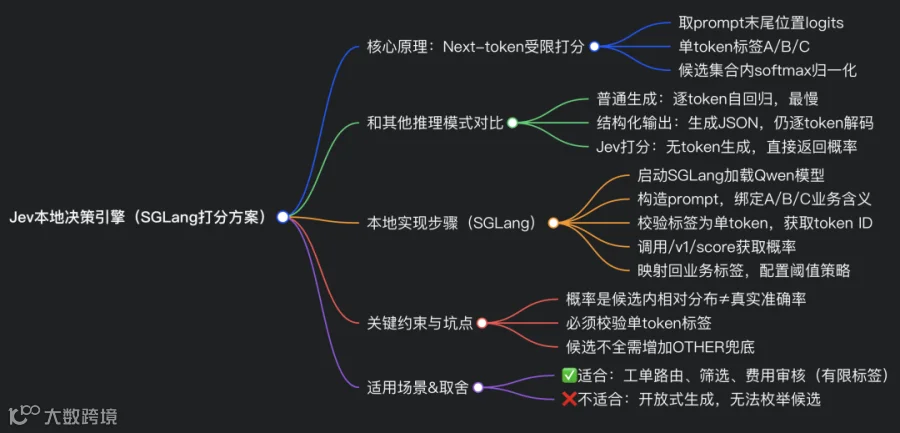
编者摘要:本文介绍如何基于 SGLang 在本地复刻 Jev 决策引擎,无需大模型微调,核心是next-token 候选打分,适用于选项预先已知的分类路由场景。常规 LLM 自回归生成、结构化输出都需要逐 token 生成文本;而 Jev 风格打分仅读取 prompt 末尾位置的 logits,只对预设单 token 标签做受限 softmax,直接返回各选项概率分布,省去解码循环,大幅降低延迟。
实现上使用 A/B/C 这类单 Token 标签规避多短语分词不一致问题,借助 SGLang /v1/score接口完成打分。需要校验标签必须为单个 token,候选不全时增加 OTHER 兜底。实测对比显示,打分链路 GPU 开销更低、响应更快,但概率仅代表候选集合内相对偏好,不等于真实预测准确率,需要标注数据集做概率校准。
适用边界:候选集合可枚举时用打分;输出内容未知、选项无法穷举时,仍要使用结构化或普通生成。该方案仅复刻推理链路,不含 Jev 原生的 RLCD 训练、模型校准模块。
10 个关键问题 Q&A
- Jev 是什么?本文复现了 Jev 的全部能力吗?
Jev 是闭源 LLM 决策引擎。本文只复刻它打分推理链路,不包含 Jev 的 RLCD 训练、模型校准等完整系统。 - Jev 打分和结构化输出最核心区别?
结构化输出仍然逐 token 生成 JSON 文本;Jev 打分不生成任何 token,直接读取候选标签 logits 做受限 softmax。 - 为什么要用 A/B/C 单 token 标签,不直接对 “billing” 短语打分?
短语可能被分词拆成多个 token,不同分词器结果不一致;单 token 标签固定在同一个输出位置,打分逻辑稳定。 - 0.91 概率代表模型预测这件事有 91% 正确率吗?
不是。仅代表在给定候选集合内,模型对该选项的相对偏好,需要标注数据集做校准,才能评估真实准确率。 - SGLang /v1/score 接口的作用是什么?
输入 prompt 与指定 token ID,执行一次模型前向推理,提取对应 logits 并 softmax,直接返回候选概率分布。 - 什么场景适合 Jev 风格打分?
业务输出候选集合预先可枚举,只需要分类标签 + 置信分布,不需要生成新文本:工单路由、简历筛选、单据分类。 - 候选列表无法覆盖全部情况该怎么办?
增加 OTHER/ESCALATE兜底选项,避免模型强制在错误候选集合分配全部概率。 - 打分方案相比普通 LLM 生成,性能优势在哪?
省去自回归循环,一次前向推理即可拿到结果,显著降低推理延迟,GPU 资源消耗更少。 - 业务如何利用返回的概率分布做自动化策略?
在代码中设置阈值,例如最高分 > 0.8,领先第二名≥0.2;满足条件自动执行,不满足则转入人工复核。 - 打分方案可以完全替代 LLM 文本生成吗?
不能。仅适用于候选可枚举场景;开放式写作、无法提前列出选项的场景,仍需结构化输出或原生文本生成。
本文将介绍如何把开源大模型改造成高速本地决策引擎,全程无需对模型重新训练。内容涵盖下一个 token 打分、带概率分布的固定选项选择、SGLang,还提供在同一模型上,与标准文本生成做实操基准对比。
很多大模型调用场景,根本不需要生成新文本。应用端已经知道所有可能的答案,只需要模型从中选出其一。
举个例子,一条客服工单写着:“同一笔订阅被扣了两次费用。”应用需要把这条工单路由给三个团队之一:账单团队、技术支持、账号权限团队。
常规大模型调用,是让模型生成一段回答。返回内容可能是一句话、标签或者 JSON 对象。应用需要等待文本生成完毕,再做解析,提取出选中的团队。
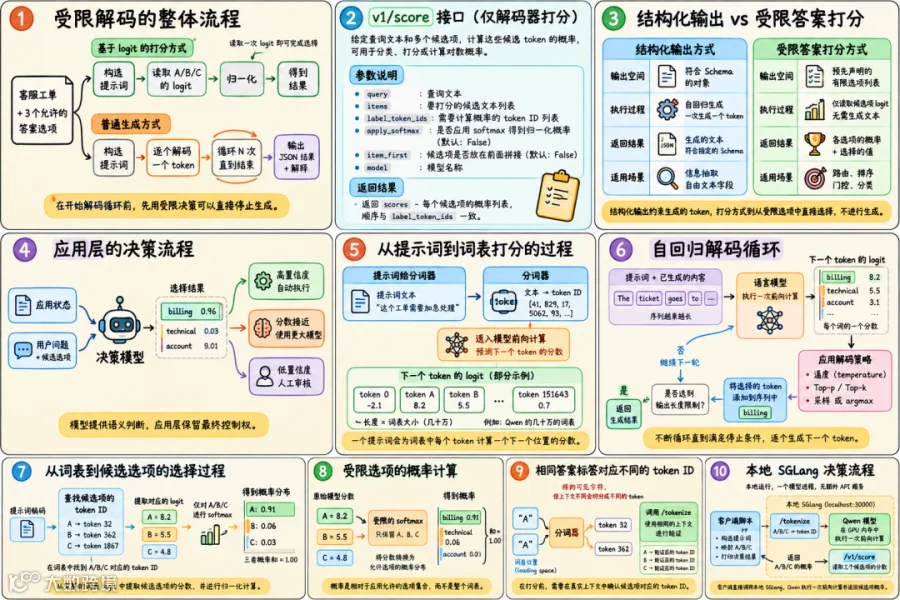
如果所有合法答案本来就是已知的,这套流程就完全没必要。 实际上有一种更高效的实现方式:把这次请求当成一次决策,这正是 Jev 的核心思路。应用传入工单 / 查询语句 + 全部允许选项,Jev 一次性返回每个选项的打分(下文会详解实现原理):
账单团队    0.91
技术支持    0.06
账号权限    0.03
这里概率最高的账单团队被选中;业务代码还能看到模型做出这个选择的置信强度。
我们接下来就在本地复现 Jev 的这套行为:输入查询与可选选项,单次打分请求直接返回决策结果与概率分布,不生成任何句子或 JSON。
虽然 Jev 本身是闭源产品,但这套推理范式在不少开源大模型上都可以实现。 具体方案:基于 SGLang(调用/v1/score接口)实现,使用 Qwen、DeepSeek 模型测试,并和结构化输出、普通文本生成做对比。
先说明预期:本文复现的是推理链路,不是完整的 Jev 系统。Jev 本身还包含模型训练与校准环节,单纯打分接口并不具备这部分能力。
固定选项打分 ≠ 结构化输出
很容易把 Jev 机制和结构化输出混淆 —— 二者都限制返回内容,但推理服务内部的工作方式完全不同。
还是上面这条客服工单的例子。结构化输出会得到类似下面的结果:
{"team": "billing"}
指定的 JSON schema 只是保证返回合法对象,模型本身并不是直接 “选出” 团队。底层仍然是逐 token 生成:先输出左大括号、字段名、字段值、右大括号,一步步自回归解码。生成完成后,应用再读取 team 字段。
而 Jev 采用的打分模式:应用直接提供 3 个团队作为全部合法候选结果。推理服务读取每个候选结果对应的模型打分,直接返回前面那种概率分布,完全不生成 JSON 对象。
我们可以一次性返回全部 3 个选项分值,而不是只返回 “账单团队”,业务代码就能区分两种完全不同的场景:
结果1        结果2
账单团队 0.91   账单团队 0.46
技术支持 0.06   技术支持 0.44
账号权限 0.03   账号权限 0.10
两种情况都会选出账单团队。 但第一种模型偏好非常明确;第二种两个分值几乎持平。业务就可以设定策略:结果 1 自动流转工单,结果 2 交给人工复核。
模型只输出这些分值,下游业务规则由业务代码定义。 举例规则:最高分选项概率必须大于 0.80,且领先第二名至少 0.20。这类阈值写在代码里,方便测试、随时调整。
注意:0.91 的含义,是在这 3 个候选集合内,账单分配到 91% 的概率质量,不等于模型预测这件事本身有 91% 正确率。想要评估真实准确率,需要带标注数据集,这就是后文会讲到的校准问题。
一句话区分:结构化输出是生成合法文本对象;固定选项打分,返回的是应用预先定义好的候选集合上的概率分布。
大模型如何生成首个输出 token
在讲解如何把因果大模型改成 Jev 风格决策引擎前,先理解普通大模型生成的底层步骤:
-
分词器把提示词(prompt)转为 token ID 序列 -
模型处理序列,为下一个位置输出一个向量 -
向量长度等于词表大小:比如 Qwen 词表有数万个 token,向量就包含数万个数值。这些原始数值叫做logits(对数几率)。logit 数值越大,模型越倾向把这个 token 作为下一个输出;logit 本身还不是概率。
常规生成流程:推理服务根据解码参数(temperature 等)处理这个向量,选出一个 token,追加到 prompt 后面。模型再为下一个位置生成新词表向量。循环自回归解码,直到遇到停止符或达到输出上限。
但做有边界的决策任务时,我们只关心第一个位置的向量。
回到客服路由例子,允许三个选项: 账单团队、技术支持、账号权限
我们在 prompt 里给每个选项分配简短标签:
A = 账单团队
B = 技术支持
C = 账号权限
prompt 末尾要求只返回一个标签:
将客服工单归入唯一分类。工单:同一笔订阅被扣了两次费用。 可选标签: A = 账单团队 B = 技术支持 C = 账号权限 仅返回标签。标签:
标签:是 prompt 的最后一段文本。下一个位置,就是模型本来要生成 A/B/C 其中一个 token 的位置。
模型处理完 prompt 后,照常输出该位置、完整词表维度的向量。向量里包含 token A、B、C 对应的 logit,以及词表里所有其他 token 的 logit。
打分链路只做 4 步操作:
-
获取 A、B、C 对应的 token ID -
从词表向量中取出这三个位置的 logit 值 -
忽略其余全部 logit -
对这三个选中的值做 softmax 归一化
举个例子:取出 logit 分别为 8.2、5.5、4.8;在三者范围内做受限 softmax,得到约 0.91、0.06、0.03。再映射回账单、技术支持、账号权限。
⚠️ 归一化仅限定在指定候选集合内。不是 A 在全部数万词表里有 91% 概率;而是在应用已经排除所有其他答案后,模型在 A/B/C 三者之间的偏好分布。
这套操作 SGLang 已经内置,接口就是/v1/score。它会跑一遍 prompt,读取指定 token 位置,直接返回打分,不用修改 Qwen 源码、手动提取张量。
补充:为什么用 A/B/C 标签,而不是直接对billing、technical support这类文本打分? 因为一个可见单词不一定是单个 token。 比如billing在一个分词器里是单 token,换另一个分词器可能拆成多个 token;technical support一定会被拆成多个 token。 如果直接对短语打分,就需要序列打分:先对第一个 token 打分,追加 token,继续打分,再合并整条短语的分值,短语长度也会干扰对比结果。
而单 token 标签规避这个问题:每个选项只用同一个输出位置上的单个词表条目代表,语义描述写在 prompt 里。
A = 账单相关问题与扣费异常
B = 产品报错与技术故障
C = 登录、密码与账号访问问题
模型在读取 prompt 时看到完整语义;我们后续只读取标签这个 token 对应的 logit。
但必须校验每个标签确实是单个 token。 分词器经常会把前置空格编码进 token,"A"和" A"是完全不同的 token ID。 聊天模板也可能在答案位置前面自动插入空格、特殊控制 token。
规避方法:使用模型原生 chat 模板渲染完整 prompt,确定答案位置预期的接续文本;调用/tokenize接口校验。如果标签分词后不是单个 token,直接舍弃该标签。
这套标签映射逻辑放在打分客户端内部。应用对外传入的是业务语义选项(账单、技术支持),不会传递 token ID,也不会收到 A/B/C,上层 API 完全和底层 token 标签解耦。
最后,如果候选列表无法覆盖全部情况,需要增加兜底选项。 例如安全事件工单进来,但路由选项只有账单 / 技术 / 账号权限,受限 softmax 仍然会把全部概率分配给这三个错误选项。 解决方案:增加OTHER或ESCALATE兜底选项。

使用 SGLang 搭建本地打分推理服务
本地示例只需要一套推理服务:SGLang 把 Qwen 加载进显存,对外提供 HTTP 接口;Python 客户端直接请求服务。
完整流程:
-
SGLang 启动 Qwen 模型服务 -
用字母标签编写决策 prompt -
调用接口把标签转为 token ID -
调用 /v1/score单次打分请求 -
将返回概率映射回业务选项
步骤 1:SGLang 启动 Qwen 模型
创建 Python 环境,安装依赖:
python3 -m venv .venv
source .venv/bin/activate
pip install "sglang[all]==0.5.10.post1" "requests==2.34.2"
启动模型服务:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-0.5B-Instruct \
  --host 127.0.0.1 \
  --port 30000
首次启动会从 Hugging Face 下载模型;后续启动复用本地缓存。加载完成后,Qwen 常驻显存,SGLang 监听 30000 端口。运行下面客户端脚本时,这个 SGLang 进程必须保持运行。
步骤 2:定义选项、构建 Prompt
新建decide.py:
import json
import requests

BASE_URL = "http://127.0.0.1:30000"
MODEL = "Qwen/Qwen2.5-0.5B-Instruct"

choices = {
    "A": "billing and payments",
    "B": "technical support",
    "C": "account access",
}

ticket = "I was charged twice for the same subscription."
choice_lines = "\n".join(
    f"{label} = {meaning}" for label, meaning in choices.items()
)

prompt = f"""Ticket: {ticket}
Question: Which category matches the ticket?
Allowed labels: {choice_lines}
Return only the label. Label: """

print(prompt)
字典保存答案的两层表达:A 是用来打分的 token;billing and payments是返回给应用的业务含义。分词、打分、结果映射全程顺序不能乱。
生成的 prompt 原文:
Ticket: I was charged twice for the same subscription.
Question: Which category matches the ticket?
Allowed labels: A = billing and payments
B = technical support
C = account access
Return only the label. Label:
prompt 停在Label:,我们要获取紧接着这个位置模型输出 token 的打分,不要求 SGLang 生成 token。
步骤 3:解析标签对应的 Token ID
在代码下方追加:
label_token_ids = []

for label in choices:
    response = requests.post(
        f"{BASE_URL}/tokenize",
        json={
            "model": MODEL,
            "prompt": label,
            "add_special_tokens": False,
        },
        timeout=30,
    )
    response.raise_for_status()
    token_ids = response.json()["tokens"]

    if len(token_ids) != 1:
        raise ValueError(
            f"{label!r} is not a single token: {token_ids}"
        )

    print(f"{label!r} -> {token_ids}")
    label_token_ids.append(token_ids[0])
SGLang 的/tokenize返回 Qwen 分词器输出的整数 token ID。如果标签分词后是多个 token,直接抛出异常。打分接口要求每个选项对应单个词表位置。
Qwen/Qwen2.5-0.5B-Instruct 运行输出示例:
'A' -> [32]
'B' -> [33]
'C' -> [34]
每个标签只对应单个 token。后续打分就读取词表 32、33、34 位置。 这个校验也规避一个坑:不同模型分词规则不一样,在 Qwen 上可用的标签,换模型可能被拆成多 token。
步骤 4:调用 SGLang 获取三个选项概率
继续追加打分请求代码:
response = requests.post(
    f"{BASE_URL}/v1/score",
    json={
        "model": MODEL,
        "query": prompt,
        "items": [""],
        "label_token_ids": label_token_ids,
        "apply_softmax": True,
    },
    timeout=120,
)
response.raise_for_status()
score_response = response.json()

print(json.dumps(score_response, indent=2))
scores = score_response["scores"][0]
query:完整 prompt items为空字符串:代表对 prompt 末尾紧接着的位置打分 label_token_ids:指定从 Qwen 词表里读取哪几个 token 分值 apply_softmax:把取出的 logit 归一化成概率
items数组只有一项,所以返回的 scores 列表只有一组分值。在相同 Qwen 权重上运行,得到返回示例:
{
  "scores": [
    [
      0.67776233,
      0.310878605,
      0.011359035
    ]
  ]
}
这三组分值顺序和label_token_ids一一对应:A、B、C。softmax 之前原始 logit 为 25.277620, 24.498226, 21.188837;硬件、精度设置不同会有微小数值差异。
步骤 5:标签转回业务决策
补全映射代码:
probabilities = {
    choices[label]: float(score)
    for label, score in zip(choices, scores, strict=True)
}

decision = max(probabilities, key=probabilities.get)

print(
    json.dumps(
        {
            "decision": decision,
            "probabilities": probabilities,
        },
        indent=2,
    )
)
新开终端运行脚本 python decide.py,输出:
{
  "decision": "billing and payments",
  "probabilities": {
    "billing and payments": 0.6777623295783997,
    "technical support": 0.31087860465049744,
    "account access": 0.011359035037457943
  }
}
SGLang 在/v1/score内部完成全部计算:一次模型前向、标签分词、返回概率。 本例中账单团队胜出,但概率仅 0.678。如果业务策略阈值要求 0.7,这条工单就会转入人工复核。阈值需要在标注数据集上评估确定。
打分推理 vs 自回归生成:延迟实测
上面单请求示例演示原理。作者还搭建测试程序,大批量评估两种模式的表现。
这套演示支持多款开源模型:Qwen3 4B、Qwen2.5 0.5B /1.5B、SmolLM2 1.7B、TinyLlama 1.1B、DeepSeek-R1-Distill-Qwen 1.5B。
Jev 风格打分链路调用决策接口:
result = engine.decide(request)
answer = result["answers"]["decision"]
choice = answer["choice"]
probabilities = answer["probabilities"]
decide()内部,SGLang 接收/v1/score请求,附带 A/B/C 的 token ID。SGLang 执行 prompt 前向,读取三个下一个 token 分值,归一化,到此结束,不生成任何 token,直接返回结果。
标准生成链路,调用同一引擎的生成接口:
result = engine.generate_response(
    case["state"],
    case["question"],
    list(case["criteria"].items()),
    max_tokens=32,
)
同样上下文、问题、候选选项,请求/v1/chat/completions。Qwen 自回归生成回答和简短解释,最多 32 token。应用在前 100 个字符内提取匹配选项;提取标签和标准答案一致则判定正确。
作者用本地固定数据集 100 条样本做仿真测试,场景包含客服工单路由、候选人筛选、费用审核。标注真值可以同时统计速度与准确率。
SGLang 远端测试采用双线程同步启动:
starting_line = threading.Barrier(2)

def worker(lane, runner):
    starting_line.wait()
    for case in cases:
        updates.put(runner(case))

workers = [
    threading.Thread(target=worker, args=("jev", run_jev)),
    threading.Thread(target=worker, args=("llm", run_llm)),
]

for worker_thread in workers:
    worker_thread.start()
Barrier 屏障保证两个工作线程同时开始。两条链路依次处理样本;Jev 打分线程完成一个请求立刻发起下一个;标准生成线程同理。
两条链路并行运行,但不会一次性并发全部 200 个请求。SGLang 接收两边并发请求,通过连续批处理调度,两套请求共享同一张 GPU、显存带宽与调度器。
注:演示视频 8 秒后做了倍速加速,所以 LLM 生成请求看起来很快。 两条链路同时启动,使用 Qwen/Qwen3-4B-Instruct-2507,共用一套 SGLang 服务。
如何选择合适的方案
打分不能完全替代文本生成。Jev 这套范式,只适用于推理前输出空间就已经确定的场景。
适合打分的业务特征:
-
输出是有限、有明确含义的标签集合 -
每个标签对应不同下游动作 -
调用方只需要标签 + 概率分布,不需要生成新文本
结构化输出是另一种方案:它定义返回文本的语法格式,解码器仍然逐 token 生成字段名和值。 当候选取值无法提前枚举,就适合结构化生成;打分只有候选全集已知时,才能跳过自回归解码。
一张图对比三种模式:常规 LLM 解码、结构化输出解码、Jev 风格打分。
选择思路,一句话总结:
推理前不知道输出内容 → 使用生成; 输出候选集合已知,只需要做选择 → 使用打分。此时第一个 next-token 向量就包含排序结果,直接返回,省去不需要的自回归循环。
再次强调:本文项目复现的是Jev 风格推理机制,不是 Jev 完整权重、RLCD 训练流程、评估平台。作者后续会继续讲解这部分底层技术。 敬请期待!
关键术语对照表
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|