

现在的模型越来越多了。不管是 OpenAI 还是 Anthropic,同一个系列里往往有好几款模型,而且每款模型还有不同的推理级别。
这对很多人来说,怎么选就变得非常困难。
所以大部分人用的时候,可能根本不去选,从头到尾都用同一个模型。这样不仅没有发挥出模型的最佳性能,往往还消耗了更多的 token。
OpenAI 官方也意识到了这个问题,所以前两天专门发了一份 GPT-6 使用指南,教大家怎么选模型。
01 三款模型,怎么分工
先看官方给的定位和标价。
|
|
(美元) |
(美元) |
(美元) |
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
这张表列的是 OpenAI 目前 GPT-6 系列三款主要模型的价格,以及官方对它们的定位。
官方说得很明确。目标明确的日常重复性工作,比如提取发票字段、对请求分类、生成结构化摘要,用最便宜的 Luna 就行。
我的理解是,那些不需要思考、只需要执行的事,有 Luna 就够了。
更复杂的编程、研究和计算机使用任务,除了执行,还要一定的思考能力,用 Sol 比较合适。
目前 GPT-6.1 Sol 应该算是性价比最好的一款,官方说它的智能水平接近 Astra,价格只有 Astra 的五分之一。
最厉害的当然是 Astra,但大家都知道,它的 token 消耗量也非常大。所以最难、最需要推理的事,才用 Astra。
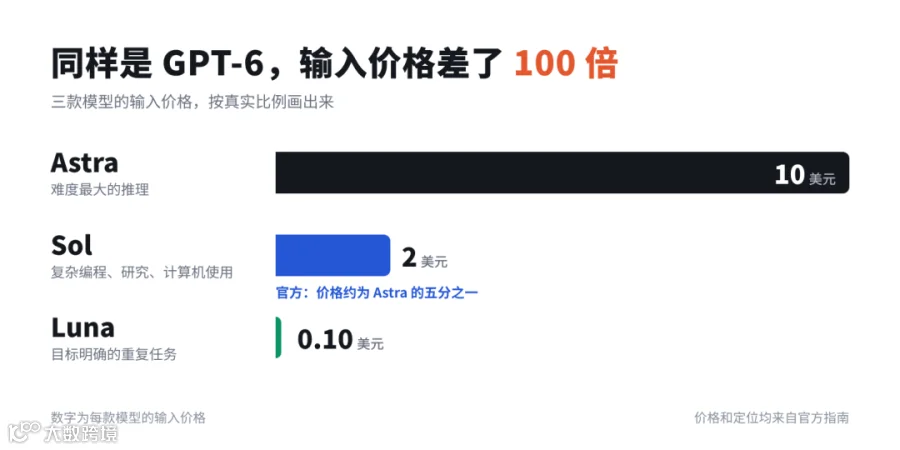
▲ 图:三款模型分工示意
之前 AI 给过我一个建议:在我的日常工作里,最多只有 5% 的任务需要用到 Astra。绝大部分用 Luna 就能完成,剩下的交给 Sol。
02 推理强度,别一上来就开满
选完模型,还要选推理级别,也就是让模型花多少力气去想。官方给了四档:
-
低:提取事实、小改动这类活。 -
中:需要判断的活,比如规划功能、比较几个方案。 -
高:高难度调试、深入分析、细致审查。 -
极高或 Max:“高”还不够的时候再试。只有效果提升抵得过多花的时间和钱,才继续用。
最后一档官方说得很克制,意思就是别默认开。
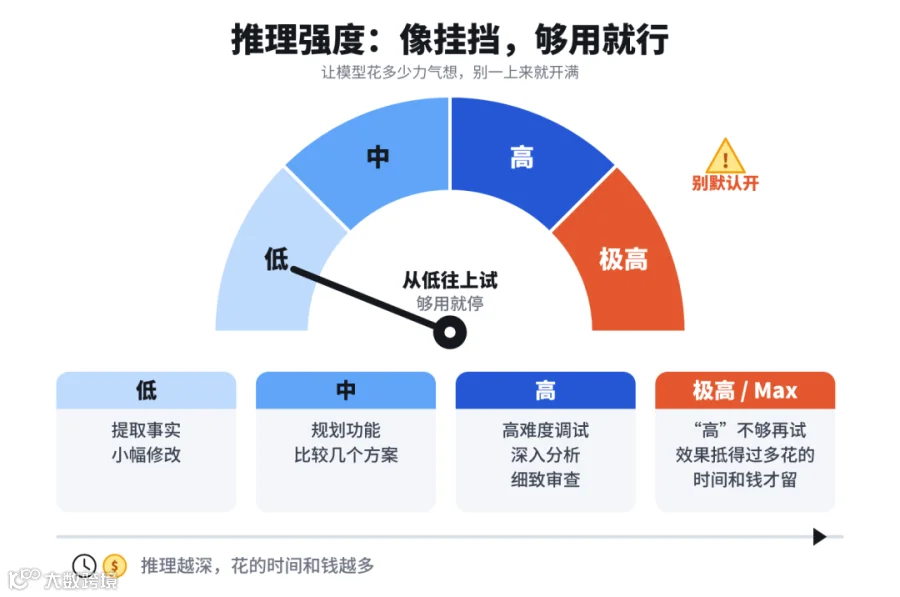
▲ 图:推理强度四档阶梯
在 API 里,对话中途可以调整推理强度,缓存不会失效。在 Codex 里,先用模型的默认级别,简单任务往下调,要深入分析再往上调。
速度也是要花钱的。
API 里有个快速模式,响应更快更稳,但每个 token 更贵。官方建议用在聊天应用、编程工具这类对响应时间要求高的场景。
还有个超高速模式,Codex 和 API 都能用,生成速度更快,推理强度不变。官方说它适用于 Astra,适合需要快速迭代代码、更快的响应值得多花钱的时候。
03 提示词:写少一点
这一点很多人会觉得反直觉,其实很好理解。
我们原来学的提示词写法,总是教我们写得越详细、越具体越好。但这种教法是建立在以前的模型还不够智能的前提上。
现在的模型能力远远超过了之前,我们不能再拿教小学生的那一套去教一个博士生。
OpenAI 开发者体验团队的 Eric Provencher 说,模型理解细微差别和模糊含义的能力已经大幅提升,过去有帮助的详尽指导,如今反而可能妨碍模型发挥。
对新模型来说,最重要的是先把任务说清楚:你想要什么结果,面向谁,有哪些相关的上下文和限制,怎样才算完成。老的写法,也要跟着模型的能力一起更新。
就像我之前介绍 Anthropic 时说的那样,我们也可以从下面四个方面去更新。这四点,官方摘自另一篇《重新思考 GPT-6 Astra 的技能与提示词》:
-
技能:用一句短描述写清什么时候用。补充细节等需要时再加载,不要写死操作步骤。 -
AGENTS.md:写清哪些文档和测试适用于哪些情况。安全的常规流程直接授权,比如用一次性数据跑本地测试,不碰生产环境。 -
决策边界:说清哪些事它可以自己定,哪些要你批准。别一刀切写成“始终先询问”。 -
做到底:定义什么叫完成,包括改完、跑通、检查结果、修掉问题。再说明哪些决策要你来审。
输出这边,官方的例子是:模型可以自己决定摘要怎么组织,但改项目范围之前要先问你。回复用通俗语言,技术细节贴合读者,最后带一段简短的交接说明:改了什么,查了什么,还剩什么。
04 长任务:中途能改,也能干别的
官方说,GPT-6 系列可以处理持续数小时甚至数天的任务。
对这种长任务,如果还像普通对话那样一轮一轮来,等它做完再进行下一轮,就会浪费大量 token。因为在它做的过程中,你可能会冒出新想法,或者想纠正点什么。这时候你不用等它结束,中途就可以让它调整。
OpenAI 明确了一些可以用的能力。API 这边有三个:
-
轮次中途引导:模型干活的时候,你可以通过 Responses WebSocket API 发纠正信息。更新会进队列,不会取消正在跑的工具,也不会撤销已经做完的操作。 -
异步工具调用:应用在跑测试这种慢任务时,模型可以先去做别的独立工作。依赖测试结果的部分,等结果回来再开始。 -
多智能体:GPT-6.1 Sol 能通过 Responses API,把独立的活分给子智能体,比如各查代码库的一块,最后汇总。这个功能还在测试阶段。
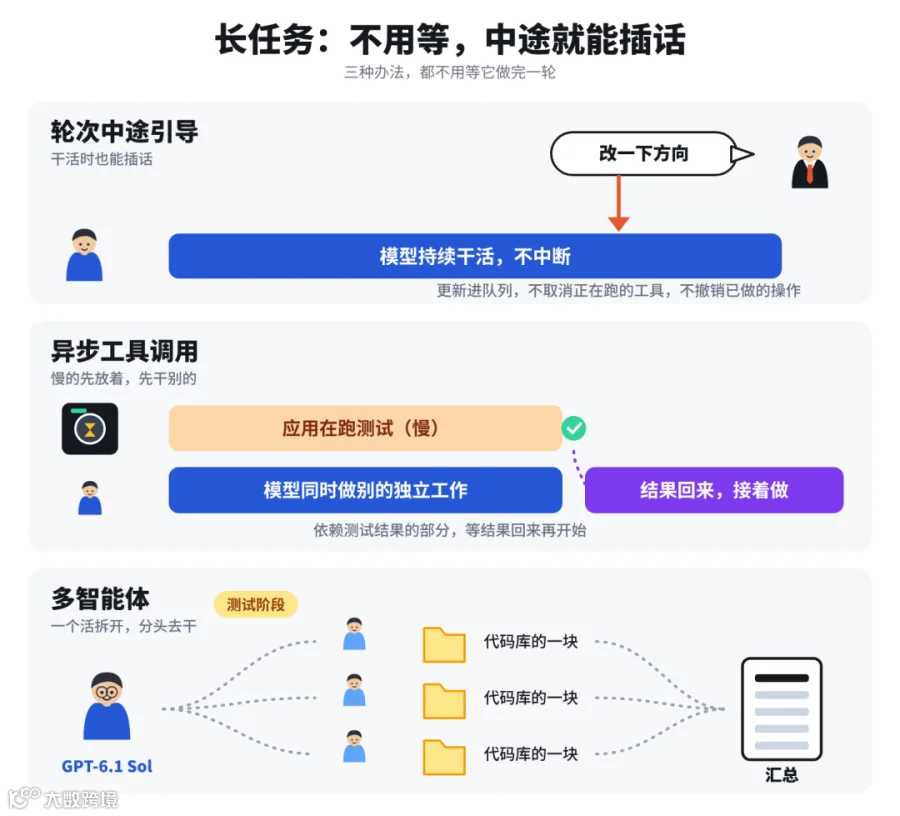
▲ 图:长任务三种方式的时间线对比
长时间运行的任务,中途可能遇到需要你决策的事,而这种事很难在最开始的提示词里就想到、写明白。所以过程中也可以做澄清和引导。Codex 这边有两个:
-
边做边问:GPT-6 Astra 在 Codex 里可以中途请求澄清。你要离开的话,先说清哪些任务可以继续,什么时候该停下来等你。 -
改方向:需求变了,就用新信息引导当前任务,说明什么要改,什么不动。省得它在一个已经不对的方案上继续耗。
05 计算机使用:能走 API 就别点屏幕
自从 Astra 出来之后,计算机使用就变得非常流行。我也经常用,很多默认的任务,最后也会借助它来完成。但用过的人都知道,这种操作非常费 token。
三款模型都支持计算机使用,可以直接操作网站和桌面应用,没有 API 也行。官方举的例子是:让模型调查一个缺陷,改完代码,再打开你的产品,在浏览器里确认修好了没有。
那到底哪些任务该用?我自己一直也有点好奇。官方的原则是选最简单可靠的路:
-
API 或者已连接的工具能直接办,就用它们。 -
要读屏幕、点按钮、填表单的时候,才用计算机使用。
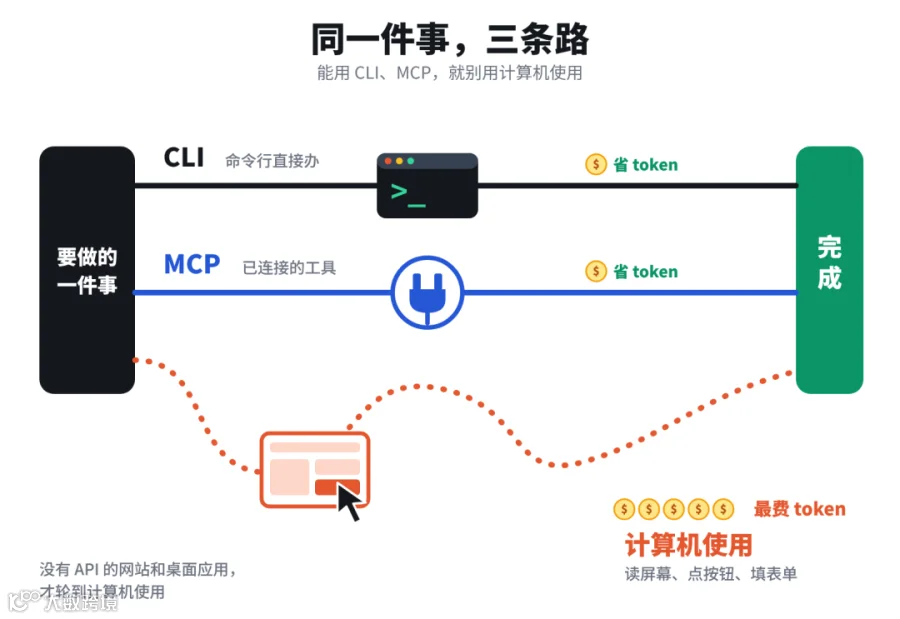
▲ 图:计算机使用决策流程
这其实已经说得很直白了:能不用就尽量不用。我自己也一样,现在能通过 CLI、MCP 解决的,绝对不会用计算机使用。
如果你要自己做集成,就给模型一个能跑代码的工具来控制浏览器或桌面。官方点名了两个:浏览器用 Playwright,桌面应用用 PyAutoGUI。
06 上线前:缓存和测试
省钱方面,官方最看重提示词缓存。缓存输入的费用,比未缓存的输入最多低 95%,具体看模型。回头看上面的表,三款模型的缓存价,都是各自输入价的十分之一。
想用好缓存,有两个条件:
-
固定的指令和参考资料,放在会变的任务细节前面。 -
工具定义保持一致。
这里我举个例子,不然不太好理解。
假设你做了一个合同审核助手。每次来一份新合同,你都要先给模型一大段审核规则,再把这份合同交给它。
审核规则每次都一样,合同每次都不一样。
规则放前面、合同放后面,从第二份合同开始,前面那一大段一模一样的规则,就可以直接按缓存价算,只有新合同按原价。官方标价里,缓存价是原价的十分之一。
反过来,合同放在最前面,开头每次都不一样,后面的规则就复用不上了。这就是官方要求“固定的放前面”的原因。
07 像分配员工一样分配模型
我经常听到读者朋友说,套餐额度消耗太快了。我曾经也这么觉得。我的习惯是不管什么任务,都用最好的那个模型。但摸索了一段时间之后,我发现自己的用法大错特错。
可能很多朋友跟我一样,都用最好的模型,从来不选推理级别,都用默认的,更搞不清楚什么叫快速模式。
其实理解起来很简单。你是一个 Manager,手下有三个能力各不相同的员工。任务来了,你肯定会按难易程度分给他们,对吧?如果把所有任务都丢给你认为最强的那一个,肯定不合适。
希望这篇文章对你有所帮助。
08 参考资料
01|OpenAI:GPT-6 系列模型指南(2026 年 10 月 2 日)
https://openai.com/zh-Hans-CN/index/practical-guide-building-gpt-6/