

AI能读懂DNA已经不新鲜了。但当有人提出要让AI「写」DNA——从零生成一段自然界不存在的基因组时,几乎没人相信这条路走得通。
在Latent Space的「AI for Science」系列中,主持人Brandon Anderson(在Atomic AI做RNA药物)与RJ Honicky(MiraOmics联合创始人兼CTO)对话了Radical Numerics联合创始人兼CEO Eric Nguyen——HyenaDNA的第一作者,也是Evo的共同第一作者。
Eric讲了一段六个月的挫败:他挨个问斯坦福的科学家「如果我能生成DNA,你会拿它干什么」,聊过的几乎每个人都觉得这是蠢主意。他还是固执地训了一个大模型,第一个checkpoint丢到蛋白质基准上,居然能和蛋白质专用模型掰手腕——而他从没告诉过模型什么是蛋白质。
这场对话还聊到了另一件事:一个擅长生成的模型,反过来也特别擅长判断一段序列是不是致病。所以做设计的人,必须同时做防御。

左:RJ Honicky,中:Brandon Anderson,右:Eric Nguyen
01
从「读DNA」到「写DNA」

Eric最早做的是「读DNA」。他做出HyenaDNA,用卷积替代注意力,把上下文推到100万碱基。但在他之前,DNA模型的上下文只有一两千个碱基。
他接着想做的是「写DNA」,为此花了六个月到处游说。
“我花了六个月到处跟人说,如果我能生成DNA,你觉得有用吗?结果离谱的是,斯坦福我聊过的几乎每个科学家都觉得这主意很蠢。”
质疑也很一致:人类自己都没搞懂规则,凭什么指望AI学会?你连对错都判断不了,怎么告诉AI这个对那个错?
Eric没有正面反驳,只是「特别犟,觉得能生成DNA一定有用武之地」。Arc Institute出钱买了GPU,让他们这帮「疯孩子」试试。
第一个结果让他起鸡皮疙瘩:有人拿第一个checkpoint去跑蛋白质基准ProteinGym,居然能和蛋白质专用模型打得有来有回。后来他们做出Evo,用它的新CRISPR-Cas系统登上了Science杂志;再后来,第一次用AI从零生成了一个基因组——一个约6000碱基对的噬菌体。有意思的是,Eric说这个噬菌体基因组其实是另一个团队用Evo做的——他讲这件事时,重点不在谁做的,而在它能生成一个有功能的完整基因组意味着什么。
RJ追问:如果真把这件事做好,有哪些是实验室做不到的?Eric的答案是跨模态协同设计CRISPR-Cas系统,以及从零生成一个有功能的基因组。“从零开始、从最底层搭出一个东西,在基因组这个尺度上以前是没人做到过的。”
02
Evo打不过小模型,Omnii靠对齐翻盘
RJ直接问:Evo和Evo 2在很多任务上打不过专用小模型,那为什么还要用大模型?Eric承认Evo只展示了预训练的潜力。
“大家看到的都只是训练出来的基座模型。它们是预训练过的,但基本没有对齐。”自然语言这边,预训练之后还要做一大堆中训练和后训练,模型才能到真正有用的状态,而生物模型此前几乎没做过这一步。
新模型Omnii就做了一点点对齐——在变异效应预测、疾病因果突变上开始达到SOTA。最让他意外的是,这恰恰补上了模型最弱的地方:“非编码区只占基因组的百分之一到二,但很多疾病、甚至大部分疾病都出在这些非编码区。”
他们还对标了长期SOTA的传统方法CADD。所以Eric的目标不是挑一个模型赢:“我们要赢过现在人类可能达到的最好水平,而且是每一种方法上都要赢。”
03
把思维链搬到DNA上
Brandon接着追问另一个实验结果:RNA在共进化数据上出了名地糟糕,凭什么模型能做到?Eric也承认意外,只能推测是DNA预训练里携带的进化信息在起作用。
这个实验的思路来自自然语言的思维链:只要训练集里有个指标能「逐步变好」,这套范式就可能成立。他们拿来一个很大的RNA适配体数据集,只按分数从低到高喂入较低分序列,让模型顺着这条轨迹往下写。
“结果它确实能复现出一些我们还没展示过的高分序列。”湿实验验证当时还在进行。
RJ把适用条件抽象了出来,Eric随即给了另外两个用例:抗微生物耐药性——给模型看效果越来越强的噬菌体基因组和对应分数,去杀死特定菌株;还跟一个国家实验室合作,设计能从稀土矿物里做选择性提取的蛋白质,难点不是能不能结合,而是选择性。他们能做的是把目标基因上游的非编码区当上下文喂进去,让模型给出自然界见过的变体或组合。Eric管这叫「挖矿」。
04
同一批模型,用来生成也用来检测
节目的最后一段落到生物安全。RJ替反方把话说圆:你们在前沿,就等于同时在推攻击侧和防御侧。
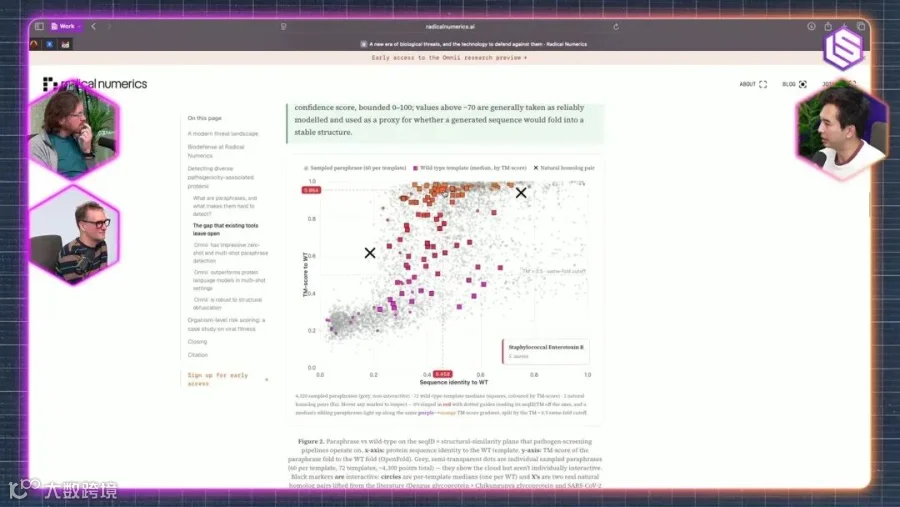
Eric没有回避:“设计这一侧一定会越来越强,防御这一侧就得拼命往前赶……我们想做的,就是把防御这一侧拉到基本跟它齐平。”理由很实用:这基本上是同一批模型。“一个擅长生成的模型,反过来在判断一段序列是不是致病上,也特别强。”
Brandon点出生物与网络安全的关键差别:网络里发现漏洞可以打补丁,“可我们面对的是固定的基因组,你没法给一个人打补丁”。但他也替Eric说了句话:“防御能力现在根本还不存在。没有工具的话,你什么都做不了。”
现状让他不放心:现在的检测基本还是把序列比对到已知病原清单,可AI能造出字母完全不同、功能一模一样的序列。
他自己睡不着觉的不是某个具体场景,而是门槛在下降——近期更担心无意的泄漏。
临别时Eric留了一句话:“很多人会觉得必须做个选择,要么去做AI技术的前沿,要么去做改善人类健康的事。我希望大家带走的结论是,你不用选。”
原节目:Latent Space — 🔬 Bio-security is an AI Arms Race - Eric Nguyen (CEO, Radical Numerics)《🔬Bio-security is an AI Arms Race - Eric Nguyen (CEO, Radical Numerics)》