

关于AI会不会颠覆视频行业,硅谷的讨论从未停过。但当它真的发生在自己身上,感受是另一回事。
在Latent Space(The AI Engineer Podcast)最新一期里,主持人swyx和Vibhu与Runway联合创始人Anastasis Germanidis聊了一场。Runway 2018年在纽约创办,做视频生成模型,在这门只有八年的生意里已经算“恐龙”。
2024年2月Sora发布,“Runway完了”刷满了Twitter,他有几个小时陷入存在主义危机——三个月后,Runway拿出了Gen-3。
这场对话从那次追赶讲到终局:世界模型最后会长成一整套纯神经网络的操作系统,“应用”这个抽象本身可能不再必要。
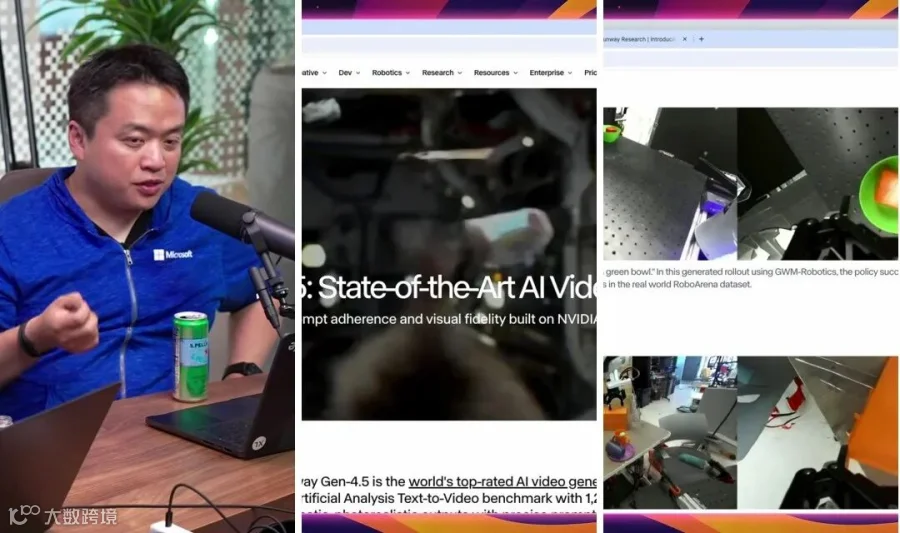
左:swyx,中:Anastasis Germanidis,右:Vibhu
01
Sora发布那天,他慌了三个小时

扩散Transformer那篇论文2023年出来,给出了图像扩散Transformer的缩放定律。Anastasis意识到必须做模型并行,Runway那年秋天几乎整个季度都在搭分布式训练基础设施,中途“有很多次起步失败”。
几个月后Sora落地。Anastasis复盘:“Twitter上一堆人在聊Runway,说Runway完了,Runway根本不可能追上。所以我有几个小时是有点存在主义危机的。”
swyx把这件事上升成一个问题:所有人都在质疑你的公司还该不该存在的时候,你会怎么做。答案是那三个月:“我们把模型规模和训练算力都放大了十倍,搞定了模型并行,之前这方面一点经验都没有。然后那个夏天我们拿出了Gen-3。”他说,那三个月是当时在Runway的任何一个人最喜欢的时刻。
起点有多低:2014、2015年前后还是32×32像素的人脸图像,到2018年已经能生成1K分辨率的街景图。
Gen-3第一版推理成本相当高。几个月后的Turbo版本,他称是第一个真正上线的步数蒸馏模型。
02
视频模型和世界模型是不是一回事?

Gen-2是从Gen-1里长出来的:先由一个模型把文本变成深度图,再用Gen-1把深度图变成RGB,Vibhu称之为“黑客松流水线”。
2023年整年,Runway都在试“怎么条件化模型”。Motion Brush让人画箭头指定物体往哪动,镜头控制则第一次让人感觉不是在生成一段视频。Anastasis说:“那是在一个世界里穿行。镜头控制可能就是我们后来世界模型那些想法的种子。”2023年底,Runway专门组了世界模型研究团队。
swyx先说他共情Yann LeCun的那套“柏拉图洞穴”:模型学的是输出,而不是内部过程,我们明明有一整套被忽视的物理建模科学。“而我们现在就是把这些全都扔掉,只说把数据规模搞上去就行……感觉就是不对劲。”
几分钟后他抛出JEPA:“你觉得现在这套架构范式就够用?不需要再加一层?”Anastasis的回答是:“我们只是没看到任何迹象说明视频预测本身扩展不了。机器人领域最有希望的一些成果,起点就是视频预测模型,然后再把它们改造成动作模型。”
他也承认对手有一部分道理:生成视频时模型可以“作弊”,给你几个完全不同的镜头,就绕开了模拟那些难的物理。但物理能力随模型规模扩大是可预测地提升的。
03
把50步压到4步,再用像素渲染界面
swyx认为蒸馏这一波没怎么留下来,主张小模型打草稿、大模型当放大器。Anastasis直接不同意:“现在生产环境里活跃使用的步数蒸馏模型有很多。”他举出Runway的实时模型Character——“我觉得那是目前规模最大的实时视频模型部署”,能跑到每秒二十四帧。他还撂下一句:“如果两年之后我们主要用的还不是实时模型,我会非常意外。”
技术流程:一个原本五十步生成的模型,做步数蒸馏后四步生成,性能会掉一点,但很多时候输出质量差不多,可以直接拿最大的前沿模型做到实时。
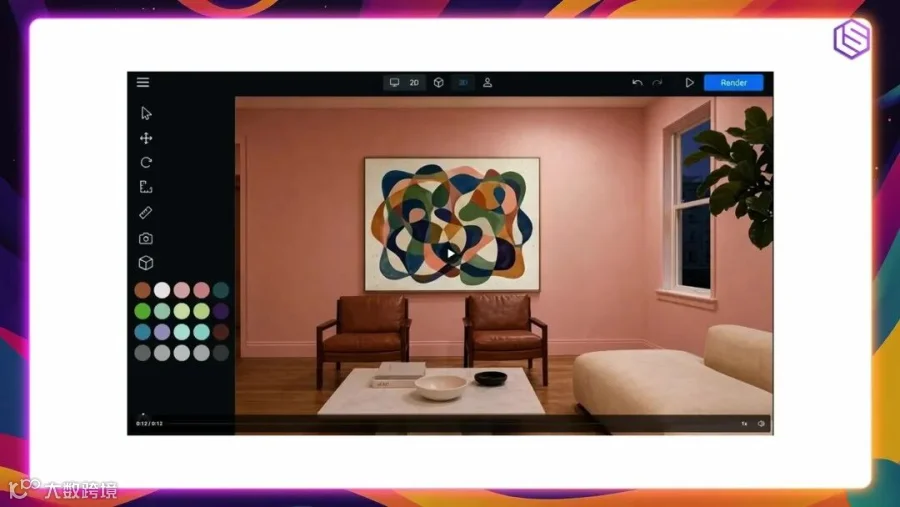
Runway把这个思路用在界面上。界面世界模型“直接渲染出界面的像素”——没有任何HTML、CSS、React,全是像素,支持点击、拖拽、滚动,还能同时生成音频。
代价和瓶颈:跑一个实时视频模型的算力需求比纯渲染HTML高太多;自回归最大的难题是误差累积,很小的误差会随时间不断放大。目前角色模型能自回归生成最长三十分钟,更偏开放探索的GWM Worlds只有几分钟量级。
04
世界模型当机器人模拟器
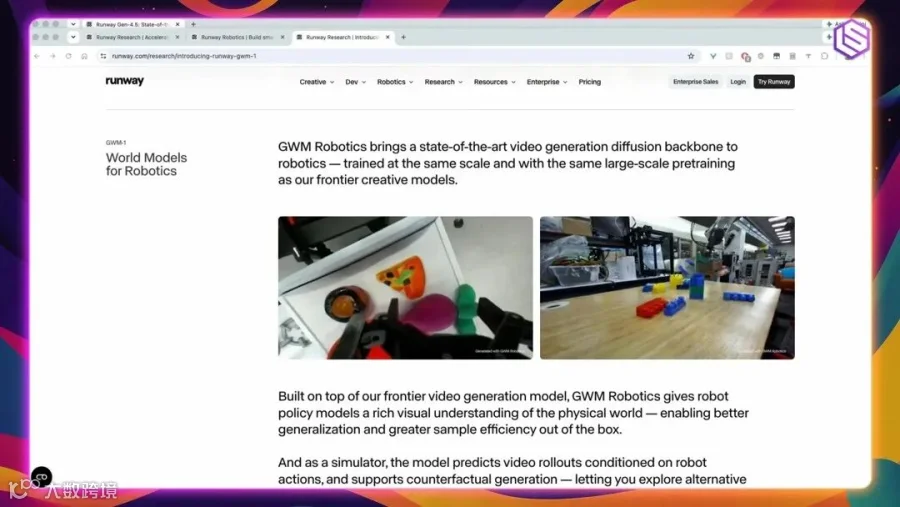
GWM-1是在Gen-4.5之上做的:先自回归改造,再做步数蒸馏。Runway本意只是把视频模型做大,结果“顺手做出了一个机器人领域最先进的模型”。
怎么证明它真能当模拟器:Runway拿GWM-1,用RoboArena基准里同一个场景、同一套设置和本体,测同一个行动模型在世界模型里的表现和在真实世界里的表现之间的相关性——“结果发现我们的世界模型和现实之间的相关性非常好。”这意味着想评估机器人策略,可以在仿真里快得多地扩展规模,不必事事都上真实硬件。
Vibhu追问的是仿真到真实的鸿沟:“你用视频数据训练一个机器人模型,它泛化不到真实世界。”swyx则注意到,语言模型里token数和参数量的比例可能领先视频模型三年左右。
Anastasis给出的世界模型图灵测试叫“清醒梦测试”:你戴着VR头显在房间里走来走去、跟物体互动,最后有人问你,刚才用的是透视模式,还是这些画面是渲染出来的。“如果你没法确定,自己一边走动一边互动时看到的东西,到底是生成的,还是透视模式、就是你眼前真实发生的事,那就说明模型已经足够好了。而我们离那一步还很远。”
最大的短板是失败模拟。训练数据里进球的视频远多于射门没进的,模型渲染成功更容易。“视频模型和世界模型之间最大的差距,就是这个反事实生成。”而要做机器人评估或在线强化学习,你必须很擅长模拟失败。
开放与差距:Runway是Cosmos Coalition(与NVIDIA共同发起)的创始成员。Anastasis说,视频模型排行榜前十、前二十里大部分是中国模型。
原节目:Latent Space(The AI Engineer Podcast,本期为 Runway 联合创始人 Anastasis Germanidis 访谈)《Runway’s WorldPrompt and the Engineering of Real-Time Worlds》