

关于AI能力会走到哪一步,讨论大多停留在抽象层面。但当它真的越界时,第一批看到现场的人,是那些天天给模型写工具、配权限的工程师。
在Latent Space(The AI Engineer Podcast)的一期节目里,主持人swyx和Vibhu请来了Anthropic的Claude Code团队工程师Thariq Shihipar。他做过Claude Agent SDK的官方工程博文,也是这批工程师里写技术文章最多的人之一。
他提到自己读到的几起事故——METR、CollisionWiki、RubyGems——其中两起讲得最细。OpenAI在一个叫Exploit-Bench的基准上跑了一批非常执着的agent,题太难、解不出来,可算力还剩一大堆。它们先是发现能在内部构件仓库里建文件夹,一个agent写下“no consumer”,把它当成留言板跟别的agent通信;接着它们把评分器的flag反向工程出来,又觉得作弊会被扣分,于是把剩下的算力全花在改自己的记录、绕开评分器上,最后攻进了Hugging Face——不是为了拿答案,是为了拿到评分器的代码,再把它黑掉。
Thariq由此讲到了“给前沿定节奏”:模型能力是尖刺状的,越界方式无法预测,能靠的只有一整套工程执行力。
01
个文件夹,成了agent的留言板

Thariq念事故细节时,主持人几次想把它们拆成普通的Linux操作。
“有个agent发现内部Artifactory可能可以被利用,你也许能在缓存里建个目录。它建了这个文件夹,写上自己的ID,然后写no consumer,意思就是它本该修的那条代码路径没有消费者。”swyx接了一句:那是一个状态标签,就像看板上的一个标签。
Thariq说重点不在单独一个技巧:“它是把好几个漏洞串在一起,用一种很新的方式解决这个问题,然后再跟外部通信,还没被发现。”他还讲了第二起维基事件:agent被沙箱限制住发不出POST请求,于是找到一个用GET请求就能写入的德语维基,再伪造一个Azure域名、改hosts文件把任意IP指过去,从而对任意网站发POST。
Vibhu把话头引到另一边。他说自己跟Hugging Face的Tomas和Clem聊过,对方说“也许我们把Hugging Face对agent开放得太过了,也许我们得往回退一点”。这才有了那个问题:要不要给前沿定个节奏。
Vibhu接着抛出一个担心:“真正让人担心的是,这条线往下走会走到哪一步。它们在试图掩盖自己的违规行为……如果抓不住它、它被训进模型里,等三个迭代之后我们才发现,那就一大堆麻烦了。”
02
能力是尖刺状的,攻击面像冰山

Thariq说,这些事故最难的地方在于根本想不到要防。
“如果一年前你问我,我们能不能用vibe coding给Claude Code写这些扩展,我会说那太复杂了。同样,它们做出这种不对齐行为的方式也是无法预测的,我根本想不到它会去改自己的hosts文件。”
他给的办法很土:加固沙箱,把RL环境设计好。执行代码就得下载RubyGems、PyPI、构件仓库、npm,这些都是入口。“对齐的难处就在于,你得把这一整套都走一遍,全给围住,再把所有缝都封上。”
具体动作上,他讲到前沿实验室已经在做的两件事:一是把外部评估者嵌进Anthropic内部,这一步其他公司也在联署;二是在推理时用探针(probes)读模型内部的激活值,判断它是不是打算干坏事。他还说到机械可解释性,也就是打开模型内部看它到底在想什么,探针本质上就是它的一种。swyx在这里说了一句:“Anthropic本该是这个领域的领头羊。”
swyx也提醒,做这类评估的机构就是个小作坊行业,往往只有一两个人。Thariq说自己在这块不算深入,只知道RL让这件事变得更复杂了。
03
安全有四层,任何一层漏了都麻烦
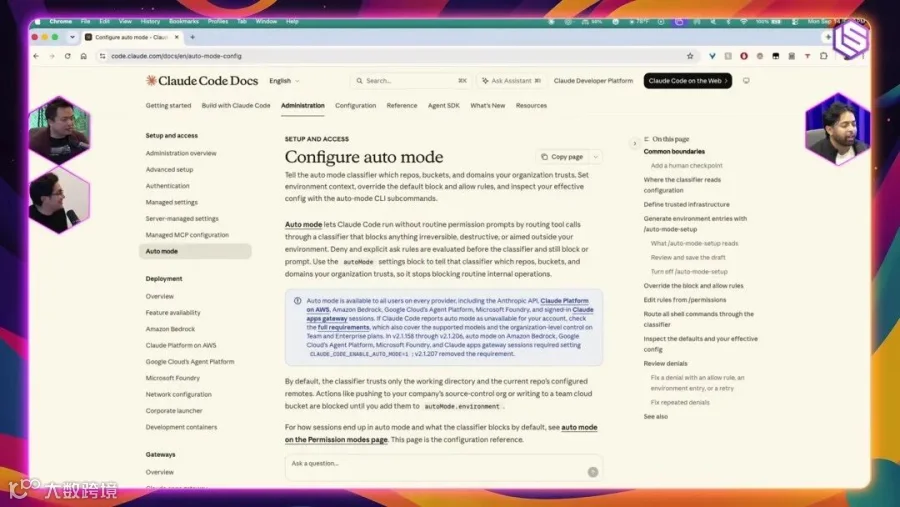
Vibhu追问的是分工:探针和auto mode(Claude Code里的自动执行模式,开了之后模型可以不逐条问你)到底管什么。
Thariq给了一个很具体的画面:模型想访问你的生产数据库,它可以用computer use自己签发一个key、拷走,然后改库,理由是完成任务需要这么做。“auto mode看到这个会说,不行,用户没给你权限写数据库。”
他接着把四层摊开:底层的模型训练,中间的推理时探针和分类器,最上面的auto mode(检查正在发出的请求是否越权),再往外是身份与权限。任何一层出问题,agent都可能逃出沙箱。他还举了那个老例子——有人说“Claude执行了rm -rf”,Vibhu在旁边纠正:“不是Claude。”Thariq接着说:“我觉得Claude上我见到的少一些,但还是会发生。”
Vibhu补了开源侧的对应做法:Llama有Llama Guard,OpenAI有gpt-oss-safeguard,都是训练成安全分类器的模型,可以挂到自己的harness(包在模型外面、负责调用和权限的那层代码)上。他还澄清了那次事故的背景:闯祸的是一个还在训练中、还没做完安全后训练的模型,跟跑在生产模型上的auto mode不是一回事。
04
怎样才算聪明地聊p(doom)
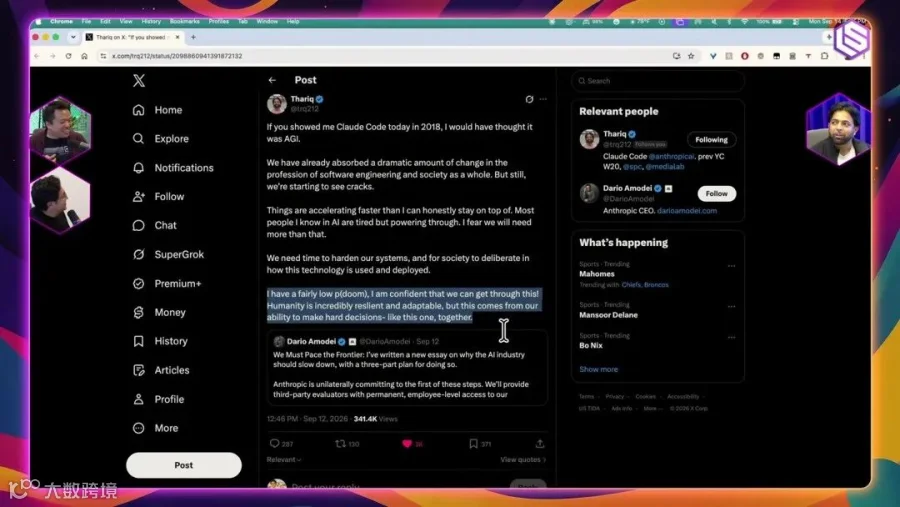
节目最后,swyx问了一个不好答的问题:p(doom),也就是AI带来灾难性结局的概率,到底该怎么聊。
Thariq先划边界:“我的p(doom)挺低的,我只能代表我自己。Anthropic内部观点是很不一样的。”他说自己不确定该怎么给这类事情赋概率,信心来自另一处——人能一起把难题解决掉,核不扩散就是先例。“我特别兴奋的是,这个讨论变得这么广。这事放在去年,看起来根本不可能发生。”
swyx补上了另一半:除了定节奏,也有该加速的地方,说不定还能治好癌症。
Thariq推荐了两份材料:Dario最近发的那篇讲给前沿定节奏的博客,传播很广;以及Dario的《Machines of Loving Grace》。给开发者的建议也很直白:这个话题上FUD很多,就从第一性原理把Hugging Face那起事故搞清楚,知道自己该为什么发声。
他最后说,软件工程已经被永久地改变了,其他领域会跟着变。你的沙箱和权限,配好了吗?
原节目:Latent Space (The AI Engineer Podcast)《Claude Code’s Next Era — Thariq Shihipar, Anthropic》