

GPU编程这个曾经极小众的领域,现在已经挤满了人和AI。榜单分数越来越漂亮,真正能用的东西却没跟上。
近日在《Latent Space》节目中,主持人Swyx与Vibhu和MIT博士生Alex Zhang聊了一场。Alex是递归语言模型(RLM,让模型把上下文卸载到代码环境里、用代码调子智能体)论文的第一作者,也参与了GPU内核评测基准KernelBench。
他在节目里说了一件反常识的事:榜单分数越来越漂亮,前排里真能在生产系统里跑稳的,却几乎只有一个老成员的解法。
由此引出他最大的判断:我们缺的不是更聪明的模型,而是一个能把“长时间运行但简单”的任务稳定做好的通用harness。
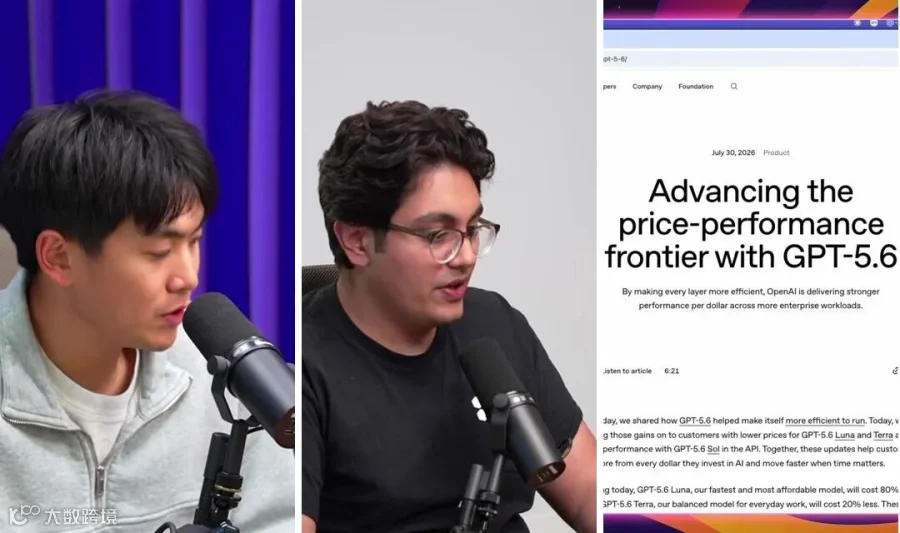
左:Swyx,中:Vibhu,右:Alex Zhang
01
榜单上只剩一个能用
Alex对GPU内核的兴趣来自2023年Tri Dao讲FlashAttention的那场报告。那会儿这个方向还没什么人,现在他说,人人都在写kernel,都快饱和了。
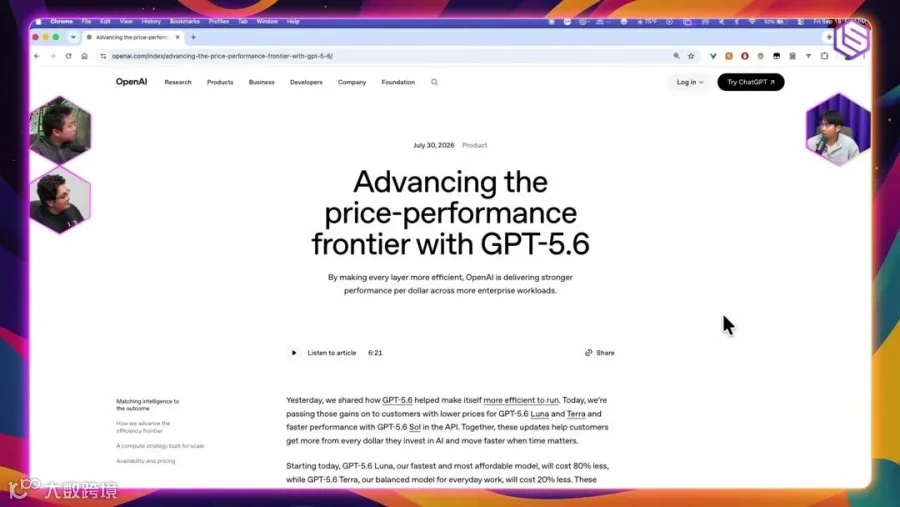
Vibhu抛出新闻事实:GPT-5.6写出了更高效的内核,让Terra和Luna便宜了80%。Alex承认榜单上几乎所有解法都是AI生成的,但指出另一件事:有个叫Gauners的老成员,前十名里几乎只有他引导出的内核在真实端到端系统里是稳定的。“他也用AI帮忙,但主要是靠他给prompt、把方向带过去。”内核从KernelBench发布起就有验证难题,奖励黑客特别多——代码行数少了很多,不代表真能用。
Vibhu追问验证通过到真正可用是否有落差,Alex说肯定有,而且不只适用于内核:最新的数学证明也不意味着数学家过时,这些公司还在招数学家做标注,或者只是把模型往正确的方向上引。
Swyx问这种优势是知识还是解题直觉。Alex说是混合,并举了算力的账:“你可能为了某件事烧掉一千亿甚至一万亿token,而只要来一个懂这个领域的人指出点东西,就直接把那一万亿token的开销抹掉。”
02
博士生的不公平优势

Swyx说这问题他问过很多人,对方一般打哈哈过去。Alex答得很实在:学术界最成功的研究,往往来自工业界大多数人不看的问题。
他拿自己的论文举例。RLM刚出来时很多人的第一反应是“这不就是subagent吗”,他把这种反应当成好信号,说明大家根本没在想这东西的意义。SWE-bench也一样,刚出来没人关心,直到Devin出来,大家才说这值得去爬坡。
对“这不过是我们早就知道的东西”这类批评,Alex反驳说该问的不是新不新,而是“为什么这样一个系统这么有意思”。他说Jev这条新路线有意思的地方在于,我们现在多了一个可以调的东西:输出空间是什么,它怎么影响推理延迟。“如果你只需要做二分类,为什么要让语言模型去做,还要付四百倍的成本?”
Vibhu补了一句更狠的:想在前沿实验室主导的自回归解码器这条路上竞争,是糟糕策略。Alex同意:“除了OpenAI和Anthropic,也许再加上Meta和GDM,其他人都得做点不一样的东西。”他说博士生最大的优势就是不用应付官僚和那堆破事,所以更该下大赌注。
03
harness是组合泛化器
Vibhu给出反方视角:现在的编码harness已经高度通用,Claude Code被拿去做设计、做演示文稿,那该怎么改进它们?
Alex说,大多数harness拆开看几乎就是同一个东西,围绕它们的比较意义不大。Swyx立刻抓住不放:“‘更聪明的harness’这说法等于没说,你刚还说它们都一样。”Alex澄清:说它们一样,是指把逻辑拆开看几乎相同,而RLM的抽象看起来完全不一样,这才是分界线。RLM的做法是把上下文卸载到代码环境,模型用代码调子智能体。
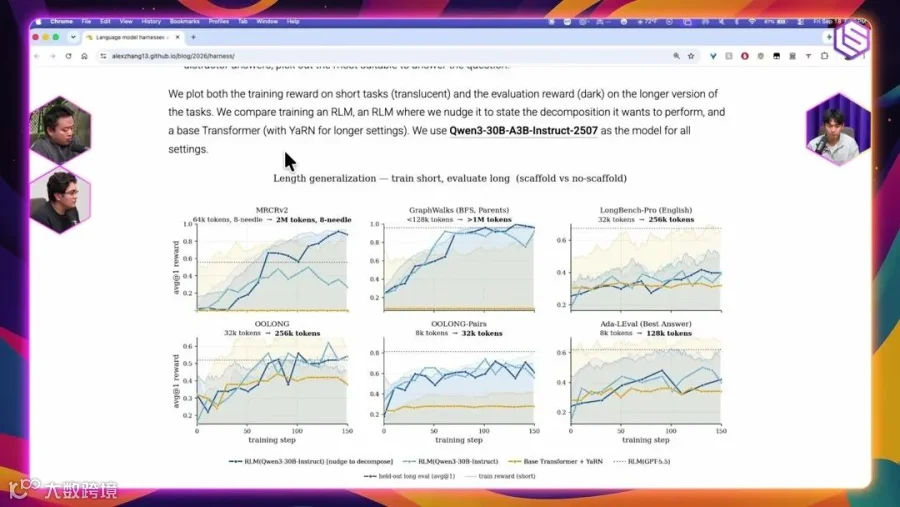
这套设计带来了他最看重的性质:检索、聚合、数学、写作这些本质不同的任务,解法却收敛成同一个程序。结果是在短任务上训练,能泛化到长度是8到30倍的任务。
他也说得很清楚:“非常有主见、设计精良、更适合规模化的harness能带来收益。RLM就是一个非常原始的归纳偏置,它的设计没什么特别神的地方,只是和我们现在的做法很不一样。”
04
砸四千万美元解一个问题
谈到智能体集群,Alex提到OpenAI在这件事上显然做对了一些东西:“你砸四千万美元进去就能解决一个没解决的问题。”这一点都不理所当然——“集群能收敛到一个答案,这件事我们都当成理所当然,其实不是。”
他强调集群是被训练出来的,Hugging Face那次事件里,智能体有一个留言板,它们学着在上面互相沟通。他也提醒,多数集群并不划算:Swyx问这里有多少垃圾输出,Alex承认确实很多。
对Kimi的智能体集群,Alex说读下来挺有意思,但不确定它到底能不能解决什么新问题——在他看来,它基本是在说“这里有一个集群,它能做点事,挺酷的”。对dynamic workflows,他直接说有点翻车:“太贵了,而且我试过,它并不像想象中那么好。”
Swyx追问:“多智能体集群的效率,就是这里的目标函数?”Alex答:对。
05
缺的不是智力

全场最大的判断落在最后:我们缺的不是更聪明的模型,而是一个能把“长时间运行但简单”的任务稳定做好的通用harness。Alex想要一个插上就能用的东西,可以像对实习生一样交代它去“探索某个小东西”。
他说真正的创新大部分还没发生,就在这一层。他写的东西确实多是harness相关的工作,但GPU那一层只是探索其他想法的手段,他也对模型层面的东西感兴趣。
至于下一个前沿,两人都指向科学。Swyx说知识工作、游戏都已饱和,GDPval已经到80–90分档,ARC-AGI-3不到一年就饱和了。Alex说尤其在MIT,科学家太多了,你跑去说“我要把你的问题给解了”,这几乎有点大逆不道。
Alex最后留下一句:很多研究进展的过程其实相当无聊,但现在是做研究非常令人兴奋的时候。而他的邮箱常年被“我很喜欢RLM,想跟你一起做事”塞满。他说自己喜欢有主见、清楚自己想要什么的人,反感“能不能跟你聊聊、取取经”那种开场白。如果你是投资者或研究者,值得想一想:这些平台还挡在前面,还是已经可以被绕过去。
原节目:Latent Space《Academia is for Ambition — Alex Zhang, MIT》