

语音AI看上去早就被解决了:Siri、Alexa、ChatGPT的语音模式,一代又一代。但真把它放进呼叫中心,它会在最要命的地方翻车。
近日,在AI技术播客Machine Learning Street Talk(MLST)中,主持人Tim Scarfe与语音AI公司PolyAI联合创始人兼CTO Shawn Wen进行了一场深度对话。PolyAI为企业客服中心提供语音智能体,客户覆盖银行、公用事业、物流、餐厅和酒店。
Shawn讲了一个他忘不掉的场景:一位老太太第一次跟机器人通话,困惑地一直说“停一下”,可agent还在不停抢话盖过她。正是这类场景,让PolyAI决定停掉自研的语音识别模型,自己训练音频原生模型。
在对话里,他把语音AI的真正门槛讲得很直白:智能不在于推理,而在于适应;而行业的瓶颈,已经从生产内容,转移到了验证和审计内容。

左:Tim Scarfe,右:Shawn Wen
01
在办公室对AI说话,被同事围观
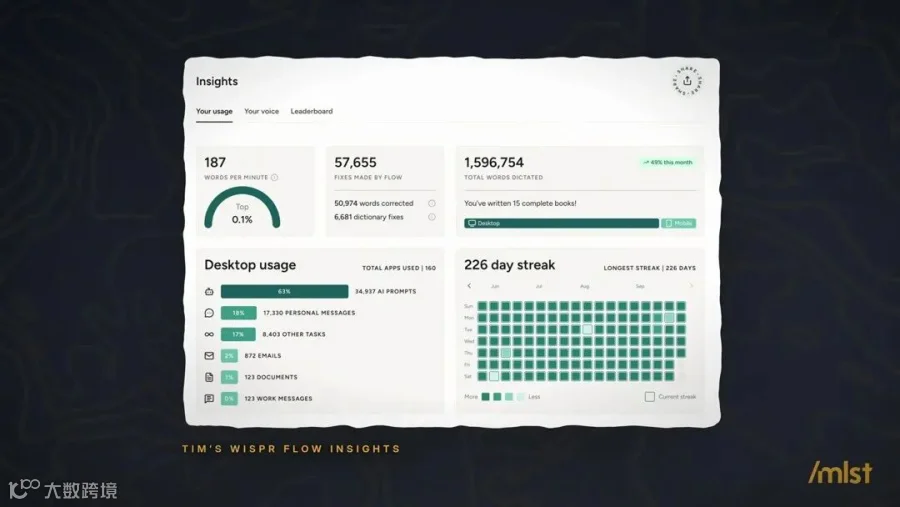
Shawn是语音输入工具Wispr Flow“用得最猛的那百分之一”,在办公室也照说不误,结果“被好多人吐槽,你在干嘛?这太奇怪了”。他买的Meta眼镜也是同一个待遇。
Tim先设想了一个十年后的场景:会议室里装着麦克风,多人对话、该避开私密内容、agent知道是谁在说。Shawn觉得这个预测对,但泼了冷水:语音是最自然的界面这句话人人都会说,可过去已经有Siri、Google Assistant、Alexa、车载语音好几轮个人助手了,“消费者的使用习惯是不是已经准备好了还不好说,因为那意味着你要把很多控制权交给agent”。
Tim还问了一个更具体的问题:如果我是在跟一位老太太通话,我会放慢语速、给她更多思考时间,模型能这样自适应吗?这正是Shawn认为前沿实验室没在优化的东西。
02
级联架构为什么必须坍缩成一个模型

传统做法是把语音识别器、语言模型和一层轮次切换串起来。Shawn说,这三个模型彼此配合得并不好:“传统做法是再加一个检测器,判断这是位老太太,所以我得把参数这儿那儿调一调,但这套东西特别脆。”所以大约一年前PolyAI判断级联方案会过时,停止投入自研ASR,转向端到端。
轮次切换成了第一个token。坍缩后的模型一边接收流式音频,一边预测第一个token:话是刚开头、用户还在说,还是说完了。检索方式也换了。没有转写文本,传统RAG就用不了,他们改成让大模型生成一条搜索查询当作工具调用,回复末尾还会生成引用,方便企业追溯。
Tim用Rich Sutton的“苦涩的教训”做了总结:手写代码去覆盖失败模式,组合会指数级爆炸,端到端训一个神经模型能吃掉其中一大部分;但他认为外面还是得留一条级联的边界,智能不够时往外调agent。Shawn接着补了一句:“我们的创新不在模型本身,我们创新在输入输出契约上。”开源模型每个月都在换,他们守住的是自己的数据和训练脚本。
03
降噪清洗,反而让新模型变差
数据不用专门收,平台就部署在企业客服中心里,真实通话一直在产生。要用这些数据训练得先过隐私关——全部脱敏,客户数据事后导不出去,另外生成大量假的姓名、地址,让模型照样学会识别。
“有意思的是,在我们上一代技术里,我们会做很多降噪,很多流水线式的预先清洗,结果这些额外的组件加到新的对话推理模型上,反而让它变差了,就是因为环境太干净了,模型从来没见过。”
合成数据也是刻意做的:让TTS念他的中文名,背景再叠上婴儿哭声。至于“鸡尾酒会问题”里的串音,Shawn说架构本身适合解决,但不是靠给说话人打上一二三个标签——“作为人,你在一个聚会上听那么多人说话,你不会主动去标记这是说话人一、这是说话人二。”真正决定agent听谁的,是prompt和训练数据。
04
延迟:老太太不能等,年轻人不耐烦
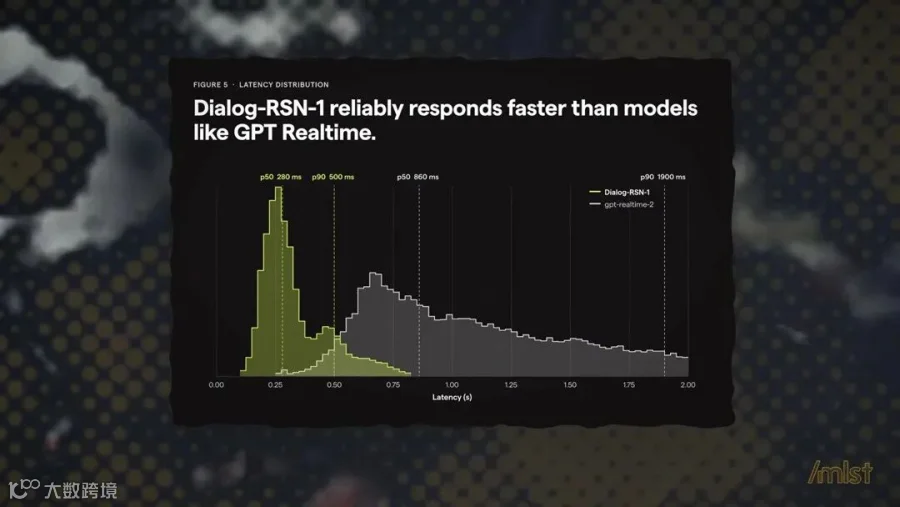
级联系统判断句尾只能靠一个很粗的参数:你愿意等多久才算说完。“如果你调得太短,它就太激进了,会频繁打断很多上了年纪的人。如果你调得太长,那就要等太久,很多人会不耐烦。”端到端模型在音频帧上预测,帧里带着语速和语义,说到一半停下它就知道还得等。
反馈不能断。“如果电话那头的AI突然没声了,哪怕就三秒五秒,你都会慌。”他们正在研究给模型加自适应推理:训练时不断挑战模型,你真的需要想那么久吗,能不能压到一秒就直接回应。模型和平台都自托管,因为长尾最要命的是P95。
通用声音反而会被挂断。“消费者一听就知道这是个机器人,一旦听出来是机器人,他们立刻就不信任了。”表现最好的声音往往带本地口音;早期最自然的英语声音,其实是一个被逼着讲英语的法语声音,正是那点不完美让它显得真实。
Shawn也承认,终端体验很难用基准衡量,只能把模型和编排层耦合起来做整体评估。内部基准特意把响应时间算了进去:“用户不可能在电话那头等你六十秒才给答案。”他说,这套基准打算在一两个月内开放给行业和研究社区。
05
瓶颈变成了审查,而不是生成

对话最后落到企业到底该拥有什么。Shawn说企业已经想明白了:他们想拥有AI,但知道自己拥有不了模型。他们唯一能自己拥有的是编排层。“我觉得接下来几年我们会看到的是,企业会意识到他们不必什么都自己拥有,但他们得搞清楚边界在哪。”
他对“人工组织”的设想泼了盆冷水。Shawn讲了一个刚发生的会:最大的公用事业客户之一通知他们,以后所有合进仓库的PR都要审查,周期两周,进生产的东西必须可审计。“一个coding agent直接吐PR然后自动合并,在他们那儿是过不了关的。”
Shawn说,如果人不小心,就会甩给对方一大堵文字墙,“人的容量没这么大”。这也是他的工程师从年初就一直在跟他讲的问题:产出太快,审查跟不上。Tim接了一句,说写代码这件事尤其尖锐,因为复杂度极高、需要大量背景知识;而客服对话里双方都懂在聊什么,所以问题没那么大。
至于适应该放在哪一层,Shawn的建议是先动编排层,微调排第二:“如果真的绕不过去,再考虑换别的模型或者训自己的模型。但那应该是第二选择。”
原节目:Machine Learning Street Talk (MLST)《How a Voice Agent Learns the Rhythm of Conversation — Shawn Wen》