

一份数学证明,同时通过了两个独立实现的检查器。而 Lean 的创造者事后发现:一个漏洞打在官方内核上,另一个完全不同的漏洞打在独立检查器上。
近日,在技术播客 Machine Learning Street Talk(MLST)中,主持人 Tim Scarfe 与 Lean 定理证明器的创造者、Z3 求解器的共同创造者 Leonardo de Moura 进行了一场对谈。
Leonardo 复盘了 2026 年 7 月那份考拉兹猜想(Collatz)假证明的全过程。他第一反应是“那也太吓人了”,紧接着补了一句:“我们强烈怀疑这是 AI 搞出来的。”
这场对话真正回答的是:当机器开始自己写证明,我们到底还能信什么。
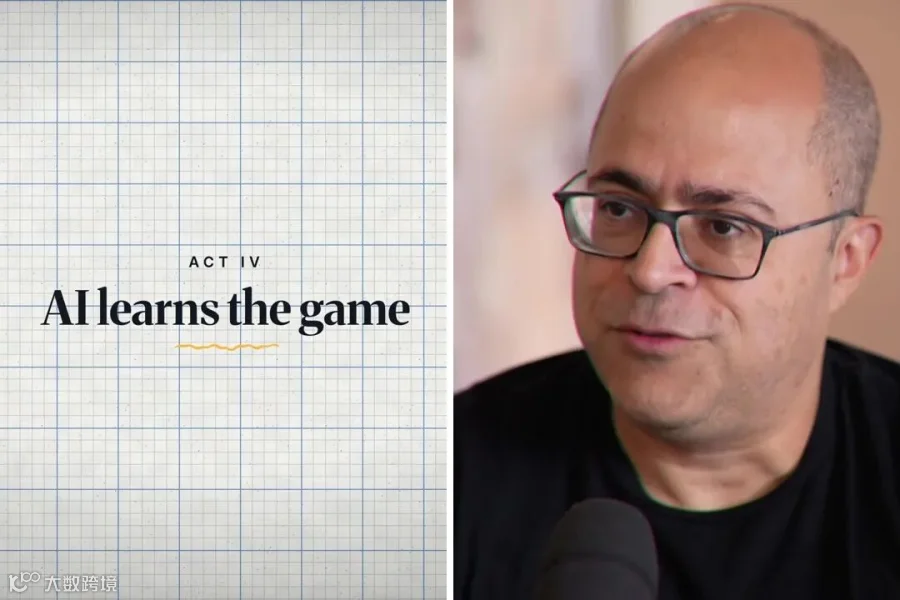
左:Tim Scarfe,右:Leonardo de Moura
01
份骗过两个内核的假证明
Lean 的信任模型很小:庞大的数学库 Mathlib 里藏着无数 bug,但只要结论可信,你只需要相信那个小得多的内核。为了保险,社区还做了几个独立实现的外部内核,其中一个叫 nanoda,是用 Rust 写的。
Leonardo 讲了时间线:大约十天前,有人报告 nanoda 有 bug,开发者当场修掉了。几天后,一份考拉兹猜想的 Lean 证明被提交上来,声称官方内核和 nanoda 都接受了它。
他和同事 Joachim Breitner 的第一反应都是:nanoda 根本不接受这个证明。但 Joachim 紧接着说,不对,十天前那个版本的 nanoda 是认的。
“实际上是两个漏洞,我们强烈怀疑这是 AI 搞出来的,一个利用了官方内核的 bug,另一个利用的是完全不同的另一个 bug。”他修官方内核那个 bug 时,还发现里面塞了一堆莫名其妙的项,目的是制造哈希碰撞,跟证明本身完全没关系。
他顺便举了另一个例子:Boris Alexeev 提交的单位距离猜想形式化证明有一百二十万行 Lean,“没人愿意一行一行去检查,这时候有份证书就太好了”。至于怎么办,他提到正在讨论的几种办法:给“防弹”内核设悬赏、把内核做得更简单、支持 Mario Carneiro 证明内核本身正确,以及让沙箱检查工具 Comparator 永远自动下载最新版 nanoda——“要是当时已经这么做了,Comparator 早就把这个证明拒掉了。”
02
为什么不能留一张暗牌?

Tim 把这件事类比成模型越来越会 reward hacking:最后屏幕上只是一个绿色的对勾,可有些证明晦涩到人根本读不动。他问:这里是不是也需要一套独立的对抗系统?
Leonardo 的答案就是多个内核:“如果这些内核是不同的人用不同的编程语言独立实现的,整体就更稳固。”信任链还能继续上下推:往上是编译器,“你证的是那个东西,跑起来的却不是那个东西”;往下是硬件,让 Intel、AMD 发布官方形式化规约。说到底,就是不断减少你不得不信任的东西。
Tim 接着抛出一个尖锐提议:ARC-AGI-3 用半公开加私有的数据集防止模型作弊,形式化验证要不要也留一个模型黑不进去的私有内核当底牌?
Leonardo 拒绝得很干脆:“我不喜欢靠混淆、靠藏起来求安全。”“靠保密求安全,这跟我们整个社区的信念是相悖的。”
03
AI的杀手级应用,是把C代码翻成Lean
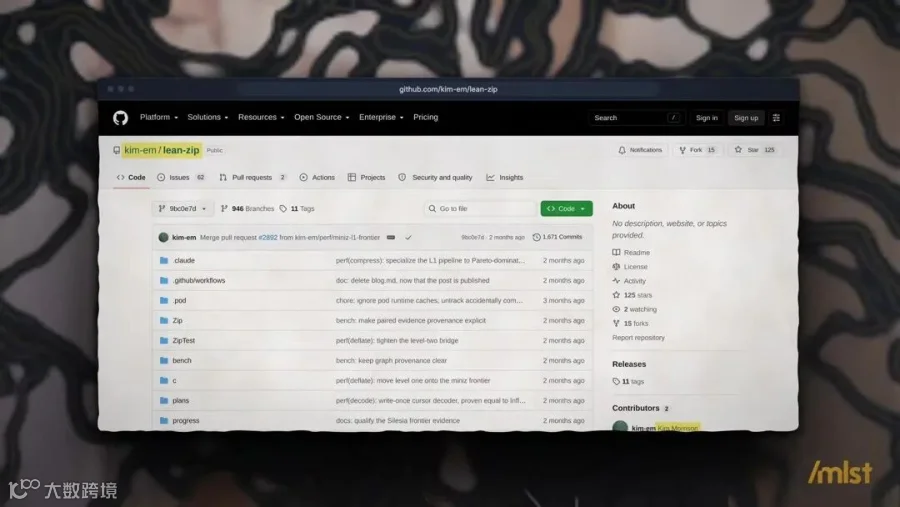
Tim 提到一个传言:Kim Morrison 用一个 agent 做出了 zlib 的 Lean 实现,还证明了一些性质。Leonardo 承认他当初判断错了:“Kim 刚开始做这个项目的时候,我觉得,哇,这没戏,不可能。”
结果 AI 把那段 C 代码翻成了 Lean,不断修,直到通过 C 版本自带的那套测试,接着证明了任意压缩级别、任意数据,先压后解都能拿回原始数据。
更出乎意料的是性能。Lean 一直是为操作树结构的程序优化的,不适合数组操作,但 Kim 让 AI 放开手优化,前提是证明不能破——最后跑出来的是一个 Rust 实现。
Leonardo 由此把话推得更远:很快就能让 AI 去写汇编,把各种防御指令全用上,同时还得给出证明。“这种底层的实现,我们自己没那个耐心去做,但 AI 有耐心。”
04
它读得懂内部实现,也会犯蠢

Tim 提了个理论:理解意味着你知道什么可能、什么不可能,知道反事实。模型只见结果、不见那条演化树,所以很难有真正的创造力。
Leonardo 说他被两个方向同时惊到。一边是,有个 bug 不在内核里,那段代码非常复杂,“我觉得没几个 Lean 的开发者搞得懂这一块。它讲得完全正确,一针见血,我惊呆了”。另一边是它时不时犯特别蠢的错误,而且没有在变好:“我一直在换更好的模型,它们越来越厉害,但同时也一直在干蠢事。”
他给了能力边界:模型特别适合干“nerd sniping”式的任务——把现成的零件拼起来找证明,人类完全不是对手;“但你要是让它为某件事发明一种新技术,那它就彻底完蛋。”
那人的位置在哪?Leonardo 指了三个地方:规约、路线图,以及关键证明本身——“关键的证明还是会手写,因为人们希望它漂亮,或者有某种特别的结构,适合教学、适合把想法讲清楚。”
05
亿行的数学库,怎么验收?
Mathlib 4 现在有两百四十万行。而社区里有人估计,如果想把任意一篇研究级的数学论文都形式化出来,这个库得有一亿行。
Tim 于是把问题抛回去:如果 AI 开始批量生成数学,你怎么控制这些产出?Leonardo 先把话说在前面:“假设我就开始建整个数学库,那会怎么样。它完全可能是垃圾。”
他举了 Johan Commelin 那一派的办法——设里程碑:“如果 AI 能把这个关键定理证出来,那它就是在做有价值的事。”例子是费马大定理:“陈述它只需要自然数,非常简单,但证明它需要大量数学。”“你得让我看到你走到了。”
而形式化验证本身,他寸步不让:哪怕模型 99% 的情况都能给出正确答案,我们仍然需要一份机器可检查的证书。
那么当证明长到没人愿意逐行读、连两个独立实现的检查器都能被同时钻空子,你会相信机器亮起的那个绿色对勾,还是相信人?
原节目:Machine Learning Street Talk (MLST)《Who Checks a Proof No Human Can Read? — Leo de Moura》