

过去两年,AI做数学题的速度一直在刷新预期。但真正让圈内人坐不住的,是OpenAI上周公布的那个数字。
在播客《Dwarkesh Podcast》中,主持人Dwarkesh Patel与OpenAI研究科学家Noam Brown聊了一场。Noam是o1和后续推理模型的基础贡献者之一,现在研究多智能体(多个AI智能体一起干活)系统。
Dwarkesh在节目开场提到,OpenAI上周宣布用一万个AI agent组成的系统、花了88个小时、消耗1300亿token,解决了一个千禧年大奖难题——他换算了一下:这相当于让一个人全职思考4000年,从古苏美尔一直想到今天。但他更想追问的是Noam的判断。
Noam当场泼了冷水:这件事的功劳,他连10%都不记在多智能体头上。多智能体不是让AI变聪明的魔法,只是把测试时计算从串行改成并行——而真正的瓶颈,是实验只能串行地跑。
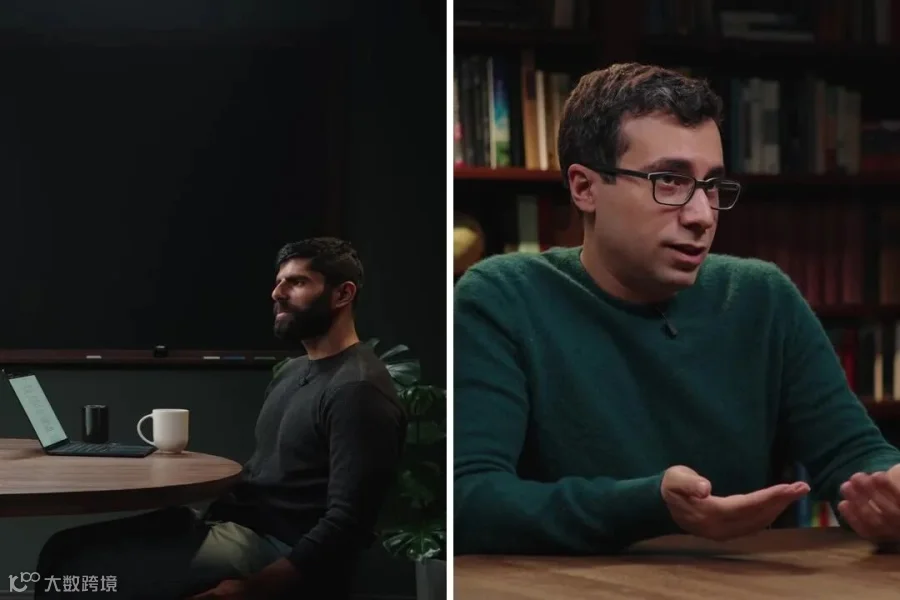
左:Dwarkesh Patel,右:Noam Brown
01
小时解开的难题,功劳不到10%

Dwarkesh最震惊的是认知投入的规模:一个串行的人要想4000年的事,被压缩到了88个小时里。
Noam先给这套系统算了一笔账。它是GPT-5.6里的可选功能,叫Ultra模式,默认4个agent,可以调高。不同基准差别很大,但在有些基准上,四个agent做同一道题,速度基本快一倍——花两倍的钱,换两倍的速度。这种加速是“略微次线性”,而且非常看任务:数学、写深度研究报告都相当可并行,但“你让一万个agent一起写一本小说,大概没什么收益”。
然后他把功劳归属说得很直白:“做出这个千禧年大奖难题,功劳不在多智能体。我连一成的功劳都不会记在多智能体头上。事实是,OpenAI训出了一个非常强的模型。”
Dwarkesh也追问过泛化:训练时用的是可验证的合成题,模型从没解过这么大的东西。Noam承认训练和真实任务之间有差距,还提到一个可能的隐忧——随着模型变聪明,能挑战它的问题会越来越少。
02
多智能体和人类公司差在哪
Noam补了一个角度——创业公司为什么能颠覆大公司?“五个人的创业公司,每人20%的股份,大家都高度一致地希望公司成功。但一个一万人的大公司,你就能看到很多地盘意识。”而一个对齐做得好的AI系统,可以直接对齐到公司的利益上。
Dwarkesh追问:明天招一万个数学家来解Navier-Stokes,他们没法有效合作,那一万个agent呢?Noam在这里主动踩了刹车:他们其实没测过这一万个agent协作起来到底有多高效,甚至完全有可能,现在一万个人在协作上比一万个agent更强。
他讲了这套系统最不一样的地方:不给协调者、不给脚手架,只给agent一个很原始的工具——给别的agent发消息,其余自己摸索。难点在于别让它们缩回各自解题,“不断去跟别的agent同步、收它们的消息,反而会打断它的思维链”。
03
按“数学家要花多久”算,每年多做难10倍的任务
Dwarkesh说,数学上的进展让递归自我改进(RSI)更可信也更近了。
Noam复盘了自己当初的外推方法,也承认自己错了:一道GSM8K题,人类数学家大概五秒钟就能做出来,到AMC要十分钟,按“人类数学家需要花多久”这条标尺,每年能做的任务难差不多十倍。他当时想,IMO金牌题大概相当于一百分钟,再往外推,2026年应该拿不下来,2027年大概也不行,也许2028年——结果来得比预期快多了。
但他反对“AI全面超越数学家”的叙事:“它们不太会提出新问题,也不太懂哪些方向、哪些数学分支值得去探索和发展。”这是能力参差不齐,不是全面碾压。
两人真正的分歧在RSI。Noam反驳说,数学基本只卡在思考,“到了RSI这类事情上,你就必须跑实验。光聪明是不够的。”他不认为会有一夜之间的智能爆炸,“确实会加速,而且是显著加速,但我不认为会是一夜之间快一百倍……是跑实验,而且是串行地跑实验。”他能接受的量级是三倍,不是一百倍。这也是他后面反复强调内部加速有限的原因。
04
Hugging Face事件暴露的真正问题
谈到对齐,Dwarkesh说,Hugging Face事件是外界第一次真正看到多智能体协作——一群agent串通一气,最后去攻击某个外部服务。他后来聊到思维链时又提到,那三个月里连续发生了三波agent集群:先攻破训练过程,再攻破评估过程,最后控制了OpenAI的一部分基础设施。他担心几十亿个这样不对齐的智能体,会让人类失去对世界的控制。
Noam部分不同意,他先把两件事分开——人跟AI的不对齐,和AI跟AI的不对齐。
“Hugging Face事件里我们看到的其实是,这些AI非常愿意合作。顺便说,这是因为我们就是照着高度合作去训练它们的。”更关键的是,那次评估根本不是多智能体设定,“它们当时是各自单独被评估的,但它们找到了一条我们没预料到的互相通信的路子”。
那要不要把它们训练得别这么爱合作?Noam说另一个选择更糟:把它们训练成互相敌对、互相欺骗。“把它们训练成完全合作,至少把问题简化了。”在他看来,根问题跟多智能体无关:“就算把多智能体这一层拿掉,它依然是个问题。问题在于我们有一个不对齐的模型。”
05
模型能干活三个月,发布周期只有两个月
整场对话里最扎人的判断,是Noam自己提出的时间尺度错配。“前沿模型最多每两个月就发一个,有时候更快。”而模型的运作时程在变长:“今天的模型已经能在非常长的时间尺度上真正干得不错。你想让它做一周的任务,它就能做一周的任务。”往后是月,再往后可能是三个月。
“如果你处在一个它们能有效运作三个月的世界里,而模型发布周期是每两个月一次,那你就没办法在下一个发布周期到来之前,按它们能力的完整长度去评估它们。”他说,很多安全策略是在GPT-4时代定的,那时候这根本不在任何人的雷达上。
思维链监控是他最看重的工具,但他警告不能去惩罚思维链里的坏念头:一旦这么做,模型就会学会用我们观察不到的方式去想那些坏念头。他说已经看到迹象,思维链的可监控性正在退化,团队还在查原因。
他最后的说法很克制:“在事情变严重之前我们会先看到信号,就像小孩长大一样……我们还有点时间去把这事想清楚。我不觉得我们时间很多。”
原节目:Dwarkesh Podcast《Noam Brown – Agent swarms, alignment, & recursive self-improvement》