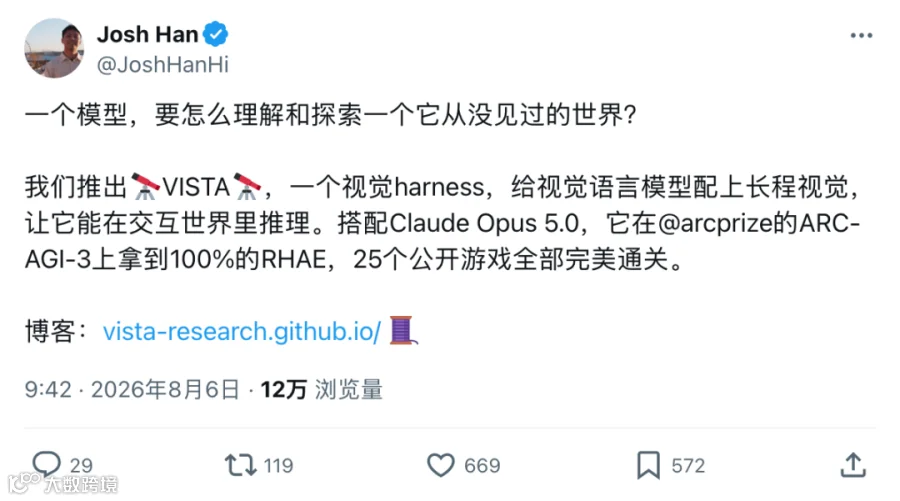
何恺明团队最新论文在社交平台引发热议。其提出的VISTA框架显示,过去半年顶尖大模型在ARC-AGI-3测试中表现受限,并非因为智力不足,而是受限于输入形式和记忆机制。
传统测试中,Claude Opus 5仅获40分。而通过VISTA赋予其视觉感知和回溯记忆能力后,该模型在ARC-AGI-3的25个公开游戏中全部取得满分,且操作步数远低于人类平均水平。
知名AI博主Mark Kretschmann指出,赋予Agent“再看一眼”的能力带来了显著差异。
此前,开发者需编写数千行代码构建世界模拟器以应对ARC-AGI-3挑战。何恺明团队认为,大模型的推理能力已足够,瓶颈在于视觉输入和记忆保留。
ARC-AGI-3由Keras之父François Chollet及ARC Prize基金会发布,旨在测试AGI水平。测试包含无说明的交互式像素游戏,要求AI在无预先知识的情况下摸索规则,且步数不得多于人类玩家方可得满分。
官方测试向大模型提供的是64×64的数字表格,而非直观图像。这种将视觉信息转化为纯数字坐标的方式,极大增加了模型的理解难度。
左图为官方提供的数字表输入,右图为VISTA提供的图像输入
VISTA团队将输入形式从数字表改为图像。仅此一项改动,GPT-5.6 Sol的得分便从13.33分提升至47.32分。同时,图像处理比数字表格更节省算力:单帧图像仅需308个Token,而同等信息的数字表格需约4000个Token。
在一局游戏中,文本版消耗7190万Token,图片版仅消耗3070万Token,且后者得分更高。这表明,优化视觉输入即可带来34分的显著提升。
输入形式改为图片后,GPT-5.6 Sol通关游戏数量从1个增至9个
除了视觉输入,多模态模型常面临上下文限制导致的历史画面丢失问题。VISTA引入了无损视觉记忆“相册”,保存每一帧画面。模型可随时调用inspect功能回顾、对比或放大查看细节,并通过read_pixels获取精确颜色信息。
关键在于,翻阅相册不计入游戏步数,仅实际游戏操作计步。这种“显式注意力”机制允许模型自主决定关注点。此外,模型还维护GUIDE.md记录规则,WORKING.md作为草稿纸。
VISTA工作流程:观察画面、分析规则、查阅相册、执行操作
在BP35游戏第3关中,模型通过回放前后帧动画,理解了橙色方块与X的转换机制,并利用该机制搭建屏障。该关卡人类平均需44步,模型仅用34步。
模型通过逐帧比对理解游戏机制
在《吃豆人》等游戏中,模型通过回溯开局帧记忆迷宫布局,有效规划路径。
实验显示,单纯增加上下文窗口(从200K至780K)或提高图片分辨率(从8倍至16倍)并未提升成绩,反而因Token占用过多导致性能下降。VISTA坚持极简设计,无需新训练模型,每个游戏仅使用四句通用提示词。
增加上下文和图片分辨率并未带来分数提升
VISTA使用的通用提示词
此前高分方案如Tycho和Schema需为每个游戏编写大量代码构建模拟器。例如,跳棋游戏LF52需4000行Python代码。而VISTA模型仅用三句自然语言笔记即可掌握相同规则。
左图为代码实现(约4000行),右图为VISTA的自然语言笔记(3句)
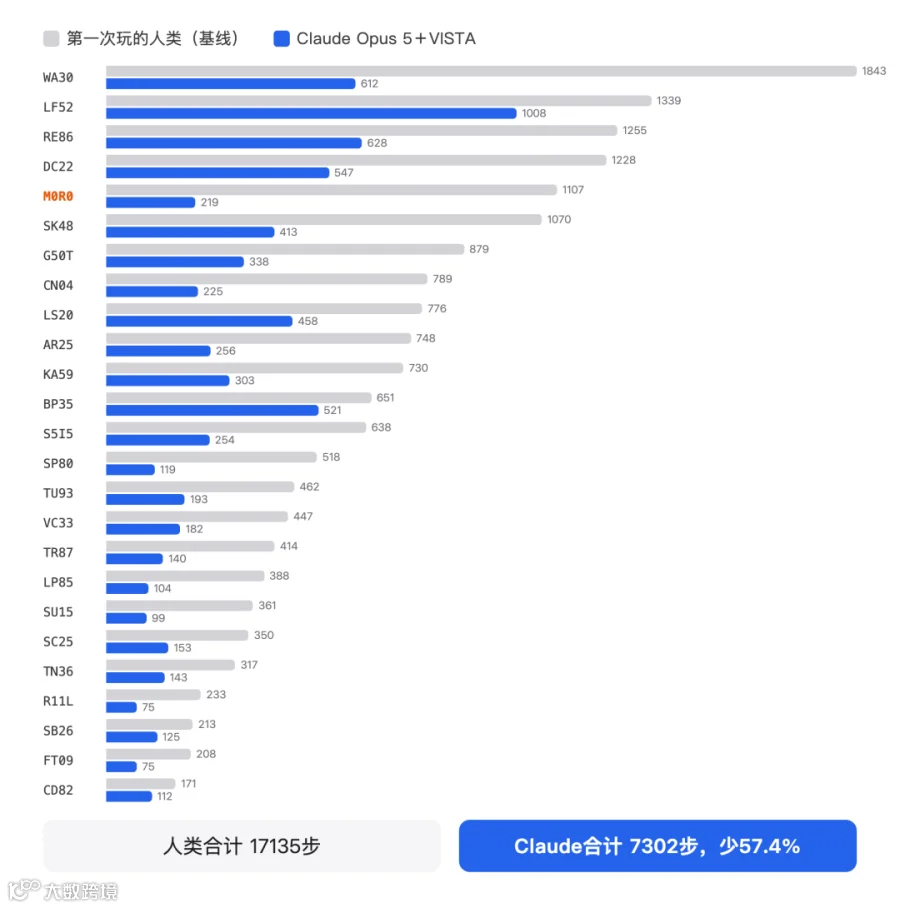
VISTA是首个不依赖代码编程即在ARC-AGI-3上取得满分或近满分的系统。Claude Opus 5打通全部183关,总分100分,总步数仅为人类的43%。GPT-5.6 Sol亦全部通关,得分99分。
该系统具有高度泛化性。在3D透视画面中得分84.12分;在34个网页游戏(含马里奥、2048等)中成功率63.3%,超越人类新手(55.3%)。即使应用于静态看图题,也能通过放大细节提升准确率。对于官方得分仅1.89分的320B开源模型,套用VISTA后得分跃升至66.93分。
ARC Prize官方记分卡显示全关卡满分
Claude(蓝条)步数显著少于人类(灰条)
何恺明团队持续深耕视觉路线
主流ARC解法依赖文本推理,但何恺明团队坚持认为ARC本质是视觉问题。一年内发布的三篇论文均围绕此展开:
1. VARC:使用1800万参数小型视觉模型,纯看图达到人类平均水平。
2. NAT-ARC:通过ImageNet预训练增强抽象推理能力。
3. VISTA:无需训练新模型,直接为前沿大模型配备视觉记忆机制。
何恺明团队三篇ARC论文均强调视觉重要性
系列论文主要作者包括何恺明博士生胡珂雅(上海交大ACM班毕业),以及MIT博士生Qiushi Han和Linlu Qiu,MIT副教授Cathy Wu亦参与合作。
VISTA的成功挑战了行业默认的大模型扩容路线,证明外部辅助机制(视觉输入与记忆)对提升智能表现至关重要。ARC Prize联合创始人Mike Knoop认为,未来更多“学习”将发生在模型权重之外。
通往AGI的关键,在于让模型更清晰地感知和记忆世界。
参考资料:
https://x.com/mark_k/status/2106377357078450620
编辑:摩西